Tag 11: Monitoring
Ziel: rancher-monitoring auf werk installieren, Prometheus die Metriken von notes abholen lassen und einen Alarm auslösen, der meldet, wenn die api ihre Datenbank verliert. · Dauer: ca. 75 min · Voraussetzung: Tag 10
Briefing
- rancher-monitoring ist Ranchers Paket aus Prometheus, Alertmanager, Grafana, node-exporter und kube-state-metrics, gesteuert vom Prometheus-Operator.
- Was Prometheus abholt, beschreibst du mit einem ServiceMonitor, Alarme mit einer PrometheusRule. Beides sind CRDs im Namespace der Anwendung.
- Die notes-api liefert unter
/metricseigene Werte, darunternotes_db_up. - Monitoring kostet Speicher. Für die kleinen Labor-Nodes bekommt Prometheus weniger Speicher und einen halben Tag Verlauf.
 Namespace notes                          Namespace cattle-monitoring-system
 ┌───────────────────────────┐            ┌──────────────────────────────────┐
 │ api  /metrics  ◄──────────┼── 30 s ────┤ Prometheus ── Regel ──► Alertmgr  │
 │ ServiceMonitor api        │            │      ▲                            │
 │ PrometheusRule notes      │            │      └──── Grafana (Dashboards)   │
 │ NetworkPolicy: Freigabe   │            └──────────────────────────────────┘
 └───────────────────────────┘
Drill 1: rancher-monitoring
Wie Longhorn kommt Monitoring aus rancher-charts, wieder
zwei Charts. Die Werte verkleinern Prometheus, Alertmanager und
Grafana:
# tag11/monitoring-values.yaml – Stand Ende Tag 11: Monitoring für kleine Labor-Nodes
prometheus:
  prometheusSpec:
    retention: 12h                 # Labor: halber Tag Verlauf genügt
    resources:
      requests: {cpu: 200m, memory: 400Mi}
      limits: {memory: 1200Mi}
alertmanager:
  alertmanagerSpec:
    resources:
      requests: {cpu: 20m, memory: 32Mi}
      limits: {memory: 128Mi}
grafana:
  resources:
    requests: {cpu: 50m, memory: 100Mi}
    limits: {memory: 300Mi}
source ~/rancher-lab/setup/env.sh
mkdir -p "$LAB/tag11" && cd "$LAB/tag11"
cp "$LAB/code/tag11/"* .
export KUBECONFIG="$LAB/kube/rancher.yaml"
ID=$(kubectl -n fleet-default get clusters.provisioning.cattle.io werk \
-o jsonpath='{.status.clusterName}')
H="Authorization: Bearer $(cat "$LAB/rancher-token")"
API="https://rancher.$RANCHER.sslip.io/k8s/clusters/$ID/v1"
API+="/catalog.cattle.io.clusterrepos/rancher-charts"
VER=110.0.2+up80.9.1-rancher.22
V=$(yq -o=json monitoring-values.yaml)
curl -sk -X POST -H "$H" -H 'Content-Type: application/json' "$API?action=install" \
-d "{\"charts\":[
{\"chartName\":\"rancher-monitoring-crd\",\"version\":\"$VER\",
\"releaseName\":\"rancher-monitoring-crd\",\"values\":{}},
{\"chartName\":\"rancher-monitoring\",\"version\":\"$VER\",
\"releaseName\":\"rancher-monitoring\",\"values\":$V}],
\"namespace\":\"cattle-monitoring-system\",\"wait\":true,\"timeout\":\"900s\"}" \
| jq -c '{operationName}'Erwartet (gekürzt, Namen, IPs und Zeiten weichen bei dir ab):
{"operationName":"helm-operation-2wqnv"}Nach knapp fünf Minuten steht alles:
export KUBECONFIG="$LAB/kube/werk.yaml"
kubectl -n cattle-monitoring-system get pods
kubectl top nodes
Erwartet (gekürzt):
NAME                                                     READY   STATUS    …
alertmanager-rancher-monitoring-alertmanager-0           2/2     Running   …
prometheus-rancher-monitoring-prometheus-0               3/3     Running   …
rancher-monitoring-grafana-7f66d76978-z86nj              3/3     Running   …
rancher-monitoring-kube-state-metrics-b48c9d6fb-g8smp    1/1     Running   …
rancher-monitoring-operator-76b74f56bb-hwb7r             1/1     Running   …
rancher-monitoring-prometheus-adapter-6db5df9455-jh2tf   1/1     Running   …
rancher-monitoring-prometheus-node-exporter-867rn        1/1     Running   …
…
NAME    CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY(%)
werk1   2448m        61%      5923Mi          74%
werk2   833m         41%      2026Mi          50%
werk3   857m         42%      1883Mi          47%
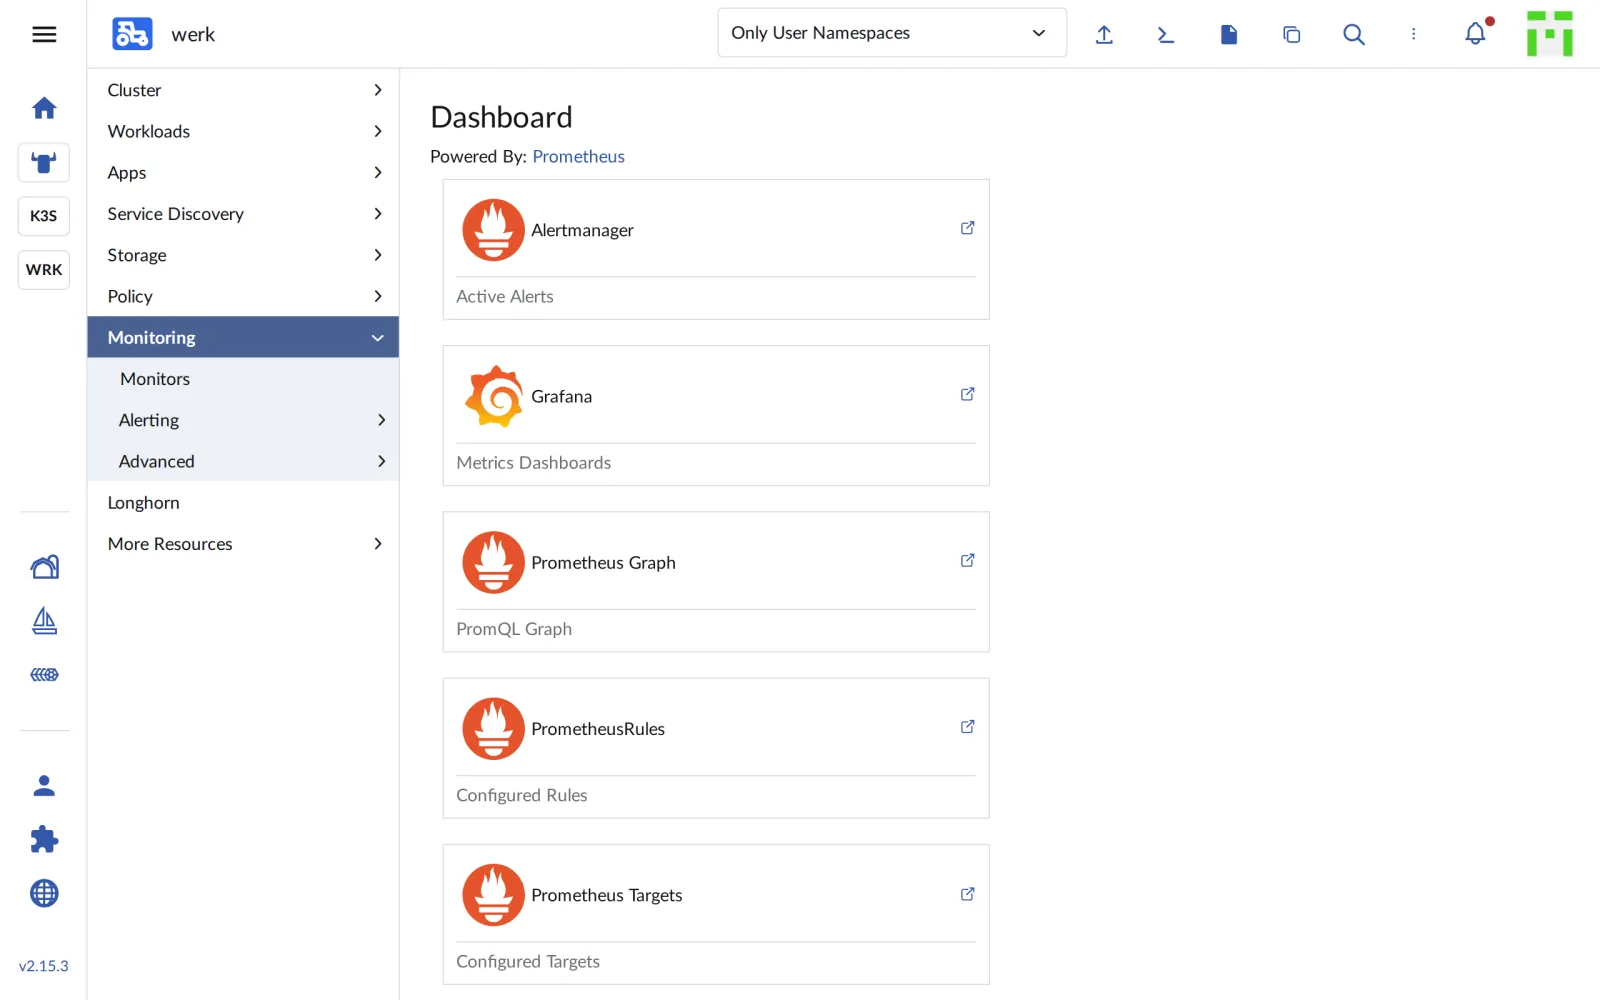
Im Cluster werk gibt es jetzt den Menüpunkt Monitoring mit Links zu allen Werkzeugen:
Fortschritt speichern? Kostenlos registrieren
Drill 2: Was die api misst
kubectl -n notes exec deploy/web -- wget -qO- http://api:8080/metrics \
  | grep -E '^notes_'
kubectl -n notes get svc api -o jsonpath='{.spec.ports}'; echo
Erwartet (gekürzt):
notes_build_info{store="postgres",version="0.2.0"} 1
notes_http_requests_total{code="200",method="GET",path="/healthz"} 217
notes_http_requests_total{code="200",method="GET",path="/notes"} 54
…
notes_created_total 0
notes_db_up 1
[{"name":"http","port":8080,"protocol":"TCP","targetPort":8080}]
notes_db_up ist 1, solange die api Postgres erreicht.
Der Port des Service heißt http; diesen Namen braucht der
ServiceMonitor gleich.
Fortschritt speichern? Kostenlos registrieren
Drill 3: ServiceMonitor, Freigabe, Alarm
# tag11/notes-monitoring.yaml – Stand Ende Tag 11: Prometheus beobachtet die api
# 1. Prometheus darf die api erreichen (Chart-Policies erlauben nur web und worker) …
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: api-from-monitoring
  namespace: notes
spec:
  podSelector:
    matchLabels: {app.kubernetes.io/name: api}
  ingress:
    - from:
        - namespaceSelector:
            matchLabels: {kubernetes.io/metadata.name: cattle-monitoring-system}
      ports:
        - port: 8080
---
# 2. … holt alle 30 s /metrics vom Service api …
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: api
  namespace: notes
spec:
  selector:
    matchLabels: {app.kubernetes.io/name: api}
  endpoints:
    - port: http
      path: /metrics
      interval: 30s
---
# 3. … und schlägt Alarm, wenn die api nicht antwortet oder die DB weg ist.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: notes
  namespace: notes
spec:
  groups:
    - name: notes
      rules:
        - alert: NotesApiDown
          expr: up{namespace="notes", job="api"} == 0
          for: 1m
          labels: {severity: critical}
          annotations:
            summary: "notes-api {{ $labels.pod }} antwortet Prometheus nicht"
        - alert: NotesDbDown
          expr: max(notes_db_up{namespace="notes"}) == 0
          for: 1m
          labels: {severity: critical}
          annotations:
            summary: "notes-api erreicht Postgres nicht"
Ohne Teil 1 käme Prometheus gar nicht an die api: Die NetworkPolicies aus dem Chart lassen nur web, worker und den Test-Pod durch.
kubectl apply -f notes-monitoring.yamlErwartet:
networkpolicy.networking.k8s.io/api-from-monitoring created
servicemonitor.monitoring.coreos.com/api created
prometheusrule.monitoring.coreos.com/notes created
Fortschritt speichern? Kostenlos registrieren
Drill 4: Prometheus fragen
Prometheus hat eine HTTP-API. Im Pod gefragt, ist kein Port-Forward nötig:
prom() {
  kubectl -n cattle-monitoring-system exec prometheus-rancher-monitoring-prometheus-0 \
    -c prometheus -- wget -qO- "http://localhost:9090/api/v1/$1"
}
q() { prom "query?query=$1"; }
q 'up%7Bnamespace%3D%22notes%22%7D' \
  | jq -r '.data.result[] | "\(.metric.job) \(.metric.pod) \(.value[1])"'
q 'sum%20by%20(code)%20(rate(notes_http_requests_total%5B5m%5D))' \
  | jq -r '.data.result[] | "\(.metric.code) \(.value[1])"'
prom 'rules?type=alert' \
  | jq -r '.data.groups[] | select(.name=="notes") | .rules[] | "\(.name) \(.state)"'
Erwartet (gekürzt, frühestens eine Minute nach Drill 3):
api api-5968bfb5cc-5smz4 1
api api-5968bfb5cc-zzpn8 1
200 0.17483122222222222
503 0
500 0
NotesApiDown inactive
NotesDbDown inactive
Die Abfragen sind URL-kodiertes PromQL:
up{namespace="notes"} und die Anfragerate pro Statuscode
der letzten fünf Minuten. Beide api-Pods sind up, die
Alarme ruhen.
Achtung: Wer die Freigabe
api-from-monitoringwieder löscht, erwartetup = 0. Im Test bliebupminutenlang bei 1: Prometheus hält eine offene Keep-Alive-Verbindung, und canal lässt bestehende Verbindungen durch. Erst neue Verbindungen scheitern.
Fortschritt speichern? Kostenlos registrieren
Drill 5: Grafana
Der Link Grafana auf der Monitoring-Seite führt über Ranchers Proxy. Im Test zeigte Grafana 12.3 dort nur „Page not found“. Ein Port-Forward geht direkt zum Service; Grafana lässt Zugriffe ohne Anmeldung zu, weil sonst Rancher die Anmeldung übernimmt:
kubectl -n cattle-monitoring-system port-forward \
  svc/rancher-monitoring-grafana 3000:80 &
curl -s http://localhost:3000/api/health | jq -c '{database, version}'
open "http://localhost:3000/d/85a562078cdf77779eaa1add43ccec1e/x?var-namespace=notes"
Erwartet:
Forwarding from 127.0.0.1:3000 -> 3000
{"database":"ok","version":"12.3.1"}
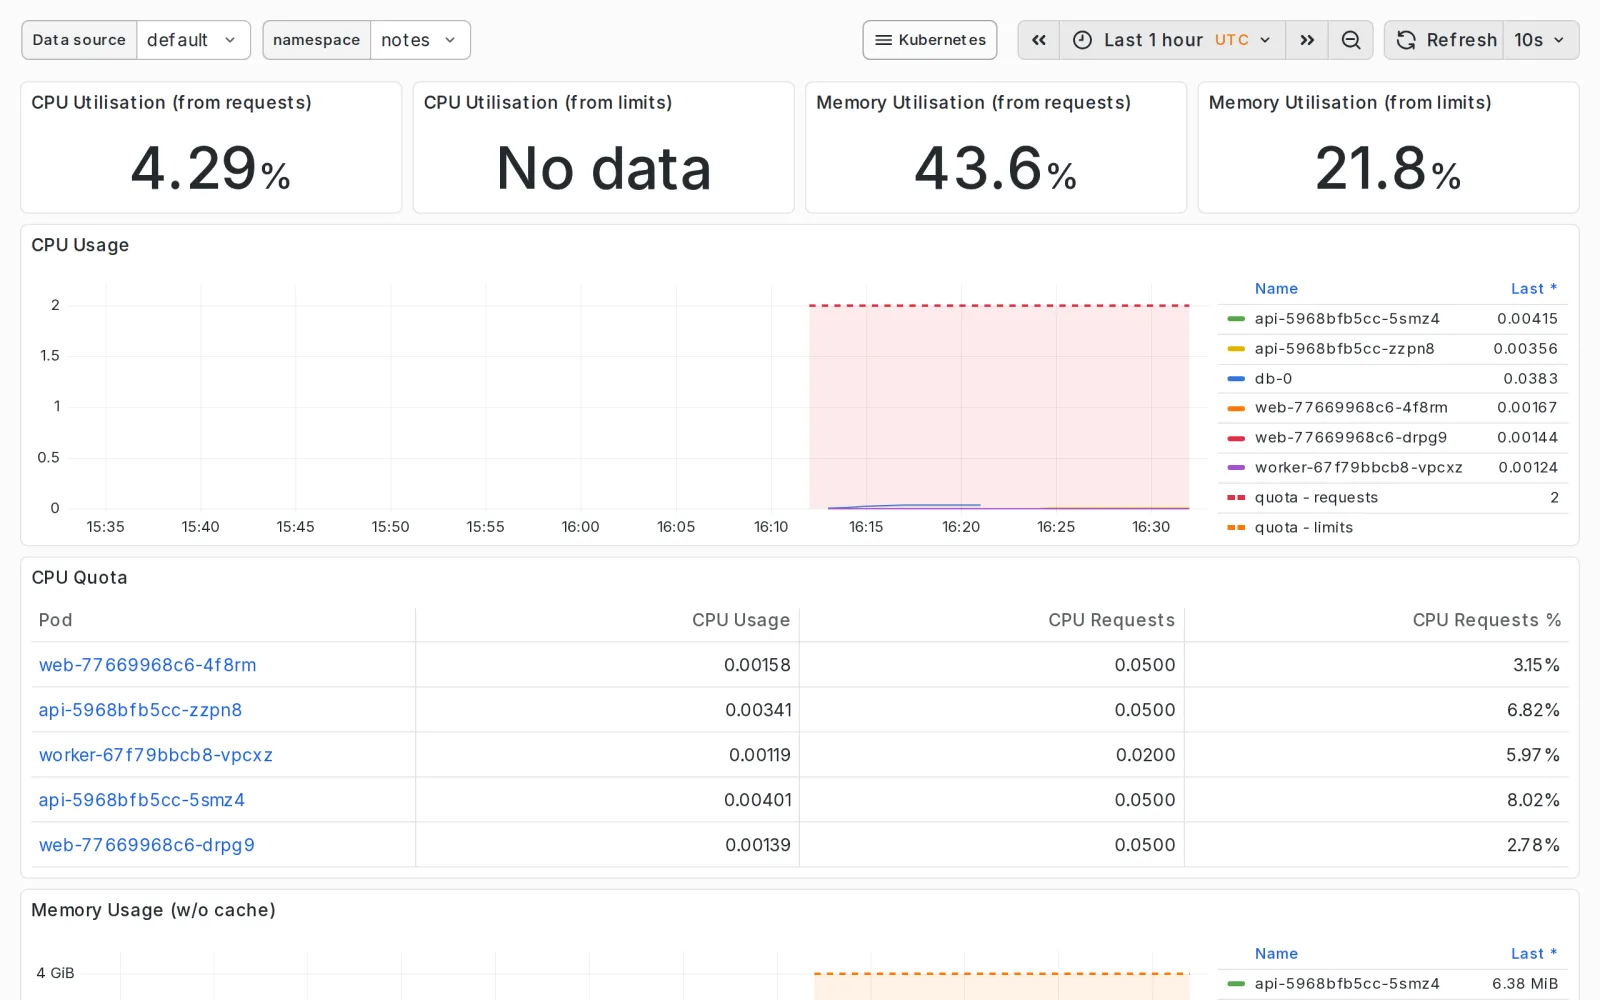
Das Dashboard Kubernetes / Compute Resources / Namespace (Pods) zeigt CPU, Speicher und Quota von notes:
Beende den Tunnel danach mit kill %1.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
kubectl -n notes get servicemonitor,prometheusruleErwartet: ServiceMonitor api und Regel
notes.
NAME                                       AGE
servicemonitor.monitoring.coreos.com/api   21m

NAME                                         AGE
prometheusrule.monitoring.coreos.com/notes   21m
q 'up%7Bnamespace%3D%22notes%22%7D' | jq -r '.data.result[] | .value[1]'Erwartet: zweimal 1, ein Wert pro api-Pod.
1
1
helm -n cattle-monitoring-system listErwartet: beide Charts deployed.
NAME                     NAMESPACE                  …   STATUS     CHART
rancher-monitoring       cattle-monitoring-system   …   deployed   rancher-monitoring…
rancher-monitoring-crd   cattle-monitoring-system   …   deployed   rancher-monitoring…
Challenge
Lass den Alarm NotesDbDown feuern, ohne die api
anzufassen, und sieh ihn dir in Prometheus an. Stell danach den
Normalzustand her. Bedenke, wer an Tag 8 die Drift-Korrektur
eingeschaltet hat.
Hinweis: Fleet setzt Handänderungen zurück, solange das GitRepo nicht angehalten ist.
Lösung
kubectl --kubeconfig "$LAB/kube/rancher.yaml" -n fleet-default \
  patch gitrepos.fleet.cattle.io notes --type merge -p '{"spec":{"paused":true}}'
kubectl -n notes scale statefulset db --replicas=0
prom alerts \
  | jq -r '.data.alerts[] | select(.labels.alertname=="NotesDbDown")
           | "\(.labels.alertname) \(.state) \(.annotations.summary)"'
kubectl --kubeconfig "$LAB/kube/rancher.yaml" -n fleet-default \
  patch gitrepos.fleet.cattle.io notes --type merge -p '{"spec":{"paused":false}}'
kubectl -n notes wait --for=condition=Ready pod/db-0 --timeout=300s
Erwartet (gekürzt, für die Abfrage zwei Minuten nach dem
scale warten):
gitrepo.fleet.cattle.io/notes patched
statefulset.apps/db scaled
NotesDbDown firing notes-api erreicht Postgres nicht
gitrepo.fleet.cattle.io/notes patched
pod/db-0 condition met
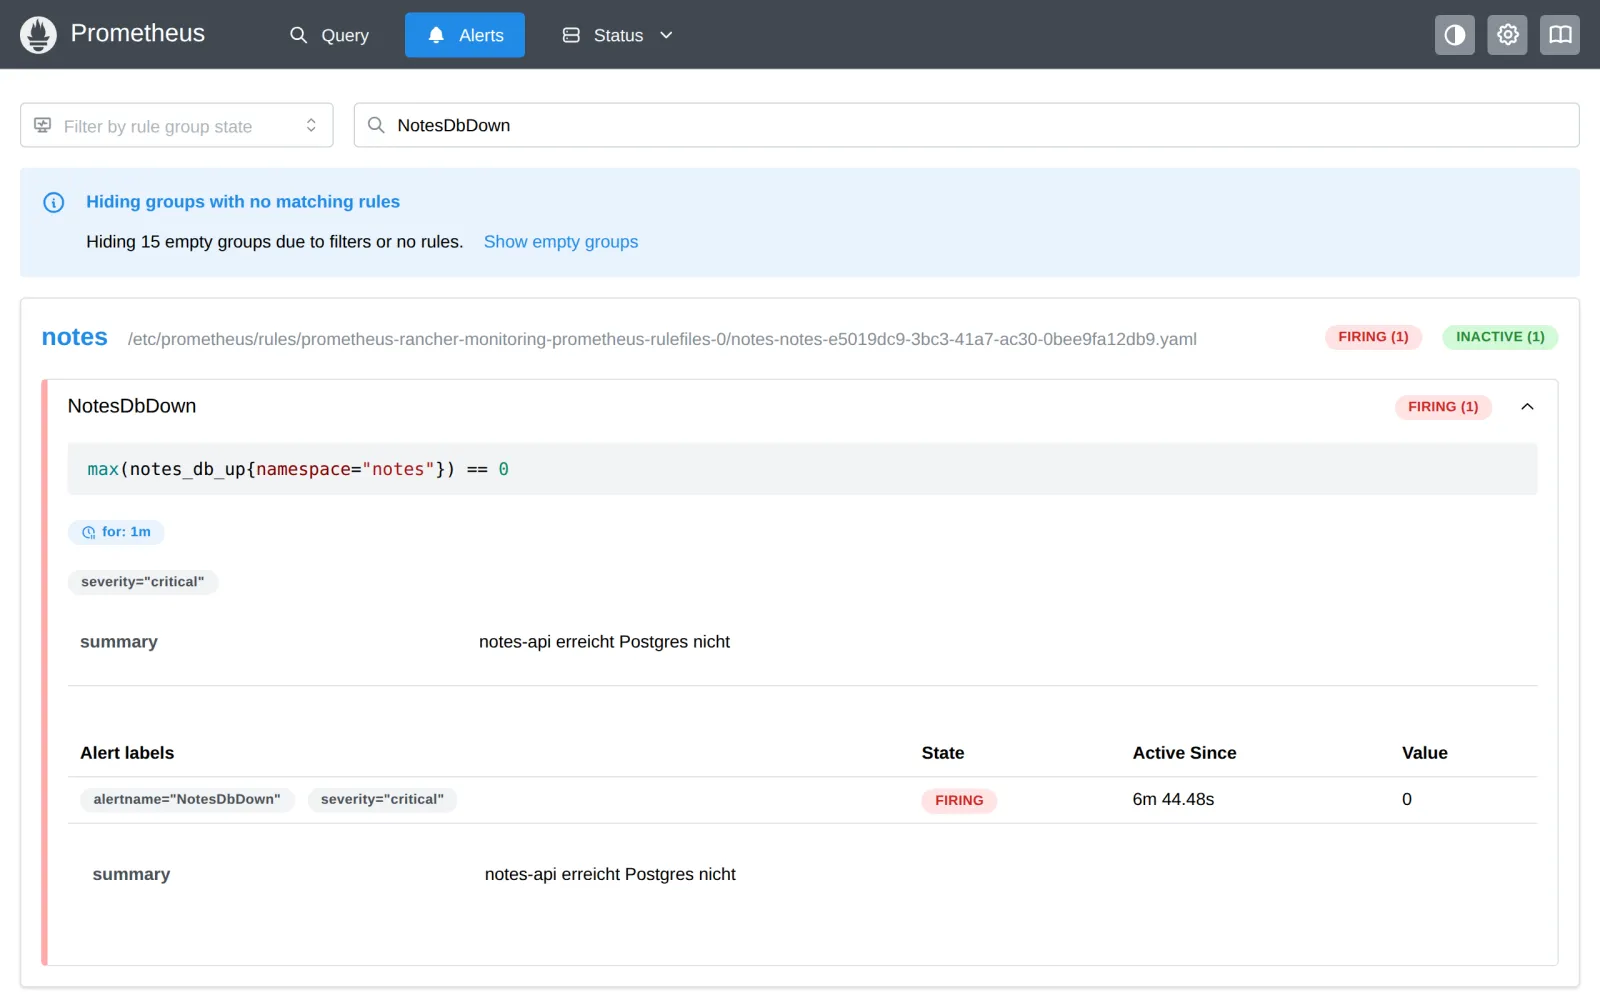
Nach etwa 50 Sekunden ist der Alarm pending, nach der
Minute aus for: 1m firing. In der Oberfläche
von Prometheus (Link PrometheusRules auf der
Monitoring-Seite) sieht das so aus:
Kaum läuft Fleet weiter, stellt die Drift-Korrektur die Datenbank wieder her, und eine Minute später ist der Alarm verschwunden. Ohne Pause hätte Fleet den Test sabotiert.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Benachrichtigungen: Alertmanager schickt Alarme an
E-Mail, Slack, Teams oder PagerDuty. In Rancher konfigurierst du
Empfänger und Routen als
AlertmanagerConfig. - Langzeit: Prometheus im Cluster hält nur Tage. Thanos, Mimir oder ein Monitoring-Dienst sammeln Metriken vieler Cluster zentral und lange.
- Logs: rancher-logging (Fluent Bit, Fluentd) schickt Container-Logs nach Loki, Elasticsearch oder Splunk. Metriken sagen, dass etwas klemmt, Logs sagen, warum.
- Ressourcen: Monitoring wächst mit Clustergröße und Zahl der Metriken. Speicher und Aufbewahrung gehören in die Planung, nicht in den Zufall.
- GitOps: ServiceMonitor, Regeln und Freigabe gehören ins Repository von notes und kommen per Fleet mit, so wie das Chart selbst.