Tag 4: Beobachten
Ziel: Du liest Erfolgsquote, Durchsatz und Latenz jedes Dienstes ab, siehst einzelne Requests live und hast die Linkerd-Metriken in Prometheus und Grafana. · Dauer: ca. 75 min · Voraussetzung: Tag 3
Briefing
- Jeder Proxy misst die Golden Metrics: Erfolgsquote, Requests pro Sekunde, Latenz. Er liefert sie auf seinem Admin-Port 4191 im Prometheus-Format.
- linkerd-viz ist die Erweiterung, die daraus
stat,top,tap,edgesund ein Dashboard macht.tapundtopfragen die Proxys live, alles andere fragt Prometheus. - viz bringt standardmäßig ein eigenes Prometheus mit – ohne Persistenz, nur für Tests. Du nutzt stattdessen kube-prometheus-stack, das du ohnehin für den Cluster brauchst.
 Proxys :4191 ──scrape (PodMonitor)──> Prometheus (monitoring) <── Grafana
                                            ^
 linkerd viz stat/edges ──> metrics-api ────┘
 linkerd viz tap/top    ──> tap ──────────> Proxys (live)
Drill 1: Prometheus und Grafana
mkdir -p ~/linkerd/tag04 && cd ~/linkerd/tag04
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update prometheus-community
cat > kps-values.yaml <<'EOF'
alertmanager:
  enabled: false
defaultRules:
  create: false
grafana:
  adminPassword: lab-grafana-123
kubeControllerManager:
  enabled: false
kubeEtcd:
  enabled: false
kubeProxy:
  enabled: false
kubeScheduler:
  enabled: false
nodeExporter:
  enabled: false
prometheus:
  prometheusSpec:
    podMonitorSelectorNilUsesHelmValues: false
    resources:
      limits:
        memory: 1Gi
      requests:
        cpu: 100m
        memory: 256Mi
    retention: 12h
EOF
helm install kps prometheus-community/kube-prometheus-stack --version 93.4.1 \
  -n monitoring --create-namespace -f kps-values.yaml
kubectl -n monitoring rollout status deploy/kps-grafana --timeout=300s
helm -n monitoring list
kubectl -n monitoring get pods
Erwartet (gekürzt, kann je nach Version abweichen):
NAME  NAMESPACE   REVISION  ...  STATUS    CHART                         APP VERSION
kps   monitoring  1         ...  deployed  kube-prometheus-stack-93.4.1  v0.95.2
NAME                                                  READY   STATUS    RESTARTS   AGE
kps-grafana-6b448f76b6-rlcz4                          3/3     Running   0          2m
kps-kube-prometheus-stack-operator-597c48dc56-fxlpr   1/1     Running   0          2m
kps-kube-state-metrics-dc46747f8-tgb67                1/1     Running   0          2m
prometheus-kps-kube-prometheus-stack-prometheus-0     2/2     Running   0          2m
Die Werte sind für ein kleines Labor zurechtgestutzt: kein
Alertmanager, kein node-exporter, 12 Stunden Aufbewahrung. Wichtig ist
podMonitorSelectorNilUsesHelmValues: false. Ohne diese
Zeile beachtet Prometheus nur PodMonitors mit dem Label
release: kps – deiner für Linkerd würde ignoriert.
Tipp: Läuft kube-prometheus-stack bei dir schon, installierst du nichts neu. Prüfe nur mit
kubectl get prometheus -A -o yaml | grep -A2 podMonitorSelector, ob der Selektor leer ({}) ist – sonst bekommt dein PodMonitor in Drill 3 das passende Label.
Fortschritt speichern? Kostenlos registrieren
Drill 2: linkerd-viz installieren
Ohne eigenes Prometheus verweigert sich die CLI, bis du ihr eines nennst:
linkerd viz install --set prometheus.enabled=false > /dev/nullErwartet (gekürzt):
Error: execution error at (linkerd-viz/templates/metrics-api.yaml:92:11): Please
enable `linkerd-prometheus` or provide `prometheusUrl` for the viz extension to
function properly
Also mit Adresse – und gleich mit Grafana, damit das Dashboard dorthin verlinkt:
P=http://kps-kube-prometheus-stack-prometheus.monitoring.svc.cluster.local:9090
linkerd viz install --set prometheus.enabled=false --set prometheusUrl=$P \
  --set grafana.url=kps-grafana.monitoring.svc.cluster.local > viz.yaml
grep -c '^kind: CustomResourceDefinition' viz.yaml
kubectl apply -f viz.yaml
kubectl -n linkerd-viz rollout status deploy --timeout=300s
linkerd viz check
Erwartet (gekürzt):
0
namespace/linkerd-viz created
...
deployment "metrics-api" successfully rolled out
deployment "tap" successfully rolled out
deployment "tap-injector" successfully rolled out
deployment "web" successfully rolled out
...
√ viz extension proxies are healthy
√ viz extension self-check

Status check results are √
viz hat keine eigenen CRDs, nutzt aber die Policy-CRDs aus Tag 1
(Server, AuthorizationPolicy). Darum kommt es
immer nach der Control Plane, und
linkerd viz install setzt voraus, dass diese läuft.
Warum kein viz-Prometheus? Ein zweites Prometheus kostet auf den
kleinen Workern mehrere hundert MiB, hat keine Persistenz und wäre eine
zweite Wahrheit neben dem Monitoring, das du für Alarme ohnehin
betreibst. Die Linkerd-Doku rät für Produktion genau dazu („Bringing
your own Prometheus“). Der Preis: viz hängt jetzt an
monitoring.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Die Proxys scrapen
linkerd viz stat -n notes deployErwartet:
NAME        MESHED   SUCCESS   RPS   LATENCY_P50   LATENCY_P95   LATENCY_P99   TCP_CONN
helper         2/2         -     -             -             -             -          -
last           1/1         -     -             -             -             -          -
notes-api      2/2         -     -             -             -             -          -
web            2/2         -     -             -             -             -          -
Leer – Prometheus weiß noch nichts von den Proxys. Der PodMonitor
unten entspricht dem, den das Helm-Chart von Linkerd mit
podMonitor.enabled=true anlegt. Die Relabelings machen aus
Pod-Labels wie linkerd.io/proxy-deployment die Labels
deployment, namespace und pod,
nach denen viz fragt:
cat > podmonitor-proxy.yaml <<'EOF'
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata: {name: linkerd-proxy, namespace: monitoring}
spec:
  namespaceSelector: {any: true}
  selector: {}
  podMetricsEndpoints:
  - interval: 10s
    scrapeTimeout: 10s
    relabelings:
    - sourceLabels: [__meta_kubernetes_pod_container_name,
        __meta_kubernetes_pod_container_port_name,
        __meta_kubernetes_pod_label_linkerd_io_control_plane_ns]
      action: keep
      regex: ^linkerd-proxy;linkerd-admin;linkerd$
    - sourceLabels: [__meta_kubernetes_namespace]
      targetLabel: namespace
    - sourceLabels: [__meta_kubernetes_pod_name]
      targetLabel: pod
    - sourceLabels: [__meta_kubernetes_pod_label_linkerd_io_proxy_job]
      targetLabel: k8s_job
    - action: labeldrop
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_job
    - action: labelmap
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
    - action: labeldrop
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
    - action: labelmap
      regex: __meta_kubernetes_pod_label_linkerd_io_(.+)
    - action: labelmap
      regex: __meta_kubernetes_pod_label_(.+)
      replacement: __tmp_pod_label_$1
    - action: labelmap
      regex: __tmp_pod_label_linkerd_io_(.+)
      replacement: __tmp_pod_label_$1
    - action: labeldrop
      regex: __tmp_pod_label_linkerd_io_(.+)
    - action: labelmap
      regex: __tmp_pod_label_(.+)
EOF
kubectl apply -f podmonitor-proxy.yaml
sleep 90
linkerd viz stat -n notes deploy
Erwartet (gekürzt, Zahlen schwanken):
NAME        MESHED   SUCCESS      RPS   LATENCY_P50   LATENCY_P95   LATENCY_P99
helper         2/2    85.19%   1.4rps           1ms           5ms           9ms
last           1/1   100.00%   0.2rps           1ms           9ms          10ms
notes-api      2/2   100.00%   2.0rps           4ms          24ms          29ms
web            2/2    91.47%   2.1rps          10ms          37ms          85ms
Achtung: Der Weg über
linkerd upgrade --set podMonitor.enabled=truelegt die PodMonitors auch an. Mit der CLI erzeugtupgradeaber jedes Mal neue Webhook-Zertifikate und startet so die Control Plane neu – prüf das mitkubectl diff, bevor du es anwendest.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Golden Metrics gegen die Baseline
An Tag 0 lag /flaky bei rund 70 Prozent.
stat zeigt für helper aber 85 Prozent. Wer
zählt da mit?
linkerd viz stat -n notes deploy/helper --from deploy/web
linkerd viz stat -n notes po -l app=helper
Erwartet (Zahlen schwanken):
NAME     MESHED   SUCCESS      RPS   LATENCY_P50   LATENCY_P95   LATENCY_P99   TCP_CONN
helper      2/2    70.45%   0.7rps           4ms           9ms          10ms          2
NAME                       STATUS   MESHED   SUCCESS      RPS   LATENCY_P50   ...
helper-76b4db44b6-2xlc5   Running      1/1    85.96%   0.9rps           1ms   ...
helper-76b4db44b6-g7g5s   Running      1/1    85.37%   0.7rps           1ms   ...
Mit --from deploy/web zählt nur der echte Verkehr: 70
Prozent, genau die Baseline. Ohne Filter stecken die Readiness-Probes
(/status/200, immer erfolgreich) mit drin. Bei
web sind es 91 Prozent: zwei von drei Pfaden des
Lastgenerators gelingen immer. Und last, den niemand
aufruft? Seine 0,2 rps landen auf dem Admin-Port 4191 des Proxys:
Kubelet-Probes für den Proxy selbst und Prometheus-Scrapes.
tap zeigt sie nicht,
linkerd viz authz -n notes deploy/last listet sie.
stat rechnet über ein Fenster von einer Minute. Direkt
nach einer Änderung siehst du also einen Mischwert – warte immer eine
Minute, bevor du misst.
Fortschritt speichern? Kostenlos registrieren
Drill 5: tap und top
linkerd viz tap -n notes deploy/helper --path /unstableErwartet (gekürzt):
Error: no pods to tap for type="deployment" name="helper"
2 pods found with tap not enabled:
        * helper-76b4db44b6-g7g5s
        * helper-76b4db44b6-2xlc5
restart these pods to enable tap and make them valid tap targets
tap braucht eine Freigabe im Proxy, die der
tap-injector von viz beim Anlegen des Pods setzt. Pods von
vor der viz-Installation haben sie nicht:
kubectl -n notes rollout restart deploy
kubectl -n notes rollout restart statefulset
kubectl -n notes rollout status deploy/helper --timeout=180s
kubectl -n notes rollout status statefulset/postgres --timeout=180s
kubectl -n notes get pod -l app=web \
  -o jsonpath='{.items[0].metadata.annotations}' | tr ',' '\n' | grep tap
Erwartet:
"viz.linkerd.io/tap-enabled":"true"}Jetzt live, mit Strg+C beenden:
linkerd viz tap -n notes deploy/helper --path /unstableErwartet (gekürzt):
req id=0:0 proxy=in  src=10.0.2.151:38904 dst=10.0.1.174:8080 tls=true :method=GET ...
rsp id=0:0 proxy=in  src=10.0.2.151:38904 dst=10.0.1.174:8080 tls=true :status=200 ...
end id=0:0 proxy=in  src=10.0.2.151:38904 dst=10.0.1.174:8080 tls=true duration=64µs...
req id=0:0 proxy=in  src=10.0.2.151:60846 dst=10.0.2.1:8080 tls=true :method=GET ...
rsp id=0:0 proxy=in  src=10.0.2.151:60846 dst=10.0.2.1:8080 tls=true :status=500 ...
Mit -o json steht jeder Request mit Identität und Policy
da:
linkerd viz tap -n notes deploy/helper --path /unstable -o json | head -40Erwartet (gekürzt):
  "source": {
    "metadata": {
      "client_id": "web.notes.serviceaccount.identity.linkerd.cluster.local",
      "deployment": "web",
...
  "destination": {
    "metadata": {
      "authz_name": "all-unauthenticated",
top fasst tap pro Pfad zusammen, als
Vollbild (beenden mit q):
linkerd viz top -n notes deploy/webErwartet (gekürzt):
Source                 Destination                 Method  Path        Count  Success
last-85679cb995-8tn79  web-7bcd4fd8c6-wq5ds        GET     /api/notes     22  100.00%
web-7bcd4fd8c6-wq5ds   notes-api-694dbcff4c-rjmjd  GET     /notes         17  100.00%
last-85679cb995-8tn79  web-7bcd4fd8c6-wq5ds        GET     /flaky         11   63.64%
web-7bcd4fd8c6-wq5ds   helper-6c56c89878-fzp87     GET     /unstable      10   70.00%
Achtung:
tapzeigt Pfade und Header-Metadaten live. Wertapdarf, regelt die ClusterRolelinkerd-linkerd-viz-tap-admin– vergib sie wie Lesezugriff auf Logs.
Fortschritt speichern? Kostenlos registrieren
Drill 6: edges und routes
linkerd viz edges -n notes deploy
linkerd viz edges -n notes po | grep postgres
linkerd viz routes -n notes deploy/web
Erwartet (gekürzt):
SRC    DST         SRC_NS   DST_NS   SECURED
last   web         notes    notes    √
web    helper      notes    notes    √
web    notes-api   notes    notes    √
notes-api-694dbcff4c-cqc6p   postgres-0   notes    notes    √
notes-api-694dbcff4c-rjmjd   postgres-0   notes    notes    √
ROUTE       SERVICE   SUCCESS   RPS   LATENCY_P50   LATENCY_P95   LATENCY_P99
[DEFAULT]       web         -     -             -             -             -
edges ist der Schnellnachweis aus Tag 3: Jede Kante mit
√ ist mTLS. Postgres fehlt bei deploy, weil es
ein StatefulSet ist – auf Pod-Ebene ist es da. routes
bleibt leer, solange es kein ServiceProfile gibt. HTTPRoutes misst du an
Tag 7 mit linkerd viz stat-outbound.
Fortschritt speichern? Kostenlos registrieren
Drill 7: Das Dashboard
linkerd viz dashboard --show url &
sleep 5
curl -s localhost:50750 | grep -o '<title>.*</title>'
Erwartet:
Linkerd dashboard available at:
http://localhost:50750
Grafana dashboard available at:
http://localhost:50750/grafana
<title>Linkerd</title>
Der Browser sitzt aber auf deinem Laptop.
--address 0.0.0.0 hilft nicht:
kill %1
linkerd viz dashboard --address 0.0.0.0 --show url &
sleep 5
curl -s http://$(hostname -I | awk '{print $1}'):50750/ | head -2
kill %1
Erwartet:
It appears that you are trying to reach this service with a host of '172.16.0.126:5…
This does not match /^(localhost|127\.0\.0\.1|web\.linkerd-viz\.svc\.cluster\.local|...
Das viz-Dashboard nimmt nur localhost als Host an, als
Schutz vor DNS-Rebinding. Nimm einen SSH-Tunnel vom Laptop und starte
das Dashboard auf cp1 ohne --address:
ssh -L 50750:localhost:50750 [email protected] linkerd viz dashboard --show urlDann öffnest du auf dem Laptop http://localhost:50750
und klickst dich in den Namespace notes. Dort siehst du
dieselben Zahlen wie bei stat und einen Graphen der
Kanten.
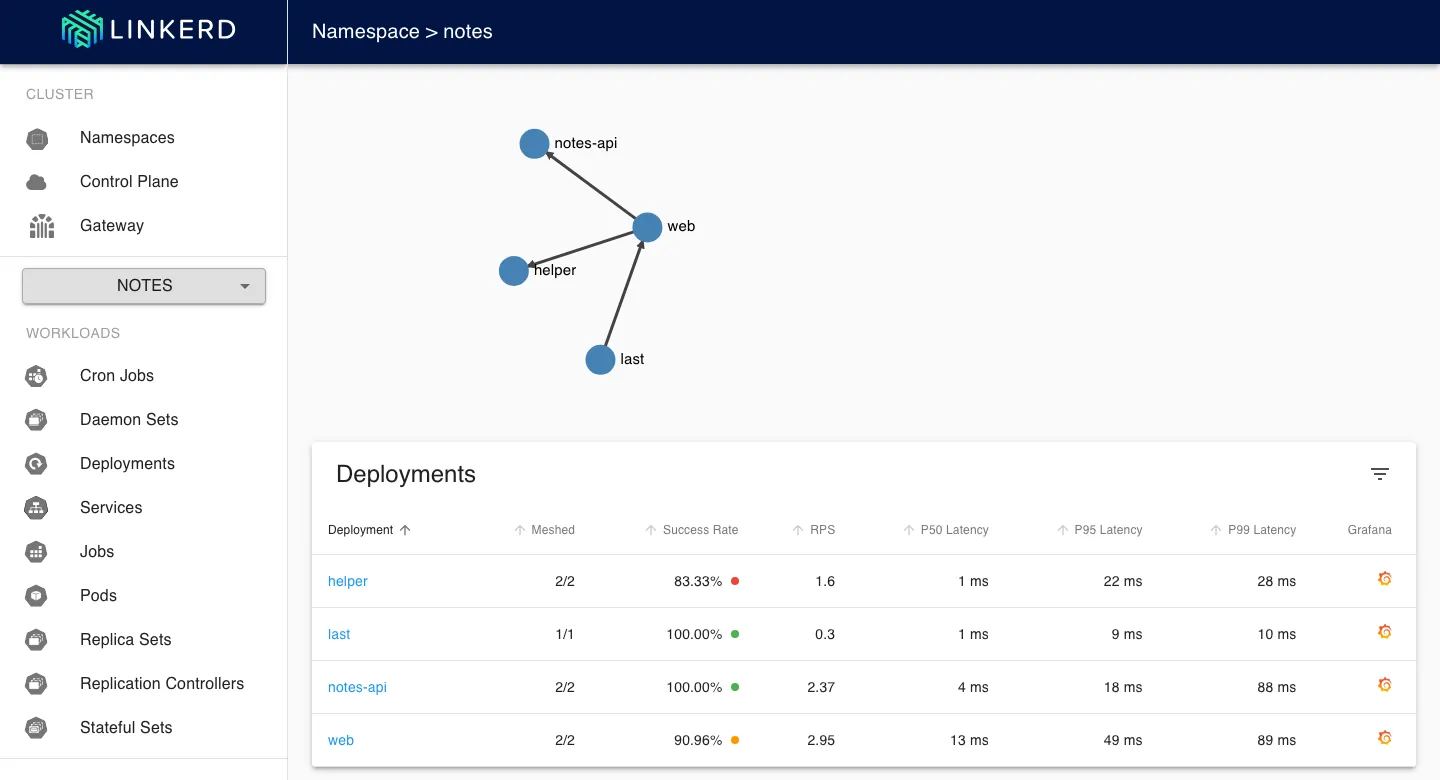
helper und web stehen rot unter 100 Prozent
– das ist der absichtlich wackelige Endpunkt /flaky aus Tag
0, kein Fehler des Mesh.
Fortschritt speichern? Kostenlos registrieren
Drill 8: Grafana und PromQL
Linkerd veröffentlicht seine Grafana-Dashboards auf grafana.com. Die
Grafana aus kube-prometheus-stack lädt jede ConfigMap mit dem Label
grafana_dashboard=1:
curl -fsSL -o linkerd-deployment.json \
  https://grafana.com/api/dashboards/15475/revisions/7/download
kubectl -n monitoring create configmap linkerd-deployment-dashboard \
  --from-file=linkerd-deployment.json
kubectl -n monitoring label configmap linkerd-deployment-dashboard grafana_dashboard=1
kubectl -n monitoring port-forward svc/kps-grafana 3000:80 >/dev/null 2>&1 &
sleep 20
curl -s -u admin:lab-grafana-123 'http://localhost:3000/api/search?query=Linkerd' \
  | jq -r '.[] | .title + " " + .uid'
kill %1
Erwartet:
configmap/linkerd-deployment-dashboard created
configmap/linkerd-deployment-dashboard labeled
Linkerd Deployment linkerd-deployment
Revision 7 ist gepinnt; das Dashboard „Linkerd Deployment“ wählt die
Datenquelle über eine Variable und läuft so ohne Anpassung. Über einen
SSH-Tunnel auf Port 3000 öffnest du es im Browser und wählst
notes und helper:
ssh -L 3000:localhost:3000 [email protected] \
  kubectl -n monitoring port-forward svc/kps-grafana 3000:80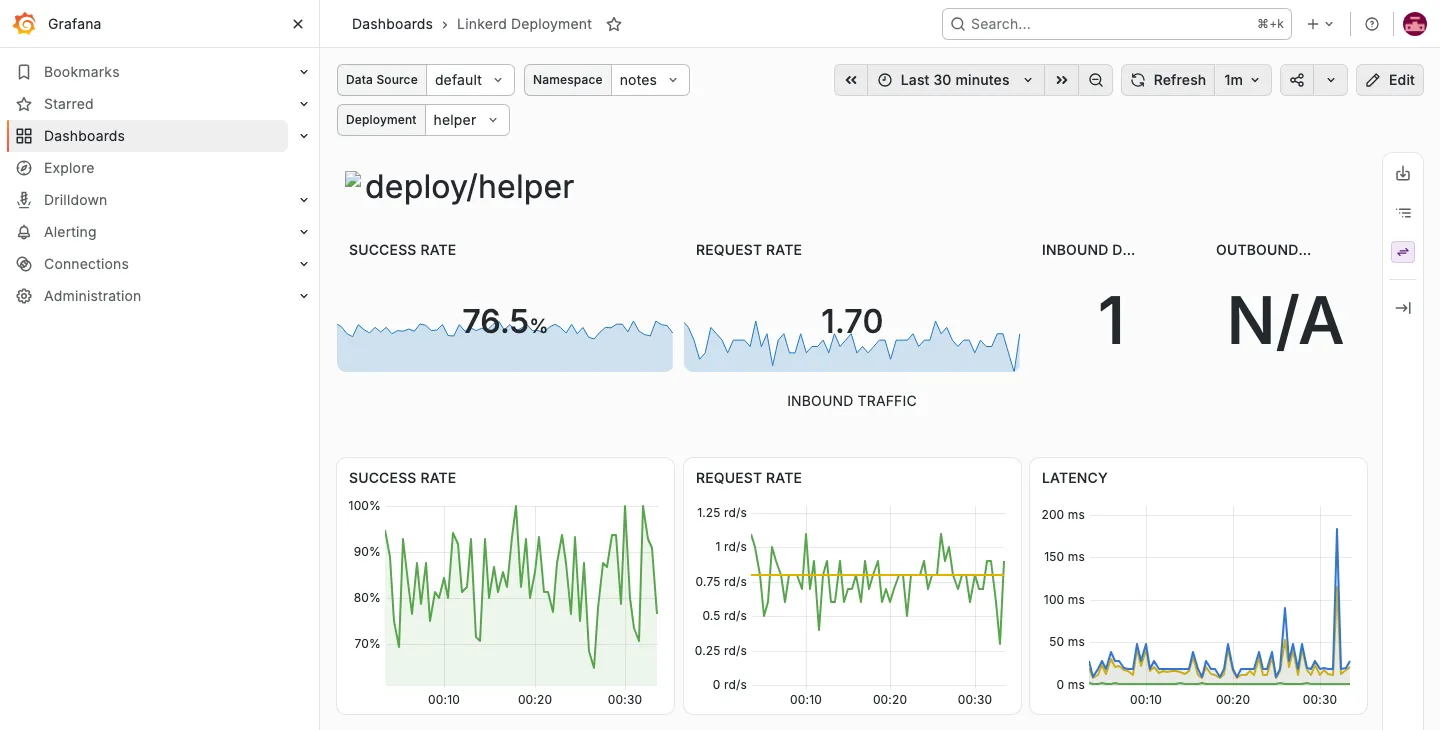
Was das Dashboard rechnet, fragst du auch direkt ab – Erfolgsquote
von web zu seinen Zielen über fünf Minuten:
kubectl -n monitoring port-forward svc/kps-kube-prometheus-stack-prometheus 9090 \
  >/dev/null 2>&1 &
sleep 4
Q='sum by (dst_deployment) (rate(response_total{namespace="notes",
 deployment="web", direction="outbound", classification="success"}[5m]))
 / sum by (dst_deployment) (rate(response_total{namespace="notes",
 deployment="web", direction="outbound"}[5m]))'
curl -s localhost:9090/api/v1/query --data-urlencode "query=$Q" \
  | jq -r '.data.result[] | .metric.dst_deployment + " " + .value[1]'
Erwartet (Zahlen schwanken):
helper 0.7014017344210016
notes-api 0.9180109294522756
helper liegt bei 70 Prozent wie an Tag 0.
notes-api liegt unter 100 Prozent, weil das
Fünf-Minuten-Fenster den Neustart aus Drill 5 enthält: Solange
postgres-0 neu startete, antwortete notes-api
mit 500. Das Mesh macht solche kurzen Ausfälle sichtbar, die im Log des
Lastgenerators leicht untergehen. Wiederhole die Abfrage nach fünf
Minuten: Dann steht dort 1. Den Port-Forward brauchst du
gleich noch.
Dieselbe Abfrage passt auch in Grafana unter Explore (Datenquelle Prometheus, Modus Code). Dort siehst du den Verlauf statt einer Momentaufnahme:
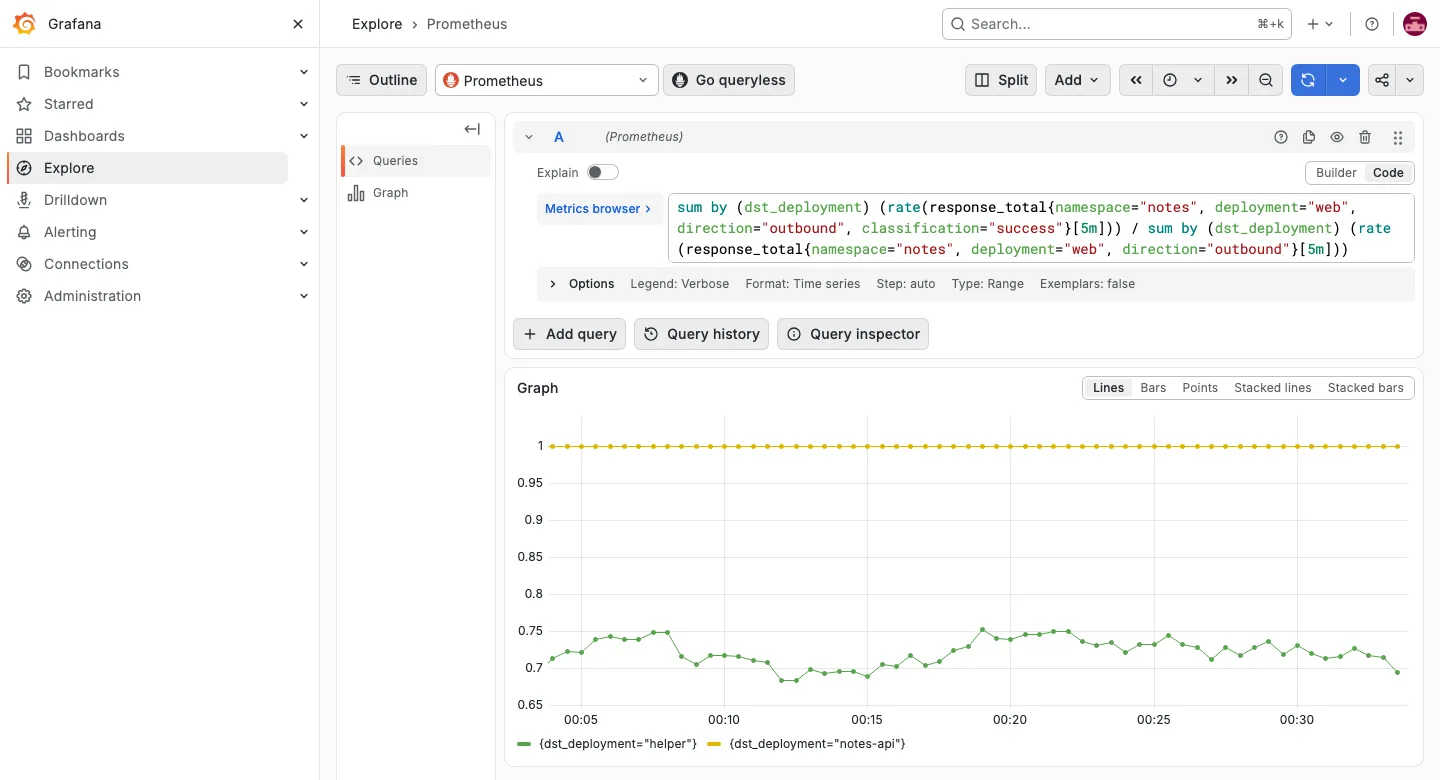
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig die Erfolgsquote von
notes-apiaus Sicht vonweb. Zeitziel: 20 s - Zeig die fünf nächsten Requests, die auf
notes-apimit Status 200 enden – mittapund dem passenden Filter. Zeitziel: 45 s - Zeig alle mTLS-Kanten im Namespace
linkerd-viz. Zeitziel: 15 s - Zähl per PromQL, wie viele Proxys Prometheus pro Namespace scrapt. Zeitziel: 60 s
Lösung
linkerd viz stat -n notes deploy/notes-api --from deploy/web
linkerd viz tap -n notes deploy/notes-api --path /notes | grep -m5 ':status=200'
linkerd viz edges -n linkerd-viz deploy
curl -s localhost:9090/api/v1/query --data-urlencode \
  'query=count(up{job="monitoring/linkerd-proxy"} == 1) by (namespace)' \
  | jq -r '.data.result[] | .metric.namespace + " " + .value[1]'
Erwartet (Auszug für 3 und 4):
SRC   DST         SRC_NS        DST_NS   SECURED
tap   notes-api   linkerd-viz   notes    √
linkerd-viz 4
linkerd 3
notes 8
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
linkerd viz check 2>&1 | tail -1Erwartet:
Status check results are √linkerd viz stat -n notes deploy/helper --from deploy/webErwartet: SUCCESS um 70 Prozent, wie
die Baseline von Tag 0.
kubectl -n monitoring get podmonitor linkerd-proxy
kubectl -n monitoring get configmap -l grafana_dashboard=1 | grep linkerd
Erwartet: beide Ressourcen vorhanden.
Challenge
Schreib eine PromQL-Abfrage, die die Stunden bis zum Ablauf des ältesten Proxy-Zertifikats im Cluster liefert. Das ist dein erster Alarm für Tag 5.
Hinweis: Die Metrik kennst du aus Tag 3, Drill 2.
Lösung
curl -s localhost:9090/api/v1/query --data-urlencode \
  'query=(min(control_identity_cert_expiration_timestamp_seconds) - time()) / 3600' \
  | jq -r '.data.result[0].value[1]'
kill %1
Erwartet (Zahl schwankt):
19.64361391663551Fällt der Wert unter rund sechs Stunden, klemmt die Erneuerung – als
Alarmregel ... < 6 in einer PrometheusRule. Beachte:
Diese Metrik gilt für die Proxy-Zertifikate. Den Issuer
selbst überwacht sie nicht.
Fortschritt speichern? Kostenlos registrieren
Interview-Notiz
- Welche Metriken liefert Linkerd ohne Code-Änderung? Erfolgsquote, RPS und Latenz-Perzentile pro Dienst, Route und Kante, plus TCP-Verbindungen und mTLS-Status.
- Warum weicht die Erfolgsquote eines Dienstes vom Client-Erleben
ab? Inbound-Zahlen enthalten alle Aufrufer, auch Probes;
--fromoder Outbound-Sicht zeigt eine Kante. - Gehört das viz-Prometheus in Produktion? Nein – eigenes Prometheus mit Persistenz, viz nur als Frontend.
Enterprise-Notiz
- Pro Pod im Mesh rechnet die Doku mit einigen MB Prometheus-Speicher – bei tausenden Pods eigene Scrape-Intervalle und Recording Rules einplanen.
- Recording Rules für die Erfolgsquote pro Dienst bilden die Basis für SLOs und Burn-Rate-Alarme.
- Dashboard nie per Port-Forward für alle: hinter Ingress mit
Authentifizierung oder gar nicht.
tapper RBAC begrenzen. - Sobald Policies greifen (Tag 6), muss Prometheus den Admin-Port 4191 weiter erreichen – sonst werden alle Kurven leer.