Tag 13: karma auf Kubernetes
Ziel: Auf k3s läuft kube-prometheus-stack mit zwei Alertmanagern, dazu karma als Deployment mit ConfigMap. Eine eigene
PrometheusRulemeldet einen kaputten Pod, und du räumst die Fehlalarme weg, die k3s erzeugt. · Dauer: ca. 75 min · Voraussetzung: Tag 12
Briefing
- kube-prometheus-stack (kurz kps) ist ein Helm-Chart mit dem Prometheus Operator, Prometheus, Alertmanager, node-exporter, kube-state-metrics und rund 150 fertigen Regeln für Kubernetes.
- Der Operator kennt eigene Objekte:
PrometheusRulefür Regeln,ServiceMonitorfür Scrapes,AlertmanagerConfigfür Routen. Er baut daraus die Konfigurationsdateien. - Für karma gibt es kein gepflegtes offizielles Helm-Chart. Ein Deployment mit ConfigMap ist ohnehin schnell geschrieben.
- Der Alertmanager läuft als StatefulSet. Jeder Pod hat über den
headless Service
alertmanager-operatedeinen festen DNS-Namen. Genau die braucht karma.
 Namespace monitoring                                        Namespace lab
 ├─ prometheus-kps-prometheus-0   :30090 ── Regeln ──────────── kaputt (CrashLoop)
 ├─ alertmanager-kps-alertmanager-0 ┐                          PrometheusRule lab
 ├─ alertmanager-kps-alertmanager-1 ┴── karma :30800
Drill 1: Platz schaffen, k3s, Helm
kps braucht gut 1,5 GB Speicher. Halte das Compose-Projekt an. Bei 4 GB ist das nötig, bei 8 GB schont es die VM. Es bleibt erhalten und kommt in Tag 14 zurück:
cd ~/am-lab
docker compose stop
curl -sfL https://get.k3s.io | INSTALL_K3S_VERSION=v1.37.2+k3s1 \
sh -s - --disable traefik --disable servicelb
mkdir -p ~/.kube
sudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/config
sudo chown "$(id -u):$(id -g)" ~/.kube/config
chmod 600 ~/.kube/config
echo 'export KUBECONFIG=~/.kube/config' >> ~/.bashrc
export KUBECONFIG=~/.kube/config
kubectl get nodesErwartet:
NAME    STATUS   ROLES           AGE   VERSION
karma   Ready    control-plane   18s   v1.37.2+k3s1
--disable traefik --disable servicelb: kein Ingress, kein Load-Balancer. Alles läuft über NodePorts.- Ohne
KUBECONFIGliest daskubectlvon k3s immer/etc/rancher/k3s/k3s.yamlund scheitert an den Rechten.
Helm kommt als einzelne Datei:
curl -fsSLO https://get.helm.sh/helm-v4.3.2-linux-amd64.tar.gz
tar xzf helm-v4.3.2-linux-amd64.tar.gz
mv linux-amd64/helm ~/.local/bin/
rm -r linux-amd64 helm-v4.3.2-linux-amd64.tar.gz
helm version --short
Erwartet:
v4.3.2+g8346aaaFortschritt speichern? Kostenlos registrieren
Drill 2: kube-prometheus-stack
mkdir -p ~/am-lab/k8s
cd ~/am-lab/k8s
cat > kps-values.yaml <<'EOF'
fullnameOverride: kps

grafana:
  enabled: false

prometheus:
  service:
    type: NodePort
    nodePort: 30090
  prometheusSpec:
    externalUrl: http://172.16.0.61:30090
    retention: 2d
    ruleSelectorNilUsesHelmValues: false

alertmanager:
  service:
    type: NodePort
    nodePort: 30093
  alertmanagerSpec:
    replicas: 2
    externalUrl: http://172.16.0.61:30093
EOF
fullnameOverride: kpshält die Namen kurz. Ohne heißt der erste Alertmanager-Podalertmanager-kps-kube-prometheus-stack-alertmanager-0.- Grafana brauchst du hier nicht. Das spart Speicher.
ruleSelectorNilUsesHelmValues: false: Prometheus lädt jedePrometheusRuleim Cluster. Sonst nur solche mit dem Labelrelease: kps.replicas: 2: zwei Alertmanager im Cluster. Gossip richtet der Operator selbst ein.externalUrl: dieselbe Aufgabe wie--web.external-urlin Tag 1.
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm upgrade --install kps prometheus-community/kube-prometheus-stack \
  --version 93.3.0 -n monitoring --create-namespace -f kps-values.yaml --wait
kubectl -n monitoring get pods
Erwartet:
NAME                                     READY   STATUS    RESTARTS   AGE
alertmanager-kps-alertmanager-0          2/2     Running   0          21s
alertmanager-kps-alertmanager-1          2/2     Running   0          21s
kps-kube-state-metrics-dc46747f8-5k8vr   1/1     Running   0          26s
kps-operator-7988b8464d-p9wng            1/1     Running   0          26s
kps-prometheus-node-exporter-xp2n6       1/1     Running   0          26s
prometheus-kps-prometheus-0              2/2     Running   0          19s
Der zweite Container in jedem Alertmanager-Pod ist der
config-reloader. Er lädt die Konfiguration neu, wenn der
Operator sie ändert.
Fortschritt speichern? Kostenlos registrieren
Drill 3: karma als Deployment
Eine Datei mit ConfigMap, Deployment und Service:
cat > karma.yaml <<'EOF'
apiVersion: v1
kind: ConfigMap
metadata:
  name: karma
  namespace: monitoring
data:
  karma.yaml: |
    karma:
      name: k3s
    alertmanager:
      interval: 30s
      servers:
        - name: k3s-0
          cluster: k3s
          uri: http://alertmanager-kps-alertmanager-0.alertmanager-operated:9093
          external_uri: http://172.16.0.61:30093
          proxy: true
          healthcheck:
            filters:
              watchdog:
                - alertname=Watchdog
        - name: k3s-1
          cluster: k3s
          uri: http://alertmanager-kps-alertmanager-1.alertmanager-operated:9093
          external_uri: http://172.16.0.61:30093
          proxy: true
          healthcheck:
            filters:
              watchdog:
                - alertname=Watchdog
    history:
      rewrite:
        - source: 'http://172.16.0.61:30090'
          uri: 'http://kps-prometheus:9090'
    labels:
      strip: [prometheus, endpoint, service]
    ui:
      multiGridLabel: namespace
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: karma
  namespace: monitoring
spec:
  replicas: 1
  selector:
    matchLabels:
      app: karma
  template:
    metadata:
      labels:
        app: karma
    spec:
      containers:
        - name: karma
          image: ghcr.io/prymitive/karma:v0.134
          env:
            - name: CONFIG_FILE
              value: /etc/karma/karma.yaml
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /health
              port: 8080
          resources:
            requests:
              memory: 64Mi
            limits:
              memory: 256Mi
          volumeMounts:
            - name: config
              mountPath: /etc/karma
      volumes:
        - name: config
          configMap:
            name: karma
---
apiVersion: v1
kind: Service
metadata:
  name: karma
  namespace: monitoring
spec:
  type: NodePort
  selector:
    app: karma
  ports:
    - port: 8080
      nodePort: 30800
EOF
kubectl apply -f karma.yaml
kubectl -n monitoring rollout status deploy/karma
kubectl -n monitoring logs deploy/karma | grep -E 'Configured|Upstream version'
Erwartet:
configmap/karma created
deployment.apps/karma created
service/karma created
deployment "karma" successfully rolled out
level=INFO msg="Configured Alertmanager source" name=k3s-0 cluster=k3s uri=http://alertmanager-kps-alertmanager-0.alertmanager-operated:9093 proxy=true readonly=false
level=INFO msg="Configured Alertmanager source" name=k3s-1 cluster=k3s uri=http://alertmanager-kps-alertmanager-1.alertmanager-operated:9093 proxy=true readonly=false
level=INFO msg="Upstream version" version=0.35.0 alertmanager=k3s-0
level=INFO msg="Upstream version" version=0.35.0 alertmanager=k3s-1<pod>.alertmanager-operatedist der DNS-Name eines einzelnen Pods im StatefulSet. Der normale Servicekps-alertmanagerwürde die Anfragen auf beide Pods verteilen, und karma sähe abwechselnd mal den einen, mal den anderen.labels.stripblendet Labels aus, die der Operator an jeden Alarm hängt./healthals Readiness-Probe: karma antwortet erst nach dem ersten Abruf.- karma liest die ConfigMap nur beim Start. Nach einer Änderung:
kubectl -n monitoring rollout restart deploy/karma.
Nach einer halben Minute:
curl -s localhost:30800/metrics | grep '^karma_alertmanager_up'Erwartet:
karma_alertmanager_up{alertmanager="k3s-0"} 1
karma_alertmanager_up{alertmanager="k3s-1"} 1
Beide 1. Der Watchdog von kps ist da, der Healthcheck zufrieden.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Eine eigene Regel
Ein Pod, der nie startet, und eine Regel dafür, beides im Namespace
lab:
cat > lab.yaml <<'EOF'
apiVersion: v1
kind: Namespace
metadata:
  name: lab
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: kaputt
  namespace: lab
spec:
  replicas: 1
  selector:
    matchLabels:
      app: kaputt
  template:
    metadata:
      labels:
        app: kaputt
    spec:
      containers:
        - name: kaputt
          image: busybox:1.37
          command: ["sh", "-c", "echo Konfiguration fehlt; exit 1"]
---
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: lab
  namespace: lab
spec:
  groups:
    - name: lab
      rules:
        - alert: LabPodCrashLoop
          expr: max_over_time(kube_pod_container_status_waiting_reason{namespace="lab", reason="CrashLoopBackOff"}[5m]) >= 1
          for: 1m
          labels:
            severity: warning
            team: notes
          annotations:
            summary: "{{ $labels.pod }} hängt im CrashLoopBackOff"
EOF
kubectl apply -f lab.yamlkube_pod_container_status_waiting_reasonkommt von kube-state-metrics. Der Wert ist 1, solange ein Container mit diesem Grund wartet.max_over_time(…[5m])glättet die Lücken. Zwischen zwei Neustarts wartet der Container kurz mit einem anderen Grund.
Ausprobiert: Mit
… == 1ohnemax_over_timeging der Alarm im Test immer wieder aus und an, und karma zeigte ihn mal, mal nicht. Die erste Fassung mitincrease(…restarts_total[5m]) > 2feuerte nie. Im CrashLoopBackOff startet Kubernetes den Pod irgendwann nur noch alle fünf Minuten neu.
Nach gut zwei Minuten:
curl -s localhost:30090/api/v1/rules \
  | jq -r '.data.groups[] | select(.name=="lab") | .rules[] | "\(.name) \(.state)"'
Erwartet:
LabPodCrashLoop firingFortschritt speichern? Kostenlos registrieren
Drill 5: Gruppen in kps
Öffne http://172.16.0.61:30800. Alle Alarme aus
lab stehen in einer Kachel ohne Titel. Die
Standard-Route von kps gruppiert nur nach namespace:
curl -s localhost:30093/api/v2/status | jq -r .config.original | grep -A2 group_byErwartet:
  group_by:
  - namespace
  continue: false
Und namespace ist zugleich das Label des Rasters. Für
den Titel bleibt nichts übrig. Ergänze in kps-values.yaml
unter alertmanager (gleiche Einrückung wie
alertmanagerSpec):
  config:
    route:
      group_by: [namespace, alertname]
helm upgrade kps prometheus-community/kube-prometheus-stack \
--version 93.3.0 -n monitoring -f kps-values.yaml --waitNach etwa einer Minute hat der config-reloader die neue
Konfiguration geladen:
curl -s localhost:30093/api/v2/status | jq -r .config.original | grep -A3 group_byErwartet:
group_by:
- namespace
- alertname
continue: falseHelm führt die Werte mit denen des Charts zusammen. Receiver,
Watchdog-Route und Inhibit-Regeln von kps bleiben, nur
group_by ist neu.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
kubectl -n monitoring get statefulset alertmanager-kps-alertmanagerErwartet: READY 2/2.
curl -s localhost:30800/metrics | grep -c '^karma_alertmanager_up.* 1$'Erwartet: 2.
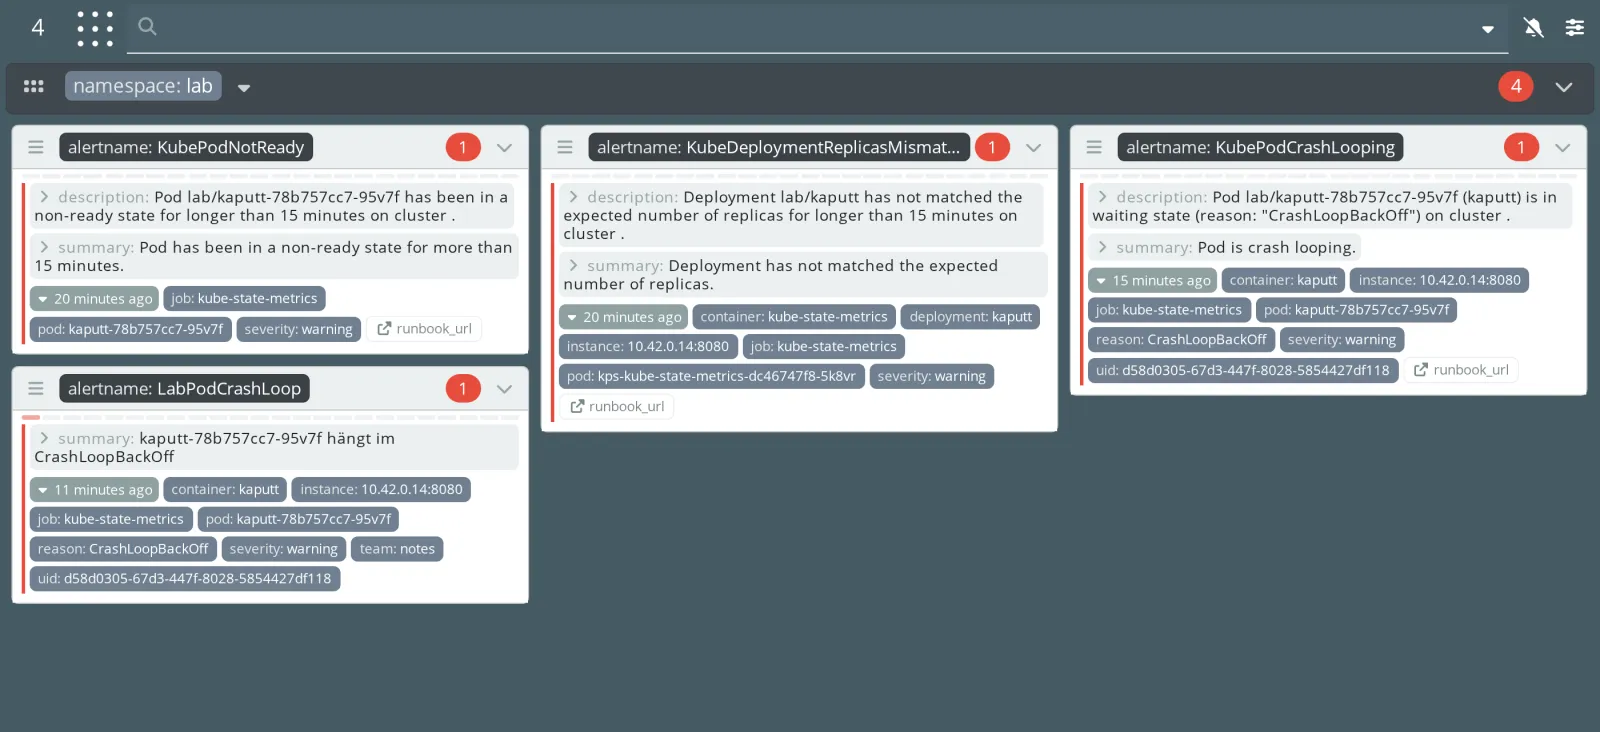
curl -s -G localhost:30800/counters.json --data-urlencode 'q=namespace=lab' | jq .totalErwartet nach etwa 15 Minuten: 4. Neben deiner Regel
melden drei Regeln von kps den kaputten Pod. Sie haben
for: 15m und kommen deshalb später.
Challenge
Außer den Alarmen aus lab zeigt karma
KubeProxyDown, KubeSchedulerDown und
KubeControllerManagerDown, alle critical. Der
Cluster läuft aber. Finde heraus, warum, und räume die Fehlalarme
weg.
Hinweis: k3s startet Scheduler, Controller-Manager
und Proxy nicht als eigene Pods, sondern in einem Prozess. kps sucht sie
als eigene Scrape-Ziele. Für jede dieser Komponenten hat das Chart einen
Schalter enabled.
Lösung
cat >> kps-values.yaml <<'EOF'
kubeProxy:
enabled: false
kubeScheduler:
enabled: false
kubeControllerManager:
enabled: false
kubeEtcd:
enabled: false
EOF
helm upgrade kps prometheus-community/kube-prometheus-stack \
  --version 93.3.0 -n monitoring -f kps-values.yaml --wait
Nach zwei Minuten:
curl -s localhost:30800/counters.json \
  | jq -c '[.counters[] | select(.name=="alertname") | .values[] | .value]'
Erwartet:
["KubeDeploymentReplicasMismatch","KubePodCrashLooping","KubePodNotReady","LabPodCrashLoop"]Nur noch Alarme aus lab. Mit enabled: false
entfernt das Chart Scrape-Ziel und Regeln der Komponente.
kubeEtcd schaltest du gleich mit ab: k3s nutzt mit einem
Knoten SQLite statt etcd.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- karma im Cluster nie per NodePort ohne Schutz veröffentlichen. Ingress mit SSO davor (Tag 11), dazu eine NetworkPolicy, die nur den Ingress-Controller zu karma lässt.
- Für mehrere Cluster läuft karma einmal zentral und liest die Alertmanager aller Cluster. Die Alertmanager brauchen dann einen erreichbaren Endpunkt mit TLS.
group_byim Chart bewusst setzen. Die Standard-Gruppierung nachnamespaceverdichtet stark, in karma sieht man dann zu wenig.- Regeln für die eigene Software als
PrometheusRuleneben das Deployment legen, im selben Git-Repo, mit denselben Reviews.