Tag 12: Historie, Healthchecks und Fehlersuche
Ziel: karma zeigt, wie oft ein Alarm in den letzten 24 Stunden kam, warnt, wenn ein Prometheus schweigt, und wird selbst von Prometheus überwacht. Du prüfst Konfigurationen, bevor sie karma lahmlegen. · Dauer: ca. 50 min · Voraussetzung: Tag 11
Briefing
- Der Alertmanager speichert keine Geschichte. Prometheus schon: Jeder
Alarm hinterlässt die Zeitreihe
ALERTS_FOR_STATE. karma fragt sie für jede Gruppe ab und zeigt 24 Blöcke, einen pro Stunde. Je dunkler, desto öfter kam der Alarm. - Welchen Prometheus karma fragt, steht in jedem Alarm: in
generatorURL. Ist die Adresse von karma aus nicht erreichbar, schreibt rewrite sie um. - Ein Healthcheck ist ein Filter, der immer etwas finden muss, typischerweise den Watchdog. Findet er nichts, ist die Kette Prometheus → Alertmanager kaputt, und karma zeigt einen Fehler.
- karma hat eigene Metriken unter
/metrics. Die wichtigste:karma_alertmanager_up.
Drill 1: Die Historie
Die Historie ist standardmäßig eingeschaltet. Du hast sie schon gesehen: die Reihe kleiner Blöcke oben in jeder Kachel. Graue Blöcke sind ruhige Stunden, farbige Stunden mit Alarmen, je dunkler, desto öfter.
Die Abfrage dahinter kannst du selbst schicken:
cd ~/am-lab
curl -s -u alice:lab-karma-pw-123 -X POST -H 'Content-Type: application/json' \
  -d '{"labels":{"alertname":"NotesApiDown"},"sources":["http://172.16.0.61:9090"]}' \
  localhost:8000/history.json | jq -c '{error, stunden: (.samples|length)}'
Erwartet:
{"error":"","stunden":24}sourcesist die Adresse ausgeneratorURL, also--web.external-urlvon Tag 1.- karma erreicht
172.16.0.61:9090hier nur, weil der Port auf der VM offen ist. In einem echten Netz ist die öffentliche Adresse von Prometheus oft nicht dieselbe wie die interne.
Darum lenkst du karma auf die internen Namen um. Hänge an
karma/karma.yaml an:
cat >> karma/karma.yaml <<'EOF'

history:
  enabled: true
  rewrite:
    - source: 'http://172.16.0.61:9090'
      uri: 'http://prometheus:9090'
    - source: 'http://172.16.0.61:9091'
      uri: 'http://prometheus-dev:9090'
EOF
Bevor du neu startest, prüfst du die Datei mit karma selbst:
docker run --rm -v $PWD/karma:/etc/karma:ro ghcr.io/prymitive/karma:v0.134 \
  --config.file /etc/karma/karma.yaml --check-config 2>&1 | tail -1
Erwartet:
level=INFO msg="Configuration is valid"--check-config liest die Datei, die ACLs und alle Regex
und beendet sich. Ein Tippfehler fällt hier auf, nicht erst, wenn karma
nicht mehr startet.
Um zu sehen, dass die Umleitung greift, stellst du das Log kurz auf
debug. Der Abschnitt log in
karma/karma.yaml bekommt eine Zeile:
log:
  config: true
  level: debug
docker compose restart karma
curl -s -u alice:lab-karma-pw-123 -X POST -H 'Content-Type: application/json' \
-d '{"labels":{"alertname":"NotesApiDown"},"sources":["http://172.16.0.61:9090"]}' \
localhost:8000/history.json > /dev/null
docker compose logs --no-log-prefix --since 30s karma | grep -E 'rewrite|count query'Erwartet (umbrochen):
level=DEBUG msg="Alert history source rewrite" source=http://172.16.0.61:9090
  uri=http://prometheus:9090
level=DEBUG msg="Send alert count query" uri=http://prometheus:9090
  labels="map[alertname:NotesApiDown]"
  query="changes(ALERTS_FOR_STATE{alertname=\"NotesApiDown\"}[1h])" timeout=20s
Die PromQL-Abfrage zählt, wie oft sich ALERTS_FOR_STATE
pro Stunde geändert hat, also wie oft der Alarm neu begann. Ein Alarm,
der seit Stunden durchgehend feuert, hat deshalb nur einen roten Block.
Nimm die Zeile level: debug danach wieder heraus, das
Debug-Log ist sehr gesprächig.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Der Watchdog als Healthcheck
Jeder Upstream bekommt einen Filter, der den Watchdog seiner Umgebung
finden muss. Für die drei Knoten von prod ergänzt du in
karma/karma.yaml unter jedem Server:
      healthcheck:
        filters:
          prometheus-prod:
            - alertname=Watchdog
            - env=prod
Und unter dev:
      healthcheck:
        filters:
          prometheus-dev:
            - alertname=Watchdog
            - env=dev
Der Name (prometheus-prod) erscheint in der
Fehlermeldung. Alle Filter einer Liste müssen gleichzeitig
zutreffen.
docker run --rm -v $PWD/karma:/etc/karma:ro ghcr.io/prymitive/karma:v0.134 \
  --config.file /etc/karma/karma.yaml --check-config 2>&1 | tail -1
docker compose restart karma
curl -s -u alice:lab-karma-pw-123 -G localhost:8000/counters.json \
  --data-urlencode 'q=alertname=Watchdog' | jq .total
Erwartet:
level=INFO msg="Configuration is valid"
0
Der Watchdog ist aus der Ansicht verschwunden. Alarme, die ein
Healthcheck findet, blendet karma aus
(healthcheck.visible: false ist Standard). Sie haben ihre
Aufgabe, anschauen muss sie niemand.
Jetzt fällt der Prometheus von dev aus:
docker compose stop prometheus-devDer Watchdog verschwindet nicht sofort. Prometheus hat ihm beim letzten Senden ein Ablaufdatum gegeben, vier Minuten in der Zukunft:
amtool alert query alertname=Watchdog --alertmanager.url=http://localhost:9096 -o json \
  | jq -r '.[0].endsAt'
Erwartet (vier Minuten nach dem Anhalten):
2026-11-16T20:59:33.799ZDanach, beim nächsten Abruf von karma:
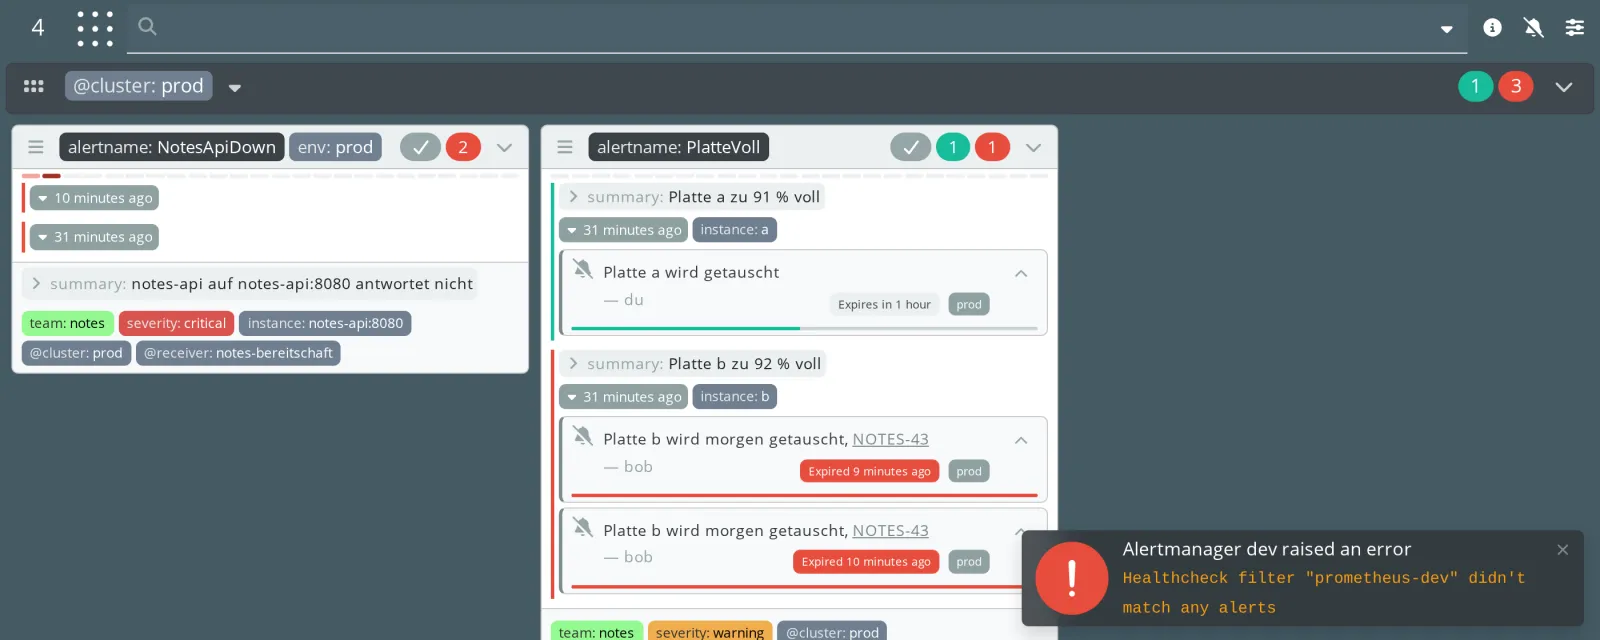
- Unten rechts:
Healthcheck filter "prometheus-dev" didn't match any alerts. - Das Raster von dev ist ganz verschwunden. karma behandelt den Upstream als gestört.
- Oben rechts steht das Info-Symbol, solange ein Fehler besteht.
curl -s -u alice:lab-karma-pw-123 localhost:8000/metrics | grep '^karma_alertmanager_up'Erwartet:
karma_alertmanager_up{alertmanager="dev"} 0
karma_alertmanager_up{alertmanager="prod-1"} 1
karma_alertmanager_up{alertmanager="prod-2"} 1
karma_alertmanager_up{alertmanager="prod-3"} 1
Der Alertmanager von dev läuft, aber für karma ist er 0,
weil sein Watchdog fehlt. Genau das willst du: Ein Alertmanager ohne
Alarme ist kein gesunder Alertmanager.
docker compose start prometheus-devFortschritt speichern? Kostenlos registrieren
Drill 3: Was karma über sich verrät
Alle eigenen Metriken von karma:
curl -s -u alice:lab-karma-pw-123 localhost:8000/metrics | grep '^karma_' \
  | cut -d'{' -f1 | cut -d' ' -f1 | sort -u
Erwartet:
karma_alertmanager_errors_total
karma_alertmanager_up
karma_collect_cycles_total
karma_collected_alerts_count
karma_collected_groups_countkarma_alertmanager_up: 1 oder 0 pro Upstream, inklusive Healthcheck.karma_alertmanager_errors_total: Fehler beim Abruf, getrennt nachalertsundsilences.karma_collect_cycles_total: wächst alle 30 Sekunden. Steht der Wert, hängt karma.
Weitere Hilfen bei der Fehlersuche:
Schalter in log |
Wirkung |
|---|---|
config: true |
ganze Konfiguration beim Start ins Log |
level: debug |
jede Abfrage an Alertmanager und Prometheus |
requests: true |
jede HTTP-Anfrage an karma |
format: json |
ein JSON-Objekt pro Zeile, für Loki und Co. |
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
curl -s -u alice:lab-karma-pw-123 localhost:8000/metrics | grep -c '^karma_alertmanager_up.* 1$'Erwartet: 4, nachdem der Prometheus von dev wieder läuft
und sein Watchdog da ist.
docker compose logs --no-log-prefix karma | grep -c 'healthcheck:'Erwartet: eine Zahl größer als 0, die Healthchecks stehen in der Konfiguration.
docker run --rm -v $PWD/karma:/etc/karma:ro ghcr.io/prymitive/karma:v0.134 \
  --config.file /etc/karma/karma.yaml --check-config 2>&1 | tail -1
Erwartet: Configuration is valid.
Challenge
karma sieht den Fehler, aber nur, wer gerade hinschaut. Lass Prometheus karma abfragen und alarmiere, wenn ein Upstream länger als zwei Minuten fehlt. Teste mit dem Alertmanager von dev.
Hinweis: Prometheus erreicht karma im Compose-Netz
direkt unter karma:8080, ohne Caddy. Mit Header-Auth ist
/metrics ohne Header erreichbar, alle anderen Pfade
nicht.
Lösung
In prometheus/prometheus.yml unter
scrape_configs ein vierter Job:
  - job_name: karma
    static_configs:
      - targets: ["karma:8080"]
Eine Regel an prometheus/rules/plattform.yml
anhängen:
cat >> prometheus/rules/plattform.yml <<'EOF'
      - alert: KarmaUpstreamDown
        expr: karma_alertmanager_up == 0
        for: 2m
        labels:
          severity: warning
          team: plattform
        annotations:
          summary: "karma erreicht Alertmanager {{ $labels.alertmanager }} nicht"
EOF
promtool check rules prometheus/rules/plattform.yml
curl -s -X POST localhost:9090/-/reload
Erwartet:
Checking prometheus/rules/plattform.yml
  SUCCESS: 4 rules found
promtool query instant http://localhost:9090 karma_alertmanager_upErwartet (nach einem Scrape):
karma_alertmanager_up{alertmanager="dev", instance="karma:8080", job="karma"} => 1 @[1794863199.252]
karma_alertmanager_up{alertmanager="prod-1", instance="karma:8080", job="karma"} => 1 @[1794863199.252]
…
docker compose stop alertmanager-devNach gut drei Minuten:
promtool query instant http://localhost:9090 'ALERTS{alertname="KarmaUpstreamDown"}'Erwartet:
ALERTS{alertmanager="dev", alertname="KarmaUpstreamDown", alertstate="firing", instance="karma:8080", job="karma", severity="warning", team="plattform"} => 1 @[1794863400.787]docker compose start alertmanager-devDieser Alarm läuft über den Alertmanager von prod. Fällt prod aus, hilft er nicht. Den Alertmanager überwacht man deshalb zusätzlich von außen, etwa mit einem Totmannschalter auf den Watchdog.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Den Watchdog an einen externen Dienst schicken (Healthchecks.io, Dead Man’s Snitch, PagerDuty-Heartbeat). Bleibt er aus, schlägt der Dienst Alarm, unabhängig von der eigenen Kette.
history.rewritebraucht man fast immer, sobald Prometheus hinter einem Ingress mit Anmeldung steht. Header und TLS gibt es pro Regel.--check-configin die CI, gleich nebenpromtoolundamtool check-config.- Ohne
level: debugist karma sehr schweigsam. Für den Betrieb reichtinfomitformat: json.