Tag 18: Logs und Alarme
Ziel: Das Journal und das Kernel-Log der Worker landen in Loki, Alarmregeln für LINSTOR und DRBD sind mit
promtoolgetestet, Alertmanager schickt Mails an Mailpit, und ein echter DRBD-Fehler läuft vom Kernel-Log bis zur Mail. · Dauer: ca. 75 min · Voraussetzung: Tag 17
Briefing
- DRBD meldet jede Zustandsänderung ins Kernel-Log
(
conn( Connected -> NetworkFailure )). Alloy liest das Journal auf jedem Worker und schickt es an Loki. - Alarmregeln sind PromQL mit
for-Dauer und Labels. Mitpromtool test rulesprüfst du sie gegen erfundene Zeitreihen, bevor sie nachts jemanden wecken. - Alertmanager bündelt Alarme und verschickt sie. Im Labor fängt Mailpit alle Mails ab, ohne Zugangsdaten.
- Lehre des Tages: Nicht jeder Quorum-Verlust ist kritisch.
 Kernel/Journal ── Alloy (DaemonSet) ──> Loki ──────────────> Grafana Explore
 drbd-reactor, Controller ──> Prometheus ── Regeln ──> Alertmanager ──> Mailpit
Drill 1: Mailpit
# auf k0s-ctrl
mkdir -p ~/k0s-lab/tag18 && cd ~/k0s-lab/tag18
cat > mailpit.yaml <<'EOF'
apiVersion: apps/v1
kind: Deployment
metadata: {name: mailpit, namespace: monitoring}
spec:
  replicas: 1
  selector: {matchLabels: {app: mailpit}}
  template:
    metadata: {labels: {app: mailpit}}
    spec:
      containers:
        - name: mailpit
          image: axllent/mailpit:v1.34.0
          ports: [{containerPort: 1025}, {containerPort: 8025}]
          resources: {requests: {cpu: 10m, memory: 32Mi}}
---
apiVersion: v1
kind: Service
metadata: {name: mailpit, namespace: monitoring}
spec:
  selector: {app: mailpit}
  ports:
    - {name: smtp, port: 1025}
    - {name: web, port: 8025}
EOF
kubectl apply -f mailpit.yaml
kubectl -n monitoring rollout status deploy/mailpit --timeout=120s
Erwartet:
deployment.apps/mailpit created
service/mailpit created
...
deployment "mailpit" successfully rolled out
Port 1025 nimmt Mails per SMTP an, Port 8025 zeigt sie im Browser und per API.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Loki im Single-Binary-Modus
Ein einzelner Loki-Prozess mit Dateisystem als Speicher reicht für drei Worker. Alles, was das Chart sonst für große Installationen startet, schaltest du ab:
# auf k0s-ctrl
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
cat > loki-werte.yaml <<'EOF'
deploymentMode: SingleBinary
loki:
  auth_enabled: false
  commonConfig: {replication_factor: 1}
  storage: {type: filesystem}
  schemaConfig:
    configs:
      - from: "2026-01-01"
        store: tsdb
        object_store: filesystem
        schema: v13
        index: {prefix: index_, period: 24h}
  limits_config: {retention_period: 48h}
  compactor:
    retention_enabled: true
    delete_request_store: filesystem
singleBinary:
  replicas: 1
  resources: {requests: {cpu: 50m, memory: 192Mi}}
  persistence: {size: 5Gi, storageClass: linstor-replicated}
read: {replicas: 0}
write: {replicas: 0}
backend: {replicas: 0}
gateway: {enabled: false}
chunksCache: {enabled: false}
resultsCache: {enabled: false}
lokiCanary: {enabled: false}
test: {enabled: false}
EOF
helm install loki grafana/loki --version 7.7.0 -n monitoring -f loki-werte.yaml \
  --wait --timeout 10m
kubectl -n monitoring get pod,pvc -l app.kubernetes.io/name=loki | cut -c1-80
Erwartet (gekürzt):
NAME         READY   STATUS    RESTARTS   AGE
pod/loki-0   2/2     Running   0          74s
NAME                                   STATUS   VOLUME
persistentvolumeclaim/storage-loki-0   Bound    pvc-fc406db6-...
retention_period: 48h wirkt nur mit
retention_enabled im Compactor – ohne löscht Loki nichts.
Der zweite Container in loki-0 ist ein Sidecar für Regeln,
er stört nicht.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Alloy liest das Journal
# auf k0s-ctrl
cat > alloy-werte.yaml <<'EOF'
alloy:
  mounts:
    varlog: true
  resources: {requests: {cpu: 20m, memory: 64Mi}}
  configMap:
    content: |
      loki.relabel "journal" {
        forward_to = []
        rule {
          source_labels = ["__journal__systemd_unit"]
          target_label  = "unit"
        }
        rule {
          source_labels = ["__journal__transport"]
          target_label  = "transport"
        }
        rule {
          source_labels = ["__journal__hostname"]
          target_label  = "host"
        }
      }
      loki.source.journal "journal" {
        path          = "/var/log/journal"
        relabel_rules = loki.relabel.journal.rules
        labels        = {job = "journal"}
        max_age       = "12h"
        forward_to    = [loki.write.loki.receiver]
      }
      loki.write "loki" {
        endpoint {
          url = "http://loki.monitoring.svc:3100/loki/api/v1/push"
        }
      }
controller:
  type: daemonset
EOF
helm install alloy grafana/alloy --version 1.16.0 -n monitoring -f alloy-werte.yaml \
  --wait --timeout 5m
kubectl -n monitoring get pod -l app.kubernetes.io/name=alloy -o wide | cut -c1-70
Erwartet:
NAME          READY   STATUS    RESTARTS   AGE    IP            NODE
alloy-6nlqk   2/2     Running   0          104s   10.244.1.41   k0s-w2
alloy-7h4xc   2/2     Running   0          104s   10.244.0.48   k0s-w3
alloy-b242q   2/2     Running   0          104s   10.244.2.38   k0s-w1
varlog: true hängt /var/log des Hosts ein,
darin liegt das Journal. Die Relabel-Regeln machen aus den
Journal-Feldern die Labels unit, transport und
host. Kommt etwas an? Port-Forward im zweiten Terminal:
# auf k0s-ctrl
kubectl -n monitoring port-forward svc/loki 3100:3100
# auf k0s-ctrl
curl -s localhost:3100/loki/api/v1/label/host/values | jq -c .data
curl -s localhost:3100/loki/api/v1/label/transport/values | jq -c .dataErwartet:
["k0s-w1","k0s-w2","k0s-w3"]
["driver","journal","kernel","stdout","syslog"]
transport="kernel" sind die Kernel-Meldungen – dort
spricht DRBD.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Alarmregeln
Die Regeln kommen als PrometheusRule in den Cluster.
Alle tragen team: storage, darüber leitet Alertmanager sie
ab Drill 6 an die Mail weiter:
# auf k0s-ctrl
cat > regeln-linstor.yaml <<'EOF'
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata: {name: linstor-drbd, namespace: monitoring}
spec:
  groups:
    - name: linstor
      rules:
        - alert: LinstorControllerWeg
          expr: up{job="linstor-controller"} == 0
          for: 1m
          labels: {severity: critical, team: storage}
          annotations:
            summary: "LINSTOR-Controller über die VIP nicht erreichbar"
        - alert: LinstorSatelliteNichtOnline
          expr: linstor_node_state != 2
          for: 2m
          labels: {severity: warning, team: storage}
          annotations:
            summary: "Satellite {{ $labels.exported_node }} nicht ONLINE"
        - alert: LinstorPoolFastVoll
          expr: >-
            linstor_storage_pool_capacity_free_bytes{driver="LVM"}
            / linstor_storage_pool_capacity_total_bytes{driver="LVM"} < 0.2
          for: 10m
          labels: {severity: warning, team: storage}
          annotations:
            summary: "{{ $labels.exported_node }}/{{ $labels.storage_pool }} fast voll"
    - name: drbd
      rules:
        - alert: DrbdReactorWeg
          expr: up{job="linstor-node"} == 0
          for: 2m
          labels: {severity: warning, team: storage}
          annotations:
            summary: "drbd-reactor auf {{ $labels.instance }} nicht erreichbar"
        - alert: DrbdPrimaryOhneQuorum
          expr: >-
            drbd_device_quorum == 0 and on (instance, name)
            drbd_resource_role{drbd_resource_role="Primary"} == 1
          labels: {severity: critical, team: storage}
          annotations:
            summary: "{{ $labels.name }}: Primary {{ $labels.instance }} ohne Quorum"
        - alert: DrbdOhneQuorum
          expr: >-
            drbd_device_quorum == 0 unless on (instance, name)
            drbd_resource_role{drbd_resource_role="Primary"} == 1
          for: 1m
          labels: {severity: warning, team: storage}
          annotations:
            summary: "{{ $labels.name }}: Secondary {{ $labels.instance }} ohne Quorum"
        - alert: DrbdSuspendiert
          expr: >-
            drbd_resource_suspended == 1 and on (instance, name)
            drbd_resource_role{drbd_resource_role="Primary"} == 1
          for: 30s
          labels: {severity: critical, team: storage}
          annotations:
            summary: "{{ $labels.name }}: I/O auf {{ $labels.instance }} angehalten"
        - alert: DrbdVerbindungGestoert
          expr: drbd_connection_state{drbd_connection_state="Connected"} == 0
          for: 1m
          labels: {severity: warning, team: storage}
          annotations:
            summary: "{{ $labels.instance }}->{{ $labels.conn_name }} getrennt"
        - alert: DrbdPlatteAbgehaengt
          expr: drbd_device_unintentionaldiskless == 1
          labels: {severity: critical, team: storage}
          annotations:
            summary: "{{ $labels.name }}: Platte auf {{ $labels.instance }} weg"
EOF| Regel | Schwere | Warum so |
|---|---|---|
DrbdPrimaryOhneQuorum |
critical | die Anwendung hängt oder bekommt I/O-Fehler |
DrbdOhneQuorum |
warning | Secondary ohne Quorum: Redundanz weg, Daten laufen |
DrbdSuspendiert |
critical | nur auf dem Primary – siehe Drill 7 |
LinstorSatelliteNichtOnline |
warning | Verwaltung fehlt, DRBD läuft weiter (Tag 17) |
and on (instance, name) verknüpft zwei Metriken über
Host und Ressource: Quorum-Verlust und dort Primary.
unless ist das Gegenstück.
Fortschritt speichern? Kostenlos registrieren
Drill 5: Regeln testen mit promtool
promtool liegt dem Prometheus-Release bei, passend zur
Version im Cluster (3.16.0):
# auf k0s-ctrl
ARCH=$(dpkg --print-architecture)
V=3.16.0
B=https://github.com/prometheus/prometheus/releases/download/v$V
curl -sSfLO $B/prometheus-$V.linux-$ARCH.tar.gz
curl -sSfL $B/sha256sums.txt | grep linux-$ARCH.tar.gz | sha256sum -c
tar xzf prometheus-$V.linux-$ARCH.tar.gz prometheus-$V.linux-$ARCH/promtool
sudo install prometheus-$V.linux-$ARCH/promtool /usr/local/bin/
sed -n '/^spec:/,$p' regeln-linstor.yaml | sed '1d;s/^  //' > regeln.yaml
promtool check rules regeln.yaml
Erwartet:
prometheus-3.16.0.linux-amd64.tar.gz: OK
Checking regeln.yaml
  SUCCESS: 9 rules found
Die beiden sed schneiden den spec:-Teil
heraus und rücken ihn aus – das ist das Format, das
promtool versteht. Jetzt der Test: Zwei Kopien verlieren
gleichzeitig das Quorum, k0s-w3 ist Primary,
k0s-w2 Secondary. Dazu ein Secondary, der
suspended meldet:
# auf k0s-ctrl
cat > regeln-test.yaml <<'EOF'
rule_files: [regeln.yaml]
evaluation_interval: 30s
tests:
  - interval: 30s
    input_series:
      - series: drbd_device_quorum{instance="k0s-w3",name="a",volume="0"}
        values: 1 0 0 0 0 0
      - series: >-
          drbd_resource_role{instance="k0s-w3",name="a",drbd_resource_role="Primary"}
        values: 1 1 1 1 1 1
      - series: drbd_device_quorum{instance="k0s-w2",name="a",volume="0"}
        values: 1 0 0 0 0 0
      - series: >-
          drbd_resource_role{instance="k0s-w2",name="a",drbd_resource_role="Primary"}
        values: 0 0 0 0 0 0
    alert_rule_test:
      - eval_time: 30s
        alertname: DrbdPrimaryOhneQuorum
        exp_alerts:
          - exp_labels: {severity: critical, team: storage, instance: k0s-w3,
                         name: a, volume: "0"}
            exp_annotations: {summary: "a: Primary k0s-w3 ohne Quorum"}
      - eval_time: 1m
        alertname: DrbdOhneQuorum
        exp_alerts: []
      - eval_time: 2m
        alertname: DrbdOhneQuorum
        exp_alerts:
          - exp_labels: {severity: warning, team: storage, instance: k0s-w2,
                         name: a, volume: "0"}
            exp_annotations: {summary: "a: Secondary k0s-w2 ohne Quorum"}
  - interval: 30s
    input_series:
      - series: drbd_resource_suspended{instance="k0s-w1",name="a"}
        values: 1 1 1 1
      - series: >-
          drbd_resource_role{instance="k0s-w1",name="a",drbd_resource_role="Primary"}
        values: 0 0 0 0
    alert_rule_test:
      - eval_time: 1m
        alertname: DrbdSuspendiert
        exp_alerts: []
EOF
promtool test rules regeln-test.yaml
Erwartet:
Processing test file: regeln-test.yaml
  SUCCESS
Der Primary löst sofort critical aus, der Secondary erst
nach for: 1m eine Warnung, und der Secondary mit
suspended gar nichts. Wie ein Fehlschlag aussieht, siehst
du, wenn du die zweite eval_time von 1m auf
1m30s setzt:
  FAILED:
    alertname: DrbdOhneQuorum, time: 1m30s,
        exp:[],
        got:[
            0:
              Labels:{alertname="DrbdOhneQuorum", instance="k0s-w2", name="a", sever...
Erst wenn der Test grün ist, kommt die Regel in den Cluster:
# auf k0s-ctrl
kubectl apply -f regeln-linstor.yaml
Fortschritt speichern? Kostenlos registrieren
Drill 6: Alertmanager, Mailpit und Loki in Grafana
Beides gehört in die Werte von kps. Eine zweite
Wertedatei ergänzt die aus Tag 17:
# auf k0s-ctrl
cat > kps-werte-18.yaml <<'EOF'
grafana:
  additionalDataSources:
    - {name: Loki, type: loki, uid: loki, url: "http://loki.monitoring.svc:3100"}
alertmanager:
  config:
    global:
      smtp_smarthost: mailpit.monitoring.svc:1025
      smtp_from: [email protected]
      smtp_require_tls: false
    route:
      receiver: "null"
      group_by: [alertname, instance]
      routes:
        - receiver: storage-mail
          matchers: [team = "storage"]
          group_wait: 30s
          group_interval: 2m
          repeat_interval: 4h
    receivers:
      - name: "null"
      - name: storage-mail
        email_configs:
          - to: [email protected]
            send_resolved: true
EOF
helm upgrade kps prometheus-community/kube-prometheus-stack --version 93.4.1 \
  -n monitoring -f ../tag17/kps-werte.yaml -f kps-werte-18.yaml --wait --timeout 10m
kubectl -n monitoring get secret alertmanager-kps-alertmanager-generated \
  -o jsonpath='{.data.alertmanager\.yaml\.gz}' | base64 -d | gunzip | sed -n 7,17p
Erwartet (gekürzt):
STATUS: deployed
REVISION: 2
route:
  receiver: "null"
  group_by:
  - alertname
  - instance
  routes:
  - receiver: storage-mail
    matchers:
    - team = "storage"
Nur team: storage geht per Mail raus. Die übrigen Regeln
aus kps (CPU, Platten, Kubernetes) landen beim Empfänger
null – im Labor feuern einige davon ständig,
Watchdog sogar absichtlich, und würden die Lehre des Tages
zuschütten. Im Alertmanager bleiben sie sichtbar.
Fortschritt speichern? Kostenlos registrieren
Drill 7: Ein echter DRBD-Fehler
Für die Beobachtung brauchst du die Port-Forwards auf Prometheus (9090, Tag 17), Loki (3100), Alertmanager (9093) und Mailpit (8025), je in einem eigenen Terminal:
# auf k0s-ctrl
kubectl -n monitoring port-forward svc/kps-alertmanager 9093:9093
# auf k0s-ctrl
kubectl -n monitoring port-forward svc/mailpit 8025:8025Für den Browser leitest du die Ports wie an Tag 17 per SSH-Tunnel
weiter, je ein -L für 3000, 9093 und 8025.
Jetzt trennst du k0s-w1 vom DRBD-Verkehr wie an Tag 6.
Auf k0s-w1 liegen Secondaries von linstor_db
und vom Prometheus-Volume:
# auf k0s-w1
date +%T
sudo iptables -I INPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sudo iptables -I OUTPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sleep 10
sudo drbdadm status | grep -E '^[a-z]|quorum'
Erwartet (gekürzt):
05:30:00
linstor_db role:Secondary
  disk:UpToDate quorum:no open:no
pvc-571bd51f-... role:Secondary suspended:quorum
  disk:UpToDate quorum:no open:no blocked:upper
Was steht im Kernel-Log? Loki weiß es:
# auf k0s-ctrl
curl -sG localhost:3100/loki/api/v1/query_range --data-urlencode 'since=10m' \
  --data-urlencode 'query={transport="kernel", host="k0s-w1"} |~ "PingAck|susp-io"' \
  | jq -r '.data.result[].values[][1]' | cut -c1-80
Erwartet (gekürzt):
...
drbd pvc-571bd51f-...: susp-io( no -> quorum )
drbd pvc-571bd51f-... k0s-ctrl: PingAck did not arrive i
drbd pvc-571bd51f-... k0s-w2: PingAck did not arrive in
drbd linstor_db k0s-w2: PingAck did not arrive in time.
drbd linstor_db k0s-ctrl: PingAck did not arrive in time.
drbd linstor_db k0s-w3: PingAck did not arrive in time.
...
Dasselbe in Grafana unter Explore mit der Datenquelle Loki:
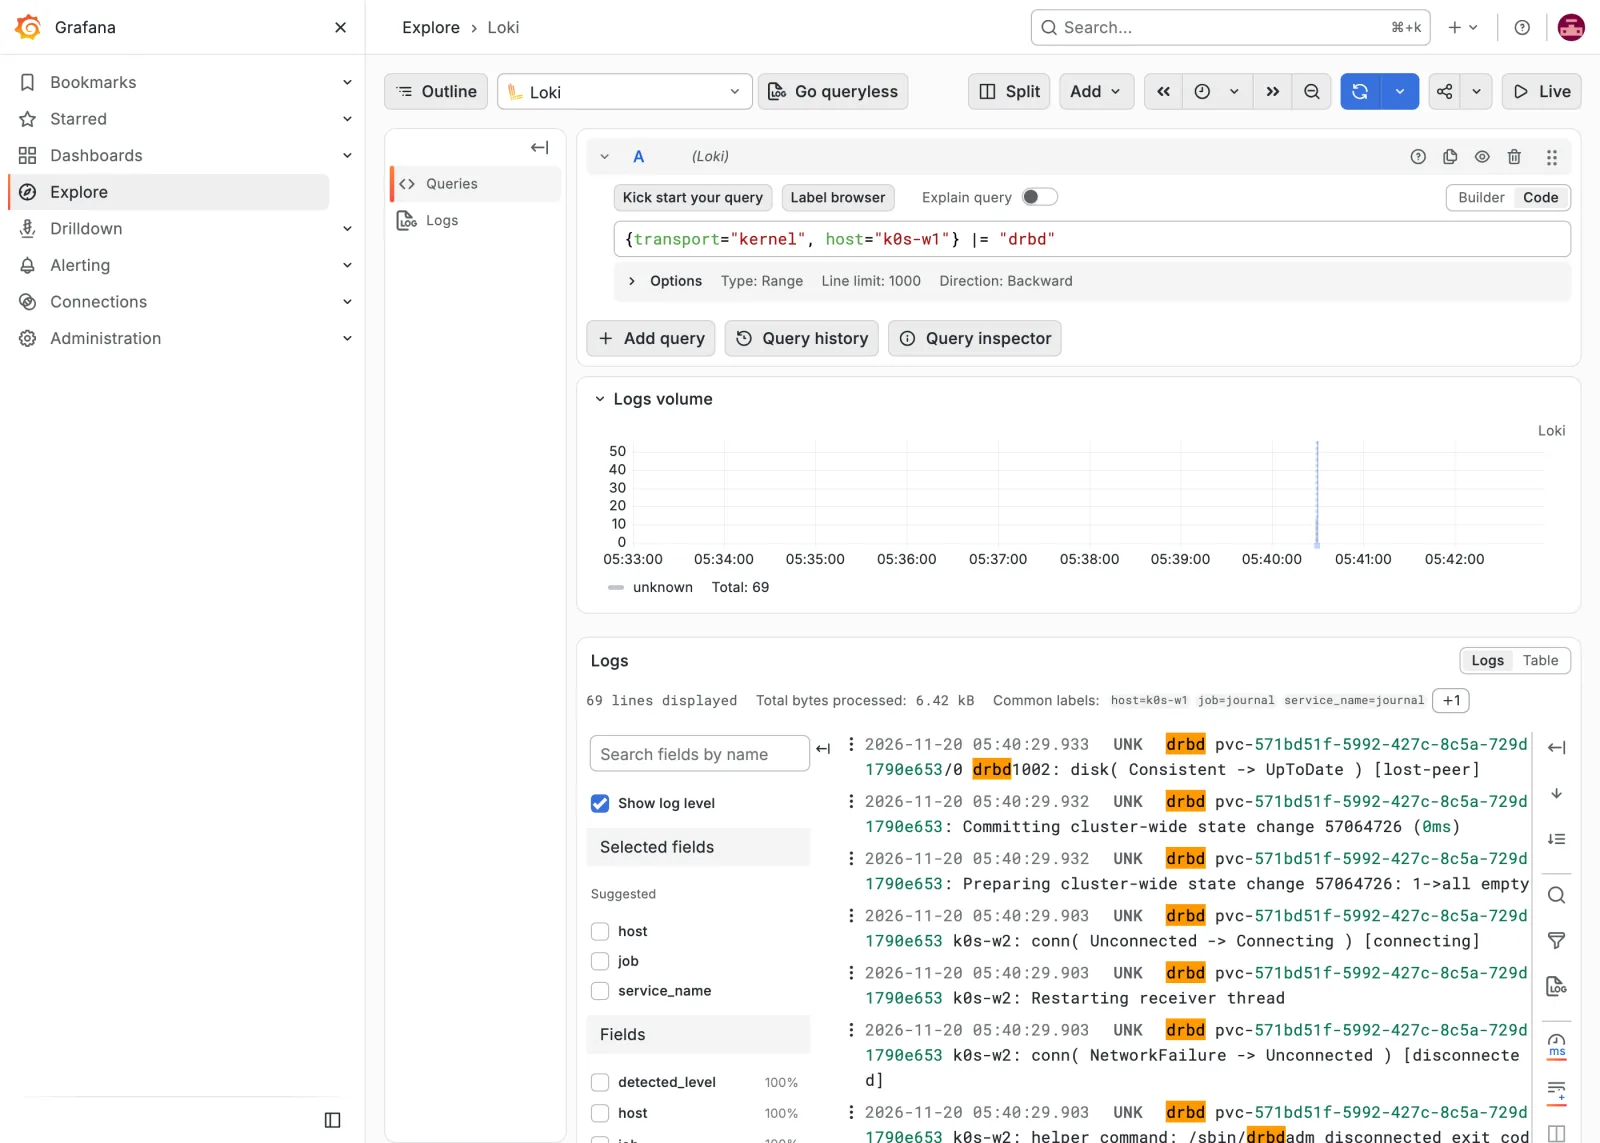
Nach gut anderthalb Minuten feuern die Regeln:
# auf k0s-ctrl
curl -s localhost:9090/api/v1/alerts | jq -r '.data.alerts[]
  | select(.labels.team=="storage")
  | "\(.labels.alertname) \(.labels.severity) \(.state) \(.annotations.summary)"' | sort
Erwartet (gekürzt):
DrbdOhneQuorum warning firing linstor_db: Secondary k0s-w1 ohne Quorum
DrbdOhneQuorum warning firing pvc-571bd51f-...: Secondary k0s-w1 ohne Quorum
DrbdVerbindungGestoert warning firing k0s-ctrl->k0s-w1 getrennt
...
DrbdVerbindungGestoert warning firing k0s-w2->k0s-w1 getrennt
DrbdVerbindungGestoert warning firing k0s-w3->k0s-w1 getrennt
Nur Warnungen: Redundanz weg, Daten laufen. Kein
DrbdSuspendiert, obwohl pvc-571bd51f-... auf
k0s-w1 suspended:quorum zeigt – DRBD setzt
susp-io auch auf einem Secondary ohne Quorum, die Anwendung
merkt davon nichts. Die erste Fassung der Regel hatte die Bedingung
„Primary“ noch nicht; im Labor feuerte sie hier critical
für genau diesen Secondary. Deshalb steht in Drill 4 die Fassung mit
and on (instance, name) und in Drill 5 der Test dafür.
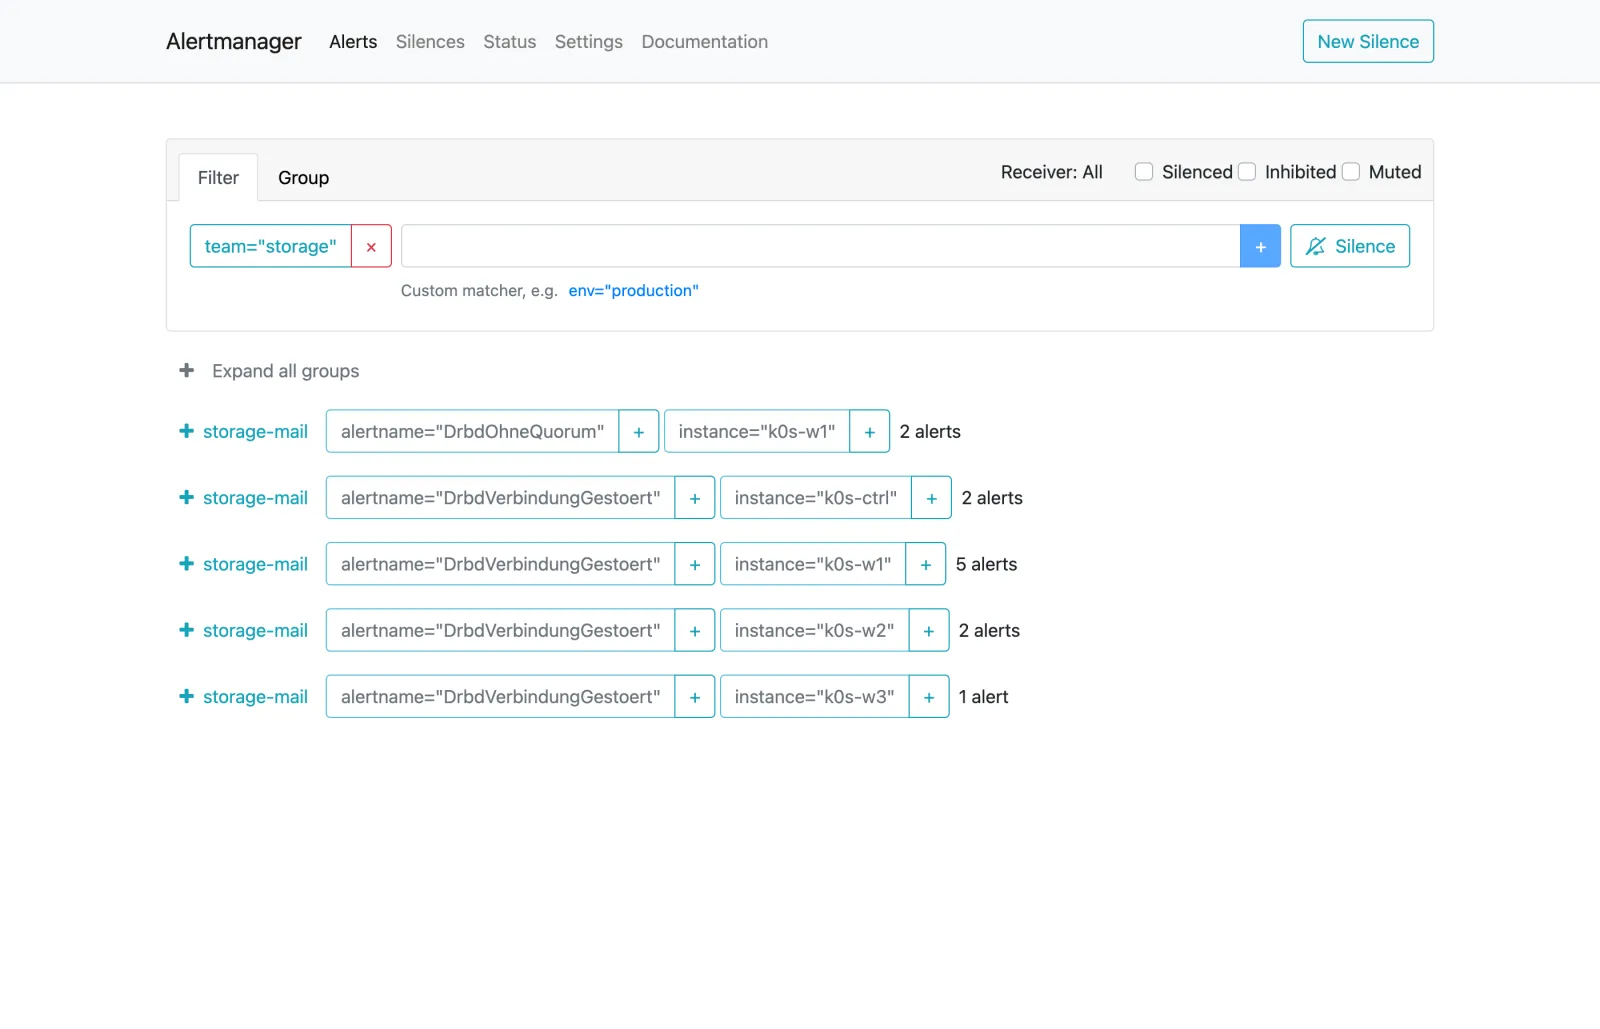
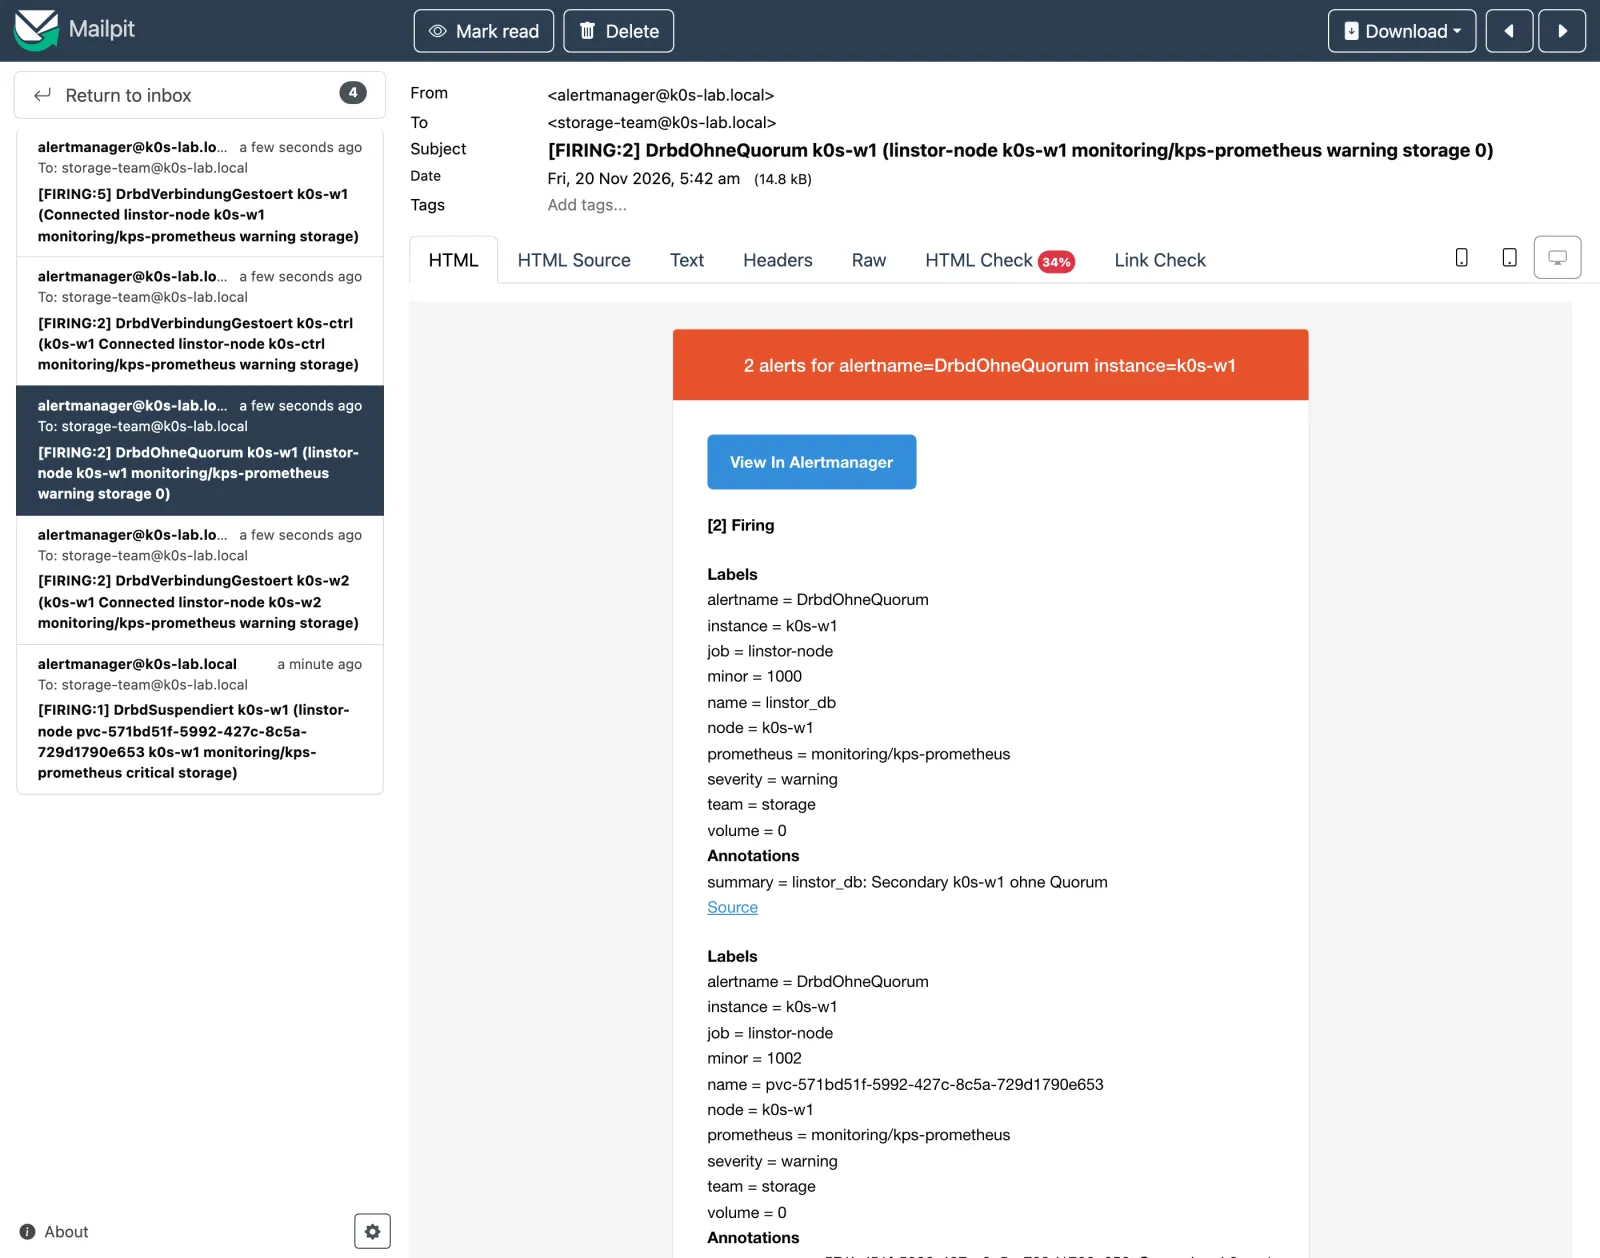
Und die Mails:
# auf k0s-ctrl
curl -s localhost:8025/api/v1/messages | jq -r '.messages[] | .Subject[0:60]'
Erwartet (gekürzt):
[FIRING:1] DrbdVerbindungGestoert k0s-w3 (k0s-w1 Connected l
[FIRING:2] DrbdVerbindungGestoert k0s-ctrl (k0s-w1 Connected
[FIRING:5] DrbdVerbindungGestoert k0s-w1 (Connected linstor-
[FIRING:2] DrbdOhneQuorum k0s-w1 (linstor-node k0s-w1 monito
[FIRING:1] DrbdVerbindungGestoert k0s-w2 (k0s-w1 Connected l
Eine Mail je Regel und Host (Gruppierung nach alertname
und instance). k0s-w3 hat nur einen Alarm: Mit
k0s-w1 teilt er nur linstor_db, das
Prometheus-Volume liegt auf k0s-w1 und k0s-w2.
Seine Mail kommt mit der zweiten Welle eine halbe Minute später – wer zu
früh nachsieht, findet sie noch nicht.
Netz zurück:
# auf k0s-w1
sudo iptables -D INPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sudo iptables -D OUTPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sudo iptables -S | grep -c 7000
Erwartet: 0. Nach einer Minute kommen
die Entwarnungen:
# auf k0s-ctrl
curl -s localhost:8025/api/v1/messages | jq -r '.messages[] | .Subject[0:60]' \
  | grep RESOLVED
Erwartet:
[RESOLVED] DrbdVerbindungGestoert k0s-ctrl (k0s-w1 Connected
[RESOLVED] DrbdVerbindungGestoert k0s-w3 (k0s-w1 Connected l
[RESOLVED] DrbdVerbindungGestoert k0s-w2 (k0s-w1 Connected l
[RESOLVED] DrbdOhneQuorum k0s-w1 (linstor-node k0s-w1 monito
[RESOLVED] DrbdVerbindungGestoert k0s-w1 (Connected linstor-| Zeit | Ereignis |
|---|---|
| 05:30:00 | DRBD-Ports auf k0s-w1 gesperrt |
| 05:30:03 | Kernel: PingAck did not arrive in time, kurz darauf
susp-io( no -> quorum ) |
| 05:31:53 | erste Mails: Quorum und Verbindungen von k0s-w1,
k0s-w2 (for: 1m) |
| 05:32:22 | zweite Welle: k0s-ctrl und k0s-w3 (eine
Auswertung später, group_wait) |
| 05:33:17 | Netz zurück, 05:33:52 bis 05:34:22 Entwarnungen |
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig die letzten fünf DRBD-Kernel-Meldungen von
k0s-w2aus Loki. Zeitziel: 45 s - Zeig, welche Regeln Prometheus aus der Gruppe
drbdgeladen hat. Zeitziel: 30 s - Leere das Postfach von Mailpit. Zeitziel: 15 s
Lösung
# auf k0s-ctrl
curl -sG localhost:3100/loki/api/v1/query_range --data-urlencode 'limit=5' \
  --data-urlencode 'query={transport="kernel", host="k0s-w2"} |= "drbd"' \
  | jq -r '.data.result[].values[][1]' | cut -c1-60
curl -s localhost:9090/api/v1/rules | jq -r '.data.groups[]
  | select(.name=="drbd") | .rules[] | "\(.name) \(.health)"'
curl -s -X DELETE localhost:8025/api/v1/messages
Erwartet (gekürzt):
drbd linstor_db k0s-w1: Committing remote state change 34024
drbd linstor_db: Preparing remote state change 3402419172: 0
...
DrbdReactorWeg ok
DrbdPrimaryOhneQuorum ok
DrbdOhneQuorum ok
DrbdSuspendiert ok
DrbdVerbindungGestoert ok
DrbdPlatteAbgehaengt ok
ok
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
# auf k0s-ctrl
kubectl -n monitoring get pod
Erwartet: kps-Pods,
loki-0, drei alloy-… und
mailpit-… alle Running.
# auf k0s-ctrl
promtool test rules regeln-test.yaml
Erwartet: SUCCESS.
# auf k0s-ctrl
curl -s localhost:9090/api/v1/alerts | jq -r '.data.alerts[]
  | select(.labels.team=="storage") | .labels.alertname'
Erwartet: keine Ausgabe – nach dem Fehler ist wieder alles ruhig.
# auf k0s-ctrl
linstor --no-utf8 --no-color resource list --faulty
Erwartet: eine leere Tabelle.
Challenge
Für eine geplante Wartung an k0s-w1 soll das
Storage-Team keine Mails bekommen. Lege eine Stummschaltung (Silence)
für 30 Minuten an und prüfe sie mit dem Fehler aus Drill 7. Kommt
wirklich keine Mail?
Hinweis: Auch die anderen Hosts melden eine gestörte
Verbindung – zu k0s-w1.
Lösung
Eine Silence nur auf instance="k0s-w1" reicht nicht: Im
Labor kamen damit trotzdem drei Mails
DrbdVerbindungGestoert von k0s-ctrl,
k0s-w2 und k0s-w3 – ihre Verbindung
zu k0s-w1 steht im Label
conn_name. Deshalb zwei Silences:
# auf k0s-ctrl
curl -s -X DELETE localhost:8025/api/v1/messages
kubectl -n monitoring exec alertmanager-kps-alertmanager-0 -c alertmanager -- \
  amtool --alertmanager.url=http://localhost:9093 silence add instance=k0s-w1 \
  --duration=30m --comment="Wartung k0s-w1"
kubectl -n monitoring exec alertmanager-kps-alertmanager-0 -c alertmanager -- \
  amtool --alertmanager.url=http://localhost:9093 silence add conn_name=k0s-w1 \
  --duration=30m --comment="Wartung k0s-w1"
Erwartet: zwei IDs, z. B.
6a8ccbb9-88d0-4ac3-9dfb-d6a1e1f47ed4. Dann die
iptables-Regeln aus Drill 7 auf k0s-w1 setzen
und zwei Minuten warten:
# auf k0s-ctrl
curl -s 'localhost:9093/api/v2/alerts?silenced=true' | jq -r '.[]
  | select(.labels.team=="storage")
  | "\(.labels.alertname) \(.labels.instance) \(.status.state)"' | sort | uniq -c
curl -s localhost:8025/api/v1/messages | jq .total
Erwartet:
      2 DrbdOhneQuorum k0s-w1 suppressed
      2 DrbdVerbindungGestoert k0s-ctrl suppressed
      5 DrbdVerbindungGestoert k0s-w1 suppressed
      2 DrbdVerbindungGestoert k0s-w2 suppressed
      1 DrbdVerbindungGestoert k0s-w3 suppressed
0
Alle Alarme sind da, aber suppressed, und das Postfach
bleibt leer. Die iptables-Regeln auf k0s-w1
wieder entfernen (Drill 7) und die Silences nach der Wartung
beenden:
# auf k0s-ctrl
kubectl -n monitoring exec alertmanager-kps-alertmanager-0 -c alertmanager -- \
  sh -c 'amtool --alertmanager.url=http://localhost:9093 silence query -q \
  | xargs amtool --alertmanager.url=http://localhost:9093 silence expire'
Eine Silence, die zu früh endet, ist harmlos; eine vergessene
schluckt den nächsten echten Ausfall. Deshalb immer mit
--duration.
Fortschritt speichern? Kostenlos registrieren
Interview-Notiz
- Welcher DRBD-Alarm weckt nachts? Quorum-Verlust oder angehaltenes I/O auf dem Primary und eine abgehängte Platte. Ein Secondary ohne Quorum ist eine Warnung für die Arbeitszeit.
- Wie testest du Alarmregeln?
promtool test rulesmit erfundenen Zeitreihen, auch für den Fall, dass eine Regel nicht feuern darf. - Wo suchst du die Ursache einer DRBD-Trennung? Im Kernel-Log
(
conn(,PingAck,susp-io), zentral in Loki über alle Hosts.
Enterprise-Notiz
- Alertmanager mit echtem Mail-Relay, Chat oder Pager; Routen nach
Schwere (
critical→ Bereitschaft,warning→ Ticket) und Runbook-Links in den Annotations. - Wartungsfenster als Silences aus dem Change-Prozess anlegen, nicht von Hand.
- Alloy auch auf der Witness und auf Hosts ohne kubelet (systemd-Dienst), sonst fehlen genau dort die Kernel-Meldungen.
- Loki mit Objektspeicher (S3) und längerer Aufbewahrung; Logs der Storage-Hosts sind bei Datenverlust Beweismittel.
- Regeln und Tests in Git,
promtool test rulesin der Pipeline vor jedem Rollout.