Tag 17: Überwachung – Metriken und Dashboards
Ziel: Prometheus sammelt DRBD-Metriken von drbd-reactor auf allen vier Hosts und LINSTOR-Metriken vom Controller über die VIP, und zwei Grafana-Dashboards zeigen Zustand und Platz auf einen Blick. · Dauer: ca. 75 min · Voraussetzung: Tag 16
Briefing
- Zwei Quellen: drbd-reactor liefert auf jedem Host
unter
:9942den Ist-Zustand von DRBD. Der Controller liefert unter:3370/metricsdas Soll aus LINSTOR – Nodes, Ressourcen, Pools, Fehlerberichte. - Beide laufen außerhalb von Kubernetes. Prometheus holt sie über statische Ziele, den Controller immer über die VIP – er wandert.
- kube-prometheus-stack (
kps) bringt Prometheus, Alertmanager, Grafana, node-exporter und kube-state-metrics. RAM ist knapp: Retention 2 Tage, kleine Requests.
 k0s-ctrl :9942 ─┐
 k0s-w1   :9942 ─┤   job linstor-node        ┌─────────────┐    ┌─────────┐
 k0s-w2   :9942 ─┼──────────────────────────>│ Prometheus  │───>│ Grafana │
 k0s-w3   :9942 ─┘                           │ (monitoring)│    └─────────┘
 VIP 10.10.0.100:3370 ── job linstor-controller ──>└─────────────┘
Drill 1: drbd-reactor als Exporter
Die Metriken sind ein Plugin von drbd-reactor. Du ergänzt die Rolle aus Tag 16 – so bekommen auch künftige Hosts das Plugin:
# auf k0s-ctrl
mkdir -p ~/k0s-lab/tag17
cd ~/k0s-lab/tag16
cat >> roles/linstor/tasks/main.yml <<'EOF'

- name: DRBD-Metriken über drbd-reactor (Tag 17)
  ansible.builtin.copy:
    dest: /etc/drbd-reactor.d/prometheus.toml
    content: |
      [[prometheus]]
      enums = true
      address = ":9942"
    mode: "0644"
  notify: drbd-reactor neu laden
EOF
cat >> roles/linstor/handlers/main.yml <<'EOF'

# reload, nie restart (Tag 16): sonst stoppt auf dem aktiven Node die Controller-Kette
- name: drbd-reactor neu laden
  ansible.builtin.systemd_service:
    name: drbd-reactor
    state: reloaded
EOF
ansible-playbook site.yml | grep -E -A5 'Metriken|RUNNING HANDLER'
Erwartet (gekürzt):
TASK [linstor : DRBD-Metriken über drbd-reactor (Tag 17)] **********************
changed: [k0s-ctrl]
changed: [k0s-w1]
...
RUNNING HANDLER [linstor : drbd-reactor neu laden] *****************************
changed: [k0s-w1]
changed: [k0s-ctrl]
...
Im Labor lief nebenher das Messgerät aus Tag 6 gegen die VIP: 70
Sekunden, 70-mal ok. Der reload liest die
Konfiguration neu, ohne den Promoter anzufassen. Was kommt an?
# auf k0s-ctrl
ssh k0s-w3 'curl -s localhost:9942/metrics' \
  | grep -E '^drbd_(resource_role|device_quorum)'
Erwartet (gekürzt):
drbd_resource_role{name="pvc-11dccaf7-...",drbd_resource_role="Unknown"} 0
drbd_resource_role{name="pvc-11dccaf7-...",drbd_resource_role="Primary"} 1
drbd_resource_role{name="pvc-11dccaf7-...",drbd_resource_role="Secondary"} 0
...
drbd_device_quorum{name="pvc-11dccaf7-...",volume="0",minor="1001"} 1
drbd_device_quorum{name="linstor_db",volume="0",minor="1000"} 1
enums = true schreibt Zustände als eine Zeitreihe je
möglichem Wert, die aktuelle hat 1. So lässt sich auf
„nicht Connected“ abfragen, ohne Zahlencodes zu kennen.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Die Metriken des Controllers
Die VIP liegt im Storage-Netz – frag von einem Worker aus:
# auf k0s-ctrl
ssh k0s-w1 'curl -s http://10.10.0.100:3370/metrics' \
  | grep -E '^linstor_(info|node_state)' | cut -c1-88
ssh k0s-w1 'curl -s http://10.10.0.100:3370/metrics' \
  | grep '^# HELP linstor_node_state' | cut -c1-88
Erwartet (gekürzt):
linstor_info{gitid="75d5fa72d504ccfe55c421ccccda9505af8371f8",buildtime="2026-10-21T...
linstor_node_state{node="k0s-ctrl",address="172.16.0.176",nodetype="SATELLITE",encry...
linstor_node_state{node="k0s-w1",address="10.10.0.11",nodetype="SATELLITE",encryptio...
...
# HELP linstor_node_state 0="OFFLINE", 1="CONNECTED", 2="ONLINE", 3="VERSION_MISMATC...
Hier sind Zustände Zahlen, die Legende steht in # HELP:
2 heißt ONLINE, 3 der Versionsmix
aus Tag 15. Kommen die Pods an beide Quellen? Ein Test-Pod genügt:
# auf k0s-ctrl
kubectl run nettest --rm -i --restart=Never --image=busybox:1.37 -- \
  sh -c 'wget -qO- -T 3 http://172.16.0.176:9942/metrics | grep -c drbd'
Erwartet (gekürzt):
197
pod "nettest" deleted from default namespace
Auch die Witness ist aus dem Pod-Netz erreichbar: kube-router maskiert Verkehr aus dem Pod-Netz, der den Cluster verlässt, auf die Node-Adresse.
Fortschritt speichern? Kostenlos registrieren
Drill 3: kube-prometheus-stack
# auf k0s-ctrl
cd ~/k0s-lab/tag17
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
cat > kps-werte.yaml <<'EOF'
fullnameOverride: kps
# k0s: Controller-Komponenten laufen nicht als Pods auf einem Node
kubeControllerManager: {enabled: false}
kubeScheduler: {enabled: false}
kubeEtcd: {enabled: false}
defaultRules:
  rules:
    etcd: false
    kubeControllerManager: false
    kubeSchedulerAlerting: false
    kubeSchedulerRecording: false
alertmanager:
  alertmanagerSpec:
    retention: 48h
    resources: {requests: {cpu: 10m, memory: 40Mi}}
grafana:
  adminPassword: lab-grafana-123
  resources: {requests: {cpu: 50m, memory: 128Mi}}
  sidecar:
    dashboards: {searchNamespace: monitoring}
prometheusOperator:
  resources: {requests: {cpu: 20m, memory: 64Mi}}
kube-state-metrics:
  resources: {requests: {cpu: 10m, memory: 32Mi}}
prometheus-node-exporter:
  resources: {requests: {cpu: 10m, memory: 24Mi}}
prometheus:
  prometheusSpec:
    retention: 2d
    retentionSize: 4GB
    resources: {requests: {cpu: 100m, memory: 400Mi}}
    serviceMonitorSelectorNilUsesHelmValues: false
    podMonitorSelectorNilUsesHelmValues: false
    ruleSelectorNilUsesHelmValues: false
    storageSpec:
      volumeClaimTemplate:
        spec:
          storageClassName: linstor-replicated
          accessModes: [ReadWriteOnce]
          resources: {requests: {storage: 5Gi}}
    additionalScrapeConfigs:
      - job_name: linstor-node
        static_configs:
          - targets: [172.16.0.176:9942]
            labels: {instance: k0s-ctrl, node: k0s-ctrl}
          - targets: [172.16.0.186:9942]
            labels: {instance: k0s-w1, node: k0s-w1}
          - targets: [172.16.0.36:9942]
            labels: {instance: k0s-w2, node: k0s-w2}
          - targets: [172.16.0.72:9942]
            labels: {instance: k0s-w3, node: k0s-w3}
      - job_name: linstor-controller
        static_configs:
          - targets: [10.10.0.100:3370]
            labels: {instance: linstor-controller, node: vip}
EOF
helm install kps prometheus-community/kube-prometheus-stack --version 93.4.1 \
  -n monitoring --create-namespace -f kps-werte.yaml --wait --timeout 10m
kubectl -n monitoring get pod -o wide | awk '{print $1, $3, $7}' | column -t
Erwartet (gekürzt, gut 3 min):
NAME                                    STATUS   NODE
alertmanager-kps-alertmanager-0         Running  k0s-w2
kps-grafana-7fd75969bc-gcqwb            Running  k0s-w3
kps-kube-state-metrics-7dd67b558-lr6nb  Running  k0s-w3
kps-operator-84fc586db9-2j8bp           Running  k0s-w3
kps-prometheus-node-exporter-fpq7s      Running  k0s-w3
kps-prometheus-node-exporter-pql5l      Running  k0s-w2
kps-prometheus-node-exporter-qnhv4      Running  k0s-w1
prometheus-kps-prometheus-0 Running k0s-w2| Wert | Warum |
|---|---|
kubeEtcd, kubeScheduler,
kubeControllerManager aus |
laufen bei k0s als Prozesse unter dem Dienst
k0scontroller, nicht als Pod auf einem Node |
retention: 2d, retentionSize |
RAM und Platz sind knapp |
*SelectorNilUsesHelmValues: false |
Prometheus nimmt auch eigene Regeln (Tag 18) |
instance und node an jedem Ziel |
lesbare Namen statt 172.16.0.72:9942 |
node-exporter läuft nur auf den drei Workern: k0s-ctrl
ist bei k0s kein Kubernetes-Node. Die Prometheus-Daten liegen auf einem
eigenen Volume aus linstor-replicated.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Die Ziele und erste Abfragen
Öffne ein zweites Terminal für den Zugang zu Prometheus:
# auf k0s-ctrl
kubectl -n monitoring port-forward svc/kps-prometheus 9090:9090
Im ersten Terminal. Die JSON-Antworten liest jq; fehlt
es auf k0s-ctrl, installiere es mit
sudo apt-get install -y jq.
# auf k0s-ctrl
curl -s localhost:9090/api/v1/query --data-urlencode 'query=up{job=~"linstor.*"}' \
  | jq -r '.data.result[] | "\(.metric.job) \(.metric.instance) \(.value[1])"'
Erwartet (Reihenfolge kann abweichen):
linstor-node k0s-w3 1
linstor-node k0s-ctrl 1
linstor-node k0s-w2 1
linstor-node k0s-w1 1
linstor-controller linstor-controller 1
Wo ist was Primary? Die Antwort von DRBD selbst:
# auf k0s-ctrl
curl -s localhost:9090/api/v1/query \
  --data-urlencode 'query=drbd_resource_role{drbd_resource_role="Primary"} == 1' \
  | jq -r '.data.result[] | "\(.metric.instance) \(.metric.name)"'
Erwartet:
k0s-w3 pvc-11dccaf7-...
k0s-w2 linstor_db
k0s-w2 pvc-571bd51f-...
linstor_db auf k0s-w2 – dort läuft der
Controller seit Tag 15. Das neue Volume ist das von Prometheus selbst.
Freier Platz laut LINSTOR:
# auf k0s-ctrl
curl -s localhost:9090/api/v1/query --data-urlencode \
  'query=round(linstor_storage_pool_capacity_free_bytes{driver="LVM"} / 2^30, 0.01)' \
  | jq -r '.data.result[]
      | "\(.metric.exported_node) \(.metric.storage_pool) \(.value[1])"'
Erwartet:
k0s-w1 pool_data 24.79
k0s-w2 pool_data 22.79
k0s-w3 pool_data 27.79
k0s-w1 pool_nvme 1.74
k0s-w2 pool_nvme 1.64
k0s-w3 pool_nvme 1.89
Warum exported_node? Das Ziel trägt selbst ein Label
node (vip). Prometheus benennt das
gleichnamige Label der Metrik deshalb in exported_node um.
Genau so erwartet es das Dashboard in Drill 6.
Fortschritt speichern? Kostenlos registrieren
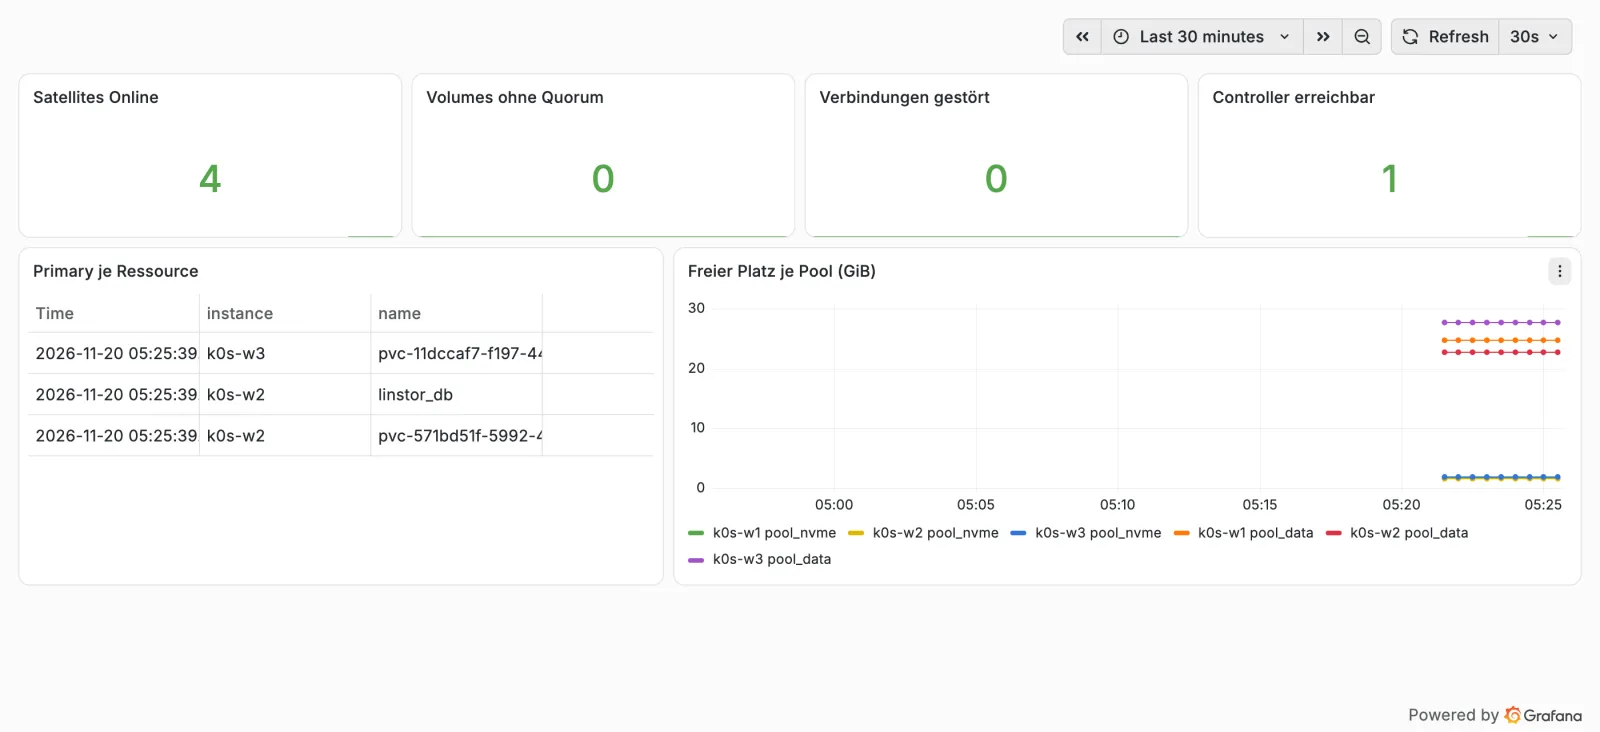
Drill 5: Ein eigenes Dashboard
Der Grafana-Sidecar lädt jede ConfigMap mit dem Label
grafana_dashboard=1 als Dashboard. Vier Zahlen, eine
Tabelle und ein Verlauf reichen für den ersten Blick:
# auf k0s-ctrl
cat > k0s-linstor.json <<'EOF'
{
  "title": "k0s-LINSTOR Übersicht",
  "uid": "k0s-linstor",
  "time": {"from": "now-1h", "to": "now"},
  "refresh": "30s",
  "panels": [
    {"type": "stat", "title": "Satellites Online",
     "gridPos": {"x": 0, "y": 0, "w": 6, "h": 4},
     "targets": [{"expr": "count(linstor_node_state == 2)"}]},
    {"type": "stat", "title": "Volumes ohne Quorum",
     "gridPos": {"x": 6, "y": 0, "w": 6, "h": 4},
     "targets": [{"expr": "count(drbd_device_quorum == 0) or vector(0)"}]},
    {"type": "stat", "title": "Verbindungen gestört",
     "gridPos": {"x": 12, "y": 0, "w": 6, "h": 4},
     "targets": [{"expr":
"count(drbd_connection_state{drbd_connection_state=\"Connected\"}==0) or vector(0)"}]},
    {"type": "stat", "title": "Controller erreichbar",
     "gridPos": {"x": 18, "y": 0, "w": 6, "h": 4},
     "targets": [{"expr": "up{job=\"linstor-controller\"}"}]},
    {"type": "table", "title": "Primary je Ressource",
     "gridPos": {"x": 0, "y": 4, "w": 10, "h": 8},
     "targets": [{"expr":
"max by (name, instance) (drbd_resource_role{drbd_resource_role=\"Primary\"})==1",
                  "format": "table", "instant": true}]},
    {"type": "timeseries", "title": "Freier Platz je Pool (GiB)",
     "gridPos": {"x": 10, "y": 4, "w": 14, "h": 8},
     "targets": [{"expr":
       "linstor_storage_pool_capacity_free_bytes{driver=\"LVM\"}/2^30",
                  "legendFormat": "{{exported_node}} {{storage_pool}}"}]}
  ]
}
EOF
kubectl -n monitoring create configmap dash-k0s-linstor --from-file=k0s-linstor.json
kubectl -n monitoring label configmap dash-k0s-linstor grafana_dashboard=1
Erwartet:
configmap/dash-k0s-linstor created
configmap/dash-k0s-linstor labeled
Grafana erreichst du wie Prometheus per Port-Forward, in einem dritten Terminal:
# auf k0s-ctrl
kubectl -n monitoring port-forward svc/kps-grafana 3000:80
Von deinem Rechner aus mit einem SSH-Tunnel:
ssh -i ~/.ssh/homelab -L 3000:localhost:3000 [email protected],
dann http://localhost:3000 im Browser, Benutzer
admin, Passwort lab-grafana-123. Dashboard
„k0s-LINSTOR Übersicht“:
Fortschritt speichern? Kostenlos registrieren
Drill 6: Das Community-Dashboard 15917
Das Dashboard „LINSTOR / DRBD“ (grafana.com, Nr. 15917) stammt aus
dem Piraeus-Umfeld. Es erwartet die Jobs linstor-node und
linstor-controller sowie die Labels node und
exported_node – deshalb die Namen in
kps-werte.yaml.
# auf k0s-ctrl
curl -sSfL -o drbd-15917.json \
  https://grafana.com/api/dashboards/15917/revisions/latest/download
jq -r '.title, .templating.list[1].query.query' drbd-15917.json
kubectl -n monitoring create configmap dash-drbd-15917 --from-file=drbd-15917.json
kubectl -n monitoring label configmap dash-drbd-15917 grafana_dashboard=1
curl -s -u admin:lab-grafana-123 'localhost:3000/api/search?query=LINSTOR' \
  | jq -r '.[].title'
Erwartet (gekürzt):
LINSTOR / DRBD
label_values(drbdreactor_up, node)
configmap/dash-drbd-15917 created
configmap/dash-drbd-15917 labeled
k0s-LINSTOR Übersicht
LINSTOR / DRBD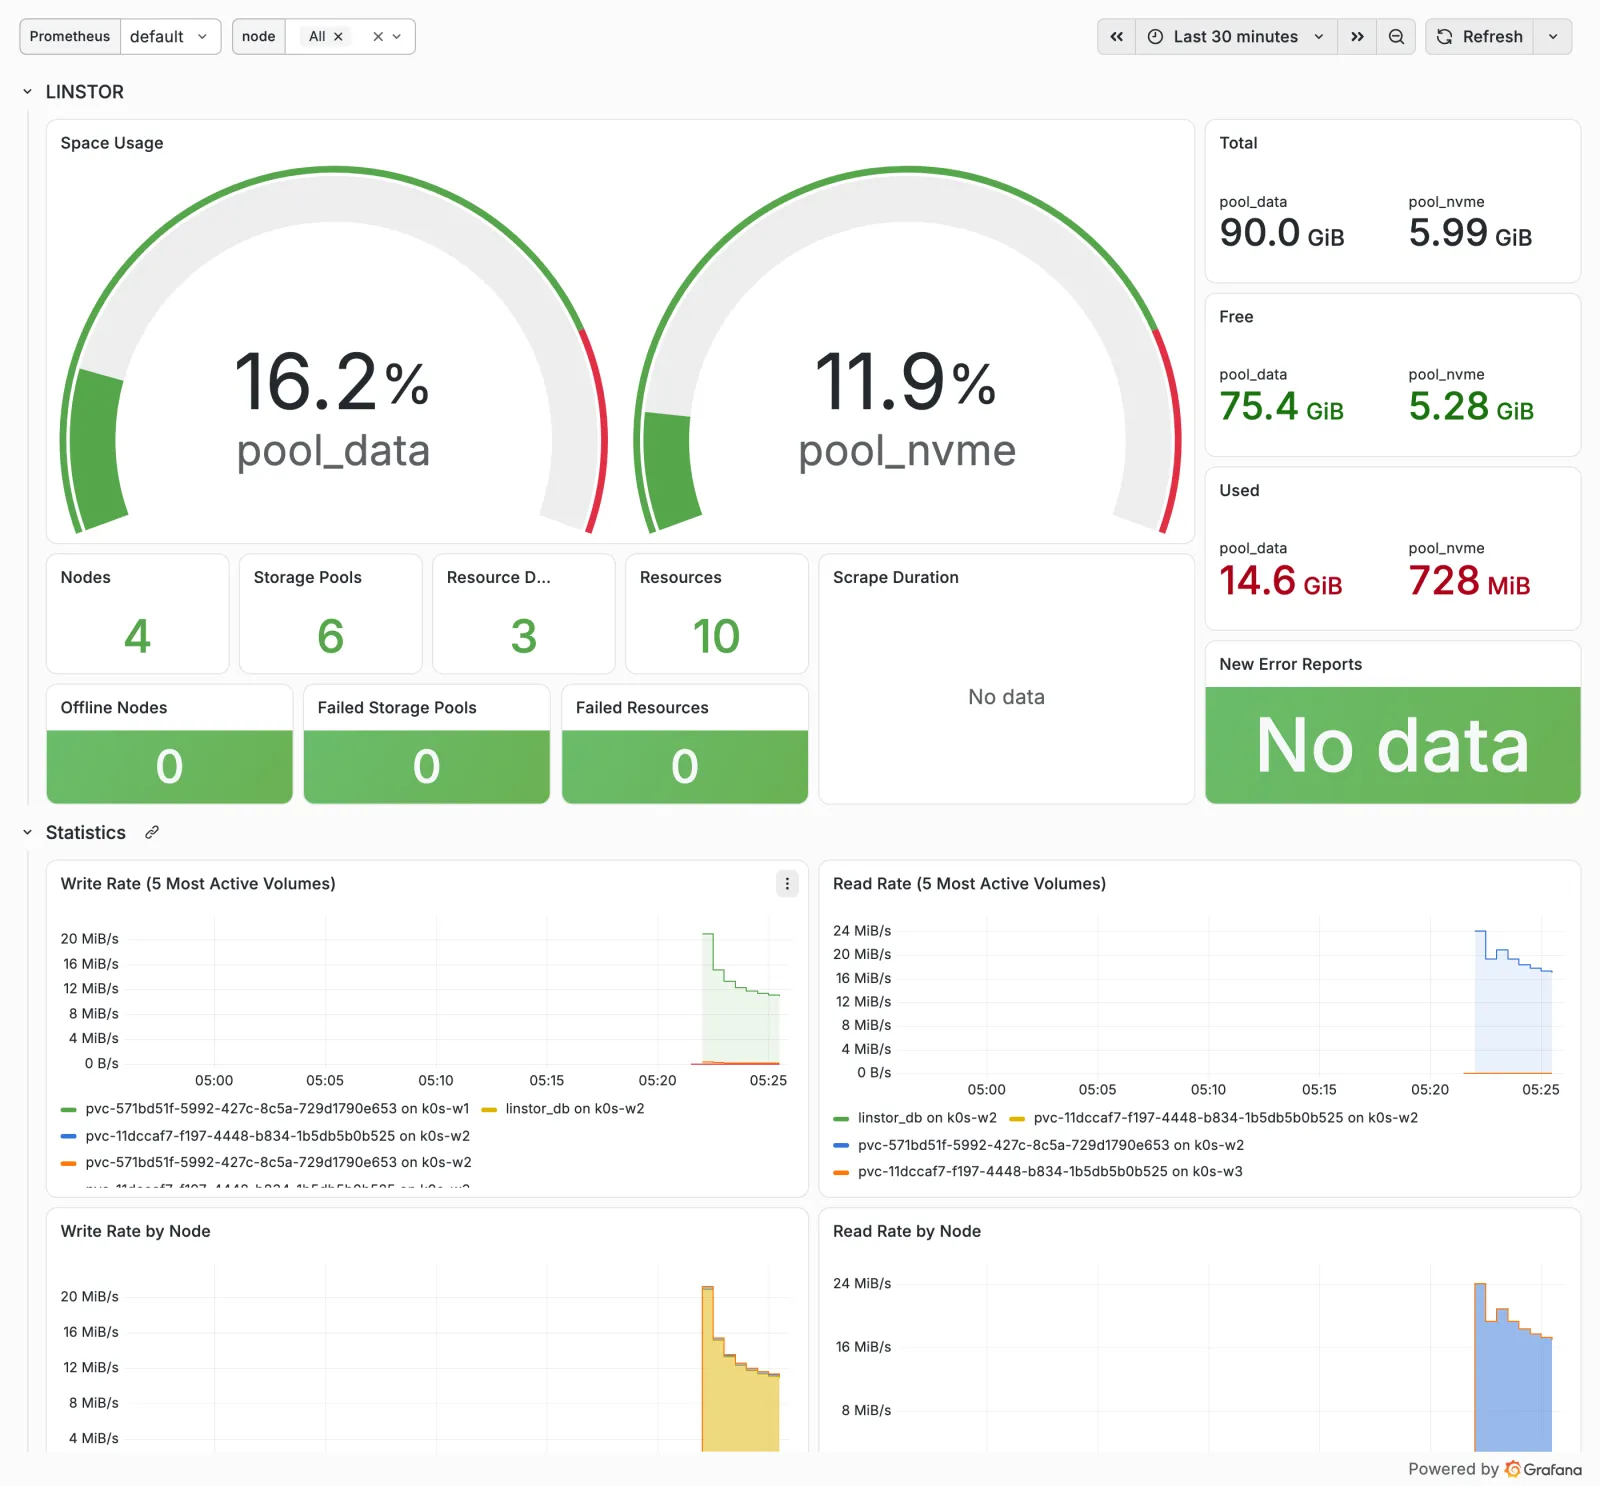
Die Zahlen für pool_data summieren alle drei Worker (90
GiB). „Scrape Duration“ bleibt leer, weil die Abfrage Labels erwartet,
die nur ein Piraeus-Setup mit Satellites in Pods liefert; „New Error
Reports“, weil im Zeitfenster kein neuer Fehlerbericht entstand.
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig Retention und Größenlimit der Prometheus-Instanz. Zeitziel: 20 s
- Zeig, wie viele Metrikzeilen drbd-reactor auf der Witness liefert. Zeitziel: 15 s
- Zeig die Titel aller Dashboards mit „LINSTOR“ im Namen. Zeitziel: 20 s
- Zeig per PromQL, welche DRBD-Verbindungen nicht
Connectedsind. Zeitziel: 45 s
Lösung
# auf k0s-ctrl
kubectl -n monitoring get prometheus kps-prometheus \
  -o jsonpath='{.spec.retention} {.spec.retentionSize}{"\n"}'
curl -s localhost:9942/metrics | grep -c '^drbd'
curl -s -u admin:lab-grafana-123 'localhost:3000/api/search?query=LINSTOR' \
  | jq -r '.[].title'
curl -s localhost:9090/api/v1/query --data-urlencode \
  'query=drbd_connection_state{drbd_connection_state="Connected"} == 0' \
  | jq -r '.data.result[] | "\(.metric.instance) \(.metric.name) \(.metric.conn_name)"'
Erwartet:
2d 4GB
141
k0s-LINSTOR Übersicht
LINSTOR / DRBD
Die letzte Abfrage gibt nichts aus – alle Verbindungen stehen. Sie braucht den Port-Forward auf 9090, die dritte den auf 3000.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
# auf k0s-ctrl
helm -n monitoring list
Erwartet: kps mit
kube-prometheus-stack-93.4.1, Status
deployed.
# auf k0s-ctrl
kubectl -n monitoring get pod
Erwartet: alle Pods Running, drei
node-exporter.
# auf k0s-ctrl
curl -s localhost:9090/api/v1/query \
  --data-urlencode 'query=count(up{job=~"linstor.*"}==1)' \
  | jq -r '.data.result[0].value[1]'
Erwartet: 5 – vier drbd-reactor und der
Controller.
Challenge
Stoppe den Satellite auf k0s-w3 und zeig mit Prometheus,
dass LINSTOR den Node als OFFLINE sieht, DRBD auf
k0s-w3 aber weiter Quorum hat. Starte ihn danach
wieder.
Hinweis: Soll und Ist kommen aus verschiedenen Jobs – frag beide.
Lösung
# auf k0s-ctrl
ssh k0s-w3 'sudo systemctl stop linstor-satellite'
sleep 45
curl -s localhost:9090/api/v1/query \
  --data-urlencode 'query=linstor_node_state{exported_node="k0s-w3"}' \
  | jq -r '.data.result[] | "\(.metric.exported_node) \(.value[1])"'
curl -s localhost:9090/api/v1/query \
  --data-urlencode 'query=drbd_device_quorum{instance="k0s-w3"}' \
  | jq -r '.data.result[] | "\(.metric.instance) \(.metric.name) \(.value[1])"'
kubectl -n demo logs deploy/pg-client --tail=1
ssh k0s-w3 'sudo systemctl start linstor-satellite'
Erwartet:
k0s-w3 0
k0s-w3 pvc-11dccaf7-... 1
k0s-w3 linstor_db 1
04:27:38 ok
0 heißt OFFLINE – LINSTOR kann
k0s-w3 nicht verwalten. DRBD auf k0s-w3 hat
Quorum, pg-0 schreibt dort weiter. Das ist Tag 9 als
Metrik: Im Zweifel gilt DRBD. Ein Alarm auf
linstor_node_state allein würde hier Panik machen, wo nur
die Verwaltung fehlt.
Fortschritt speichern? Kostenlos registrieren
Interview-Notiz
- Woher kommen DRBD-Metriken? Aus dem Prometheus-Plugin von
drbd-reactor auf jedem Host (
:9942), nicht vom LINSTOR-Controller. - Was misst der Controller, was DRBD? Der Controller das Soll und die Verwaltung (Nodes, Pools, Fehlerberichte), drbd-reactor den Ist-Zustand (Rolle, Verbindung, Quorum, Out-of-Sync).
- Wie überwachst du einen wandernden Controller? Über die VIP
als einziges Ziel, mit festem
instance-Label.
Enterprise-Notiz
- Das Monitoring nicht nur auf dem Speicher betreiben, den es überwacht: Prometheus mit lokalem Volume oder außerhalb des Clusters, Langzeitdaten in Thanos oder Mimir.
- Witness und Hosts ohne kubelet zusätzlich mit node-exporter als systemd-Dienst überwachen.
- Metrik-Ports nur für das Monitoring-Netz öffnen;
:3370ist auch die REST-API zum Ändern – in Produktion mit TLS und Authentifizierung. - Dashboards als Code (ConfigMaps in Git oder Grafana-Operator), nicht in der Oberfläche zusammenklicken.
- Mehr zu Prometheus, Loki und Alarmen im Betrieb: das Trainingslager „Observability zum Anfassen“.