Tag 13: Backup und Restore
Ziel: Rancher selbst mit dem Backup-Operator sichern und einen Bedienfehler zurückholen, dann ein etcd-Snapshot von werk über Rancher anlegen und zurückspielen. · Dauer: ca. 90 min · Voraussetzung: Tag 12
Briefing
- Es gibt zwei Ebenen. Rancher Backups sichern die Objekte von Rancher (Cluster, Benutzer, Projekte, Rechte, Einstellungen) im local-Cluster. etcd-Snapshots sichern den kompletten Zustand eines verwalteten Clusters.
- Keins von beiden sichert Daten in Volumes. Dafür gibt es
pg_dump(Tag 10) oder Longhorn-Backups. - Rancher Backups laufen als Operator mit CRDs:
Backup,Restore,ResourceSet. - etcd-Snapshots für werk fordert Rancher über Felder im Cluster-Objekt an; dieselben Felder starten auch den Restore.
 local-Cluster                              Cluster werk
 rancher-backup ─► Backup (PV, tar.gz)       etcd auf werk1
   Restore ◄── Datei aus dem Backup            ▲ Snapshot / Restore
 Cluster werk: rkeConfig.etcdSnapshotCreate ───┘
               rkeConfig.etcdSnapshotRestore
Drill 1: Der Backup-Operator
Auch der Backup-Operator kommt aus rancher-charts,
diesmal ins local-Cluster. Die Backups landen auf einem Volume:
source ~/rancher-lab/setup/env.sh
mkdir -p "$LAB/tag13" && cd "$LAB/tag13"
cp "$LAB/code/tag13/"* .
export KUBECONFIG="$LAB/kube/rancher.yaml"
H="Authorization: Bearer $(cat "$LAB/rancher-token")"
API="https://rancher.$RANCHER.sslip.io/v1/catalog.cattle.io.clusterrepos/rancher-charts"
VER=110.0.3+up11.0.4
curl -sk -X POST -H "$H" -H 'Content-Type: application/json' "$API?action=install" \
  -d "{\"charts\":[
        {\"chartName\":\"rancher-backup-crd\",\"version\":\"$VER\",
         \"releaseName\":\"rancher-backup-crd\",\"values\":{}},
        {\"chartName\":\"rancher-backup\",\"version\":\"$VER\",
         \"releaseName\":\"rancher-backup\",
         \"values\":{\"persistence\":{\"enabled\":true,\"storageClass\":\"local-path\",
                                      \"size\":\"2Gi\"}}}],
      \"namespace\":\"cattle-resources-system\",\"wait\":true,\"timeout\":\"600s\"}" \
  | jq -c '{operationName}'
kubectl -n cattle-resources-system rollout status deploy/rancher-backup --timeout=300s
kubectl get resourcesets.resources.cattle.io
Erwartet (gekürzt, Namen, IPs und Zeiten weichen bei dir ab):
{"operationName":"helm-operation-v27bl"}
deployment "rancher-backup" successfully rolled out
NAME                         AGE
rancher-resource-set-basic   45s
rancher-resource-set-full    45s
Ohne die Kennung /k8s/clusters/… in der Adresse spricht
die API mit dem local-Cluster. Die beiden ResourceSets legen fest, was
gesichert wird: basic die Rancher-Objekte,
full zusätzlich alle Secrets. Ein volles Backup sollte
verschlüsselt werden.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Ein Backup
# tag13/backup.yaml – Stand Ende Tag 13: Rancher sichert sich selbst
apiVersion: resources.cattle.io/v1
kind: Backup
metadata:
  name: vor-dem-unfall
spec:
  resourceSetName: rancher-resource-set-basic   # Rancher-Objekte ohne Secrets der Apps
kubectl apply -f backup.yaml
kubectl wait backups.resources.cattle.io/vor-dem-unfall --for=condition=Ready \
--timeout=300s
kubectl get backups.resources.cattle.io
F=$(kubectl get backups.resources.cattle.io vor-dem-unfall \
-o jsonpath='{.status.filename}')
kubectl -n cattle-resources-system exec deploy/rancher-backup -- ls -l /var/lib/backupsErwartet (gekürzt):
backup.resources.cattle.io/vor-dem-unfall created
backup.resources.cattle.io/vor-dem-unfall condition met
NAME             LOCATION   TYPE       LATEST-BACKUP                         …   STATUS
vor-dem-unfall   PV         One-time   vor-dem-unfall-…-16-49-15Z.tar.gz   Completed
-rw-r--r-- 1 bro bro 1074841 Oct 31 16:49 vor-dem-unfall-e813ed2a-…-16-49-15Z.tar.gz
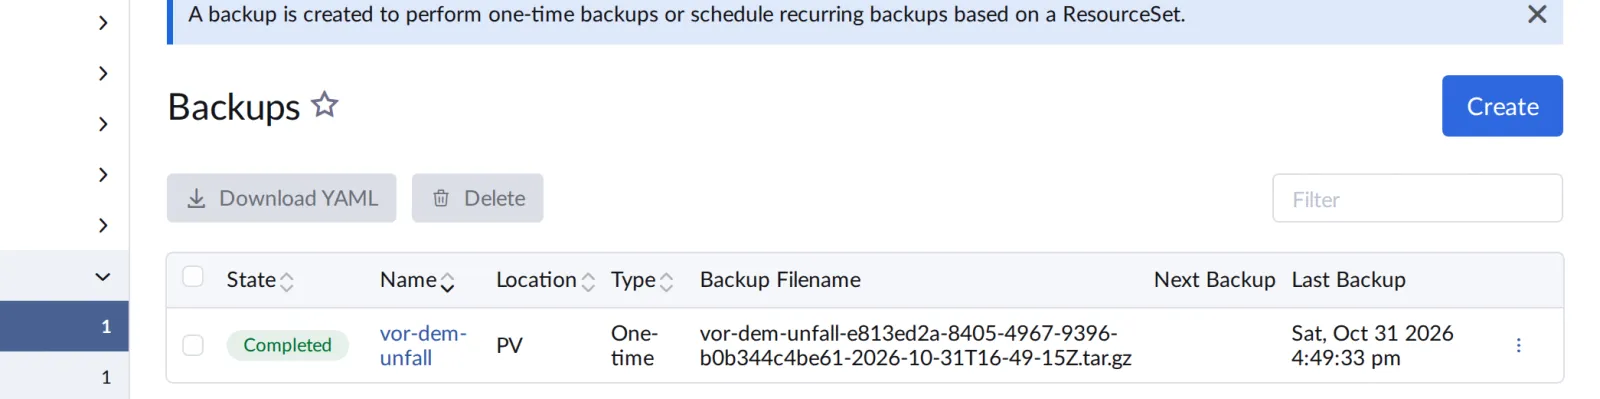
Ein Megabyte für ganz Rancher. In der Oberfläche steht das Backup im local-Cluster unter Rancher Backups:
Fortschritt speichern? Kostenlos registrieren
Drill 3: Unfall und Restore
Jemand löscht aus Versehen annas Mitgliedschaft im Projekt notes (Tag 6):
W_ID=$(kubectl -n fleet-default get clusters.provisioning.cattle.io werk \
  -o jsonpath='{.status.clusterName}')
kubectl -n "$W_ID-p-notes" delete projectroletemplatebindings.management.cattle.io \
  anna-member
kubectl --kubeconfig "$LAB/kube/werk-anna.yaml" -n notes get pods
Erwartet (gekürzt):
projectroletemplatebinding.management.cattle.io "anna-member" deleted from c-m-…
Error from server (Forbidden): … User "u-8k6lh" cannot get resource "clusters" …
Der Restore holt die Objekte aus der Datei zurück.
prune: false lässt alles stehen, was nach dem Backup
dazukam:
# tag13/restore.yaml – Stand Ende Tag 13: Rancher-Objekte aus dem Backup zurückholen
# Vorlage: BACKUP_FILE ersetzt Drill 3 durch den Dateinamen aus dem Backup.
apiVersion: resources.cattle.io/v1
kind: Restore
metadata:
  name: nach-dem-unfall
spec:
  backupFilename: BACKUP_FILE
  prune: false        # nichts löschen, was nach dem Backup dazukam
sed -i '' "s/BACKUP_FILE/$F/" restore.yaml
kubectl apply -f restore.yaml
kubectl wait restores.resources.cattle.io/nach-dem-unfall --for=condition=Ready \
--timeout=600s
kubectl -n "$W_ID-p-notes" get projectroletemplatebindings.management.cattle.io \
-o custom-columns=NAME:.metadata.name,ROLE:.roleTemplateName
kubectl -n cattle-system rollout status deploy/rancher --timeout=300s
kubectl --kubeconfig "$LAB/kube/werk-anna.yaml" -n notes get pods | head -3Erwartet (gekürzt):
restore.resources.cattle.io/nach-dem-unfall created
restore.resources.cattle.io/nach-dem-unfall condition met
NAME          ROLE
anna-member   project-member
deployment "rancher" successfully rolled out
NAME                   READY   STATUS    RESTARTS      AGE
api-5968bfb5cc-5smz4   1/1     Running   4 (58m ago)   58m
…
Der Restore dauert gut eine Minute. Danach startet Rancher neu, damit
es alle Objekte frisch liest; für etwa eine Minute ist die Oberfläche
weg und anna bekommt ServiceUnavailable. Dann ist ihr
Zugang wieder da.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Ein etcd-Snapshot von werk
Rancher fordert einen Snapshot an, wenn sich die Zahl
generation ändert. Genau das macht auch der Knopf
Snapshot Now:
kubectl -n fleet-default patch clusters.provisioning.cattle.io werk --type merge \
  -p '{"spec":{"rkeConfig":{"etcdSnapshotCreate":{"generation":1}}}}'
c='NAME:.metadata.name,FILE:.snapshotFile.name,SIZE:.snapshotFile.size'
c+=',STATUS:.snapshotFile.status'
kubectl -n fleet-default get etcdsnapshots.rke.cattle.io -o custom-columns="$c"
Erwartet (gekürzt, nach gut einer Minute):
cluster.provisioning.cattle.io/werk patched
NAME                                FILE                         SIZE       STATUS
werk-local-on-demand-werk1-17934…   on-demand-werk1-1793465612   43094048   successful
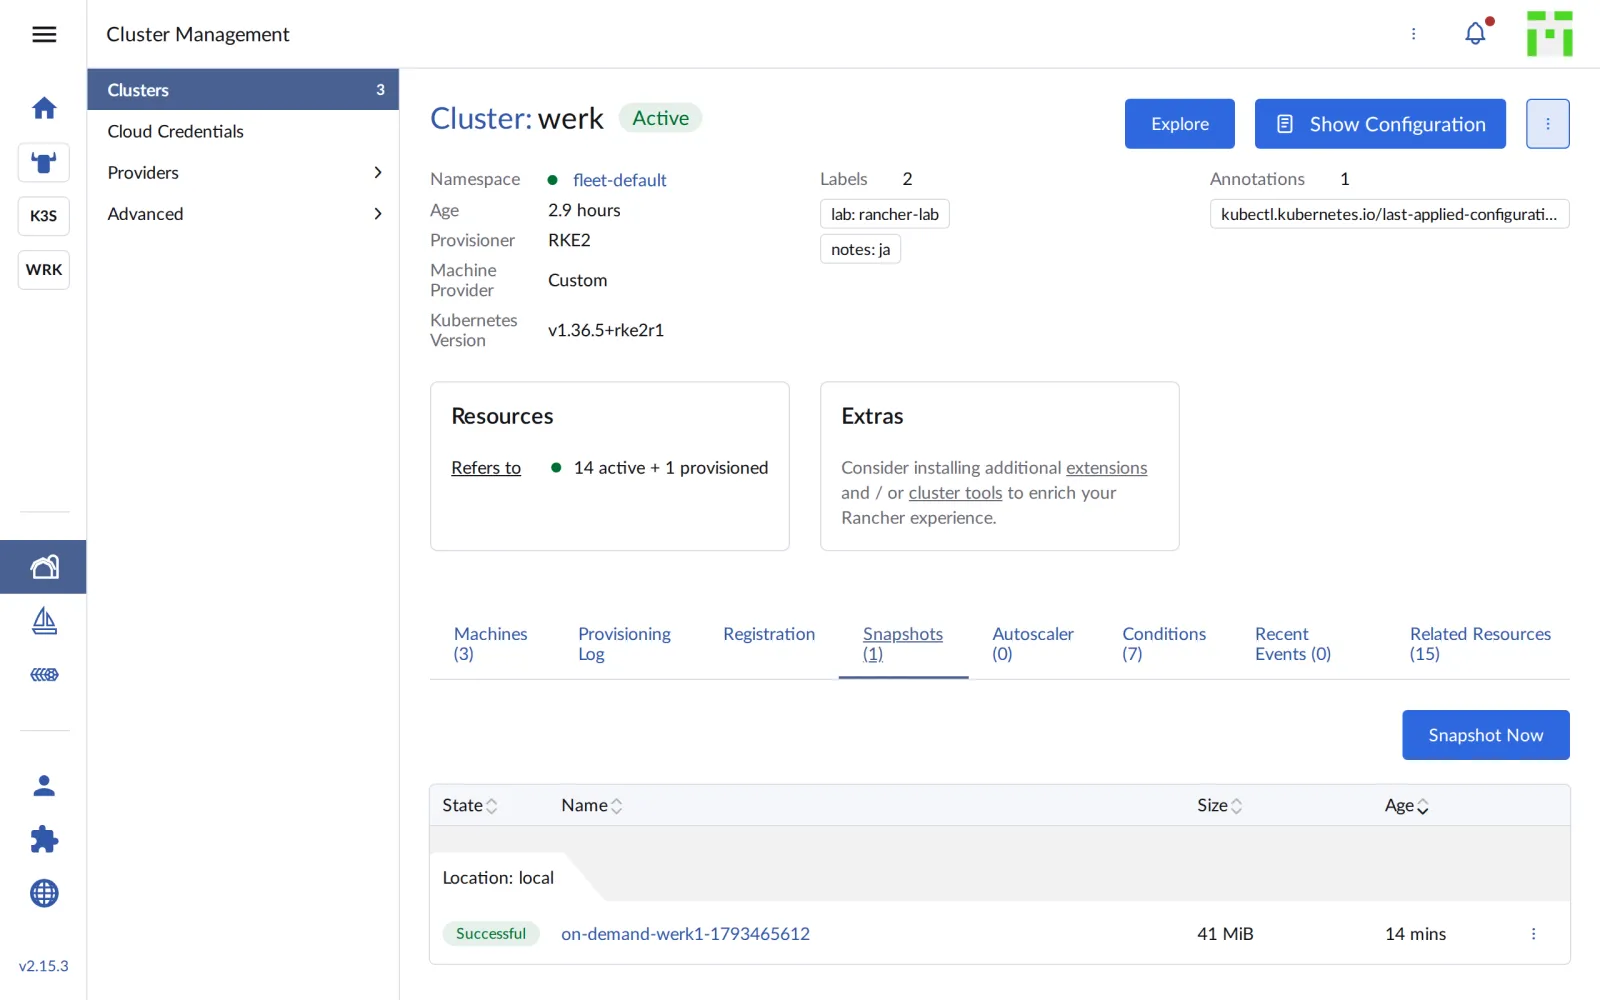
Der Snapshot liegt auf werk1 unter
/var/lib/rancher/rke2/server/db/snapshots, genau wie in
„Kubernetes zum Anfassen”, Tag 14, nur hat ihn Rancher angefordert. Auf
der Detailseite von werk steht er unter Snapshots:
Fortschritt speichern? Kostenlos registrieren
Drill 5: Der Restore
Lege nach dem Snapshot etwas an, das der Restore wieder entfernen soll, und starte im zweiten Terminal die Messschleife gegen notes (Tag 10, Drill 6):
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n default \
  create configmap nach-dem-snapshot \
  --from-literal=zeit="$(date +%T)"
S=$(kubectl -n fleet-default get etcdsnapshots.rke.cattle.io \
  -o jsonpath='{.items[0].metadata.name}')
kubectl -n fleet-default patch clusters.provisioning.cattle.io werk --type merge \
  -p "{\"spec\":{\"rkeConfig\":{\"etcdSnapshotRestore\":{\"name\":\"$S\",
       \"generation\":1,\"restoreRKEConfig\":\"none\"}}}}"
f='{range .status.conditions[?(@.type=="Updated")]}{.status} {.message}{end}'
kubectl -n fleet-default get clusters.provisioning.cattle.io werk -o jsonpath="$f"; echo
Erwartet (gekürzt):
configmap/nach-dem-snapshot created
cluster.provisioning.cattle.io/werk patched
Unknown waiting for etcd restore
Rancher stoppt RKE2 auf allen Nodes, spielt den Snapshot auf werk1
ein und startet die Nodes nacheinander wieder.
restoreRKEConfig: none lässt die Cluster-Konfiguration
unangetastet; nur etcd wird zurückgesetzt. Nach etwa sieben Minuten:
kubectl -n fleet-default wait clusters.provisioning.cattle.io/werk \
  --for=condition=Ready --timeout=900s
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n default get configmap nach-dem-snapshot
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n notes get pods
Erwartet (gekürzt):
cluster.provisioning.cattle.io/werk condition met
Error from server (NotFound): configmaps "nach-dem-snapshot" not found
NAME                      READY   STATUS             RESTARTS        AGE
api-5968bfb5cc-5smz4      0/1     CrashLoopBackOff   9 (2m14s ago)   68m
api-5968bfb5cc-zzpn8      0/1     CrashLoopBackOff   7 (3s ago)      68m
db-0                      0/1     Unknown            0               29m
…
Die ConfigMap ist weg, der Restore hat gewirkt. Aber
db-0 hängt: Laut etcd hängt das Longhorn-Volume noch an dem
Node, auf dem db-0 vor dem Restore lief.
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n notes describe pod db-0 \
  | grep FailedAttachVolume
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n notes delete pod db-0
kubectl --kubeconfig "$LAB/kube/werk.yaml" -n notes wait --for=condition=Ready \
  pod/db-0 --timeout=300s
curl -s "http://notes.$WERK1.sslip.io/api/notes"; echo
Erwartet (gekürzt, die api braucht danach noch einige Minuten):
  Warning  FailedAttachVolume  8s  attachdetach-controller  Waiting for detach for …
"pvc-f51c8b9d-…" Volume is already exclusively attached to one node, waiting on de…
pod "db-0" deleted from notes namespace
pod/db-0 condition met
[{"id":"c0c70ff3-…","text":"aus dem eigenen Katalog"}]
db-0 kommt nach knapp einer Minute zurück; die api hat
sich derweil in einen langen Neustart-Backoff gesteigert und folgt nach
ein paar Minuten. Die Daten sind da: Ein etcd-Restore setzt
Kubernetes-Objekte zurück, nicht das Volume. Insgesamt war notes rund
zehn Minuten weg. Ein etcd-Restore ist ein Werkzeug für den Notfall,
nicht für Kleinigkeiten wie eine gelöschte ConfigMap.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
kubectl get backups.resources.cattle.io vor-dem-unfallErwartet: Status Completed.
NAME             LOCATION   TYPE       LATEST-BACKUP            …   STATUS
vor-dem-unfall   PV         One-time   vor-dem-unfall-…tar.gz   …   Completed
kubectl -n fleet-default get etcdsnapshots.rke.cattle.io -o custom-columns="$c"Erwartet: der Snapshot von werk1, successful.
NAME                                FILE                         SIZE       STATUS
werk-local-on-demand-werk1-17934…   on-demand-werk1-1793465612   43094048   successful
kubectl -n fleet-default get clusters.provisioning.cattle.io werk \
-o jsonpath='{.status.conditions[?(@.type=="Ready")].status}'; echoErwartet: True.
TrueChallenge
Ein einmaliges Backup hilft nur, wenn jemand daran denkt. Lass Rancher sich alle fünf Minuten sichern und nur die letzten drei Backups behalten.
Hinweis: Ein Backup kennt
schedule (Cron-Syntax) und retentionCount.
Lösung
cat > backup-zeitplan.yaml <<'EOF'
apiVersion: resources.cattle.io/v1
kind: Backup
metadata:
  name: alle-5-minuten
spec:
  resourceSetName: rancher-resource-set-basic
  schedule: "*/5 * * * *"
  retentionCount: 3
EOF
kubectl apply -f backup-zeitplan.yaml
kubectl get backups.resources.cattle.io
kubectl get backups.resources.cattle.io alle-5-minuten \
  -o jsonpath='{.status.nextSnapshotAt}'; echo
Erwartet (gekürzt, nach etwa einer halben Minute):
backup.resources.cattle.io/alle-5-minuten created
NAME             LOCATION   TYPE        LATEST-BACKUP                  …   STATUS
alle-5-minuten   PV         Recurring   alle-5-minuten-…-17-10-37Z.tar.gz   Completed
vor-dem-unfall   PV         One-time    vor-dem-unfall-…-16-49-15Z.tar.gz   Completed
2026-10-31T17:15:00Z
Ein wiederkehrendes Backup sichert sofort einmal und dann im Takt der Cron-Angabe. Ältere Dateien als die letzten drei löscht der Operator selbst. In Produktion ist ein täglicher Takt üblich, mit Ziel außerhalb des Clusters.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Ziel außerhalb: Backups und etcd-Snapshots gehören auf S3 oder einen anderen Speicher außerhalb der Cluster. Ein Backup auf dem Volume des Clusters, das gerade ausgefallen ist, hilft nicht.
- Verschlüsseln: Das volle ResourceSet enthält
Secrets. Ein
EncryptionConfiguration-Secret für den Operator verschlüsselt die Backups. - Rancher umziehen: Mit einem Backup lässt sich Rancher auf ein neues local-Cluster wiederherstellen, etwa nach einem Totalausfall. Die Doku beschreibt die Reihenfolge (cert-manager, Restore, dann Rancher-Chart).
- etcd automatisch: Im Cluster-Objekt legt
rkeConfig.etcdZeitplan und Aufbewahrung der Snapshots fest, wie in „Kubernetes zum Anfassen”, Tag 14, nur zentral. - Üben: Restore ist der Teil, der im Ernstfall nicht klappt, wenn ihn niemand geübt hat. Plane Restore-Tests fest ein.