Tag 12: Beobachten
Ziel: Kong mit Prometheus und Grafana überwachen, jede Anfrage als JSON protokollieren und mit OpenTelemetry sehen, wo die Zeit einer Anfrage bleibt. · Dauer: ca. 75 min · Voraussetzung: Tag 11
Briefing
- Metriken: Das Plugin
prometheuszählt Anfragen, Statuscodes und Latenzen; Kong liefert sie am Status-Port 8100 unter/metrics. - Logs: Plugins wie
file-log,http-logodersyslogschreiben pro Anfrage einen JSON-Eintrag mit Consumer, Service, Route und Latenzen. - Traces:
opentelemetryschickt Spans für Router, jedes Plugin, DNS und Backend an einen Collector, hier Jaeger. - Prometheus, Grafana und Jaeger laufen als eigenes Compose-Projekt im
Netz
lab.
 Kong :8100/metrics ◄── Prometheus :9090 ◄── Grafana :3000
 Kong ──OTLP :4318──► Jaeger :16686
 Kong ──file-log──► /tmp/zugriff.json
Drill 1: Kong für Traces vorbereiten
Spans erzeugt Kong nur, wenn Tracing eingeschaltet ist. Das ist eine Einstellung des Knotens, kein Plugin:
source ~/kong-lab/setup/env.sh
mkdir -p ~/kong-lab/tag12 && cd ~/kong-lab/kong
cp ~/kong-lab/code/tag12/compose.yaml compose.yaml
grep TRACING compose.yaml
docker compose up -d --wait
Erwartet (gekürzt):
      KONG_TRACING_INSTRUMENTATIONS: all     # Spans für OpenTelemetry (Tag 12)
      KONG_TRACING_SAMPLING_RATE: "1.0"
 Container kong-kong-1 Healthy
all misst Router, Plugins, DNS und Balancer.
1.0 heißt: jede Anfrage. In Produktion reichen oft wenige
Prozent.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Drei Plugins für alle Anfragen
cd ~/kong-lab/tag12
cp ~/kong-lab/code/tag12/beobachten.yaml .
grep -E 'name:|path|endpoint' beobachten.yaml
deck file add-plugins -s ~/kong-lab/kong/kong.yaml beobachten.yaml \
  -o ~/kong-lab/kong/kong.yaml
ksync 2>/dev/null | tail -3
Erwartet:
      - name: prometheus
      - name: file-log
          path: /tmp/zugriff.json
      - name: opentelemetry
          traces_endpoint: http://jaeger:4318/v1/traces
  Created: 3
  Updated: 0
  Deleted: 0
Fortschritt speichern? Kostenlos registrieren
Drill 3: Prometheus, Grafana, Jaeger
Das Dashboard „Kong (official)” holst du von grafana.com. Es erwartet eine Variable für die Datenquelle, die du durch die feste ID aus der Provisionierung ersetzt:
cp -R ~/kong-lab/code/observability ~/kong-lab/observability
cd ~/kong-lab/observability
grep image compose.yaml
curl -s https://grafana.com/api/dashboards/7424/revisions/11/download \
  -o grafana/dashboards/kong.json
jq -r .title grafana/dashboards/kong.json
sed -i 's/${DS_PROMETHEUS}/prometheus/g' grafana/dashboards/kong.json
docker compose up -d
sleep 15
curl -s localhost:9090/api/v1/targets | jq -r '.data.activeTargets[] | [.labels.job,
  .health] | @tsv'
Erwartet (gekürzt):
    image: prom/prometheus:v3.15.1
    image: grafana/grafana:13.2.5
    image: jaegertracing/jaeger:2.22.0
Kong (official)
 Container observability-grafana-1 Started
kong    up
Prometheus fragt kong:8100 alle 5 Sekunden ab
(prometheus.yml). Der Status-Port ist im Netz
lab erreichbar, nach außen nur auf
127.0.0.1.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Metriken lesen
Erzeug etwas Verkehr und sieh dir die Rohdaten an:
for i in $(seq 1 30); do
  curl -s -o /dev/null $PROXY/api/v1/version
  curl -s -o /dev/null -H 'apikey: lab-key-anna-456' $PROXY/whoami
done
curl -s localhost:8100/metrics | grep '^kong_http_requests_total'
curl -s localhost:8100/metrics \
  | grep -E '^kong_(datastore_reachable|upstream_target_health)'
Erwartet (gekürzt):
kong_http_requests_total{service="notes-version",route="notes-version",code="200",
source="service",workspace="default",consumer=""} 30
kong_http_requests_total{service="whoami",route="whoami",code="200",source="service",
workspace="default",consumer="anna"} 30
kong_datastore_reachable 1
kong_upstream_target_health{upstream="notes-up",target="notes-api-2:8080",address="172…
…
kong_upstream_target_health{…,target="notes-api:8080",…,state="healthy",…} 1
per_consumer: true zählt pro Consumer: anna ist
sichtbar. Und Prometheus kann rechnen:
sleep 8
Q='sum(kong_http_requests_total) by (service,code)'
curl -s localhost:9090/api/v1/query --data-urlencode "query=$Q" \
  | jq -r '.data.result[] | [.metric.service, .metric.code, .value[1]] | @tsv' | sort
Erwartet:
notes-version   200 30
whoami  200 30
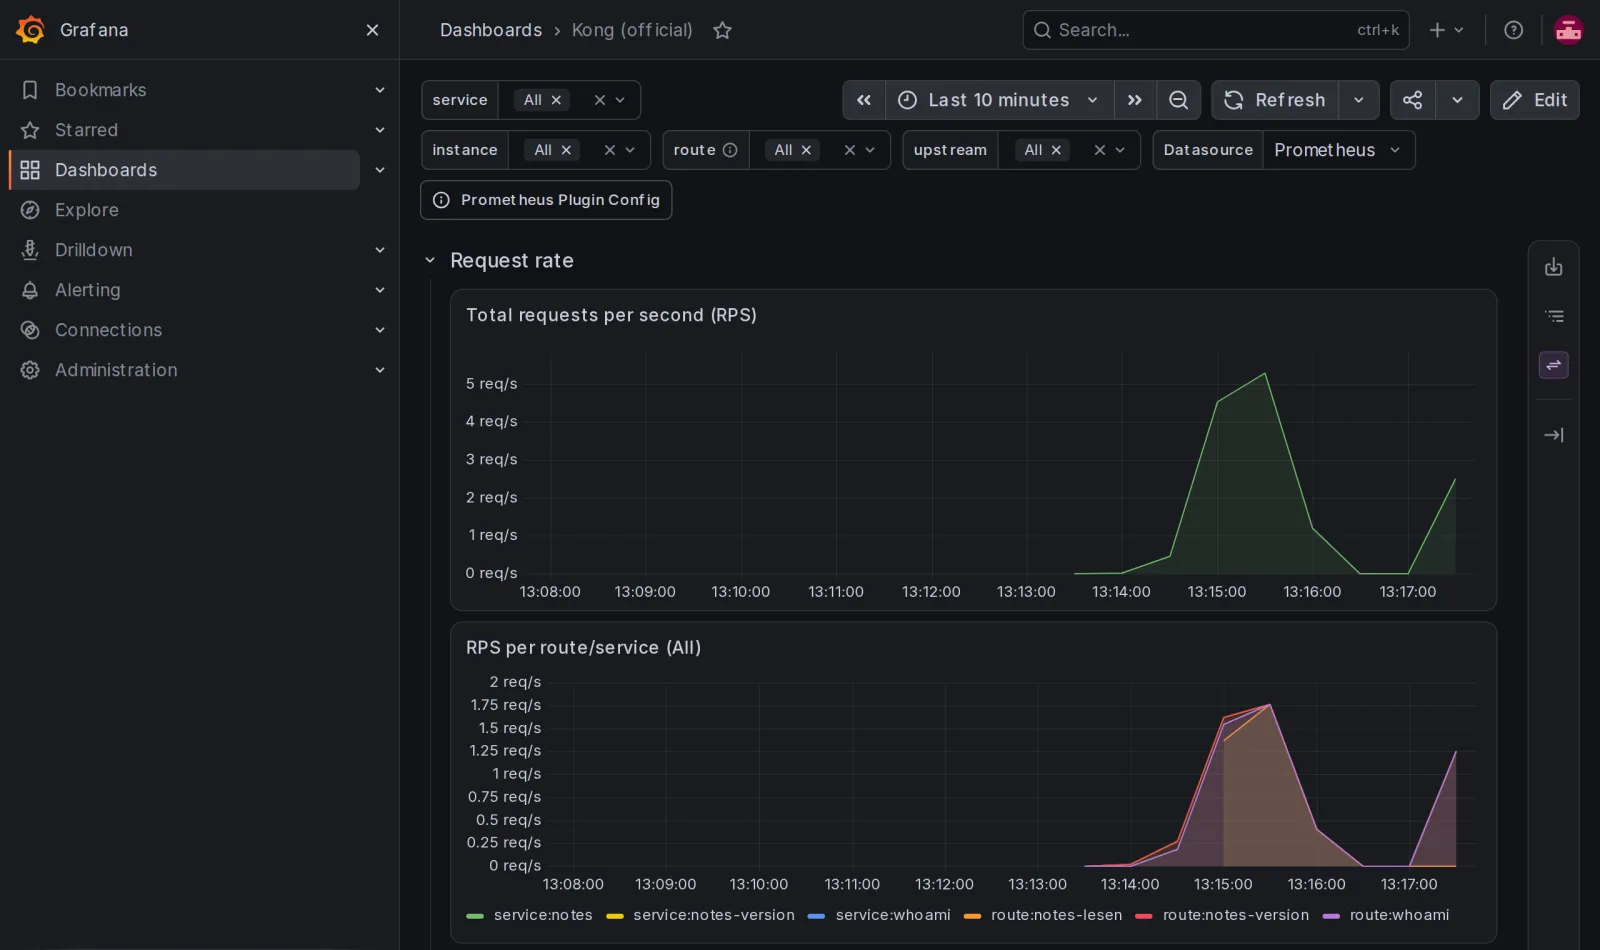
Öffne Grafana über den Tunnel (-L 3000:localhost:3000,
Benutzer admin, Passwort lab-admin-pw-123),
dann Dashboards, Kong (official) und
den Bereich Request rate:
Fortschritt speichern? Kostenlos registrieren
Drill 5: Eine Anfrage im Log
curl -s -o /dev/null -H 'apikey: lab-key-anna-456' $PROXY/whoami
docker compose -f ~/kong-lab/kong/compose.yaml exec kong tail -1 /tmp/zugriff.json \
  | jq '{methode: .request.method, uri: .request.uri, status: .response.status,
    consumer: .consumer.username, service: .service.name, latencies}'
Erwartet (gekürzt, Zeiten weichen bei dir ab):
{
  "methode": "GET",
  "uri": "/whoami",
  "status": 200,
  "consumer": "anna",
  "service": "whoami",
  "latencies": {
    "receive": 0,
    "request": 5,
    "kong": 3,
    "proxy": 2
  }
}
kong ist die Zeit in Kong selbst (Plugins),
proxy die im Backend, request die ganze
Anfrage. Steigt kong, liegt das Problem im Gateway; steigt
proxy, im Backend.
Sicherheit: Der vollständige Eintrag enthält auch die Header der Anfrage. Kong schwärzt
Authorizationundapikeynicht von selbst; prüf, was in deinen Logs landet, bevor sie an ein zentrales System gehen.
Fortschritt speichern? Kostenlos registrieren
Drill 6: Wo die Zeit bleibt
for i in 1 2 3; do
  curl -s -o /dev/null -H 'apikey: lab-key-anna-456' $PROXY/whoami
done
sleep 4
curl -s localhost:16686/api/v3/services | jq -c .
Erwartet:
{"services":["kong"]}Jaeger 2 bietet seine Abfrage-API unter /api/v3.
Bequemer ist die Oberfläche: Tunnel mit
-L 16686:localhost:16686, dann
http://localhost:16686, Service kong,
Find Traces und eine Anfrage an /whoami
mit Token öffnen.
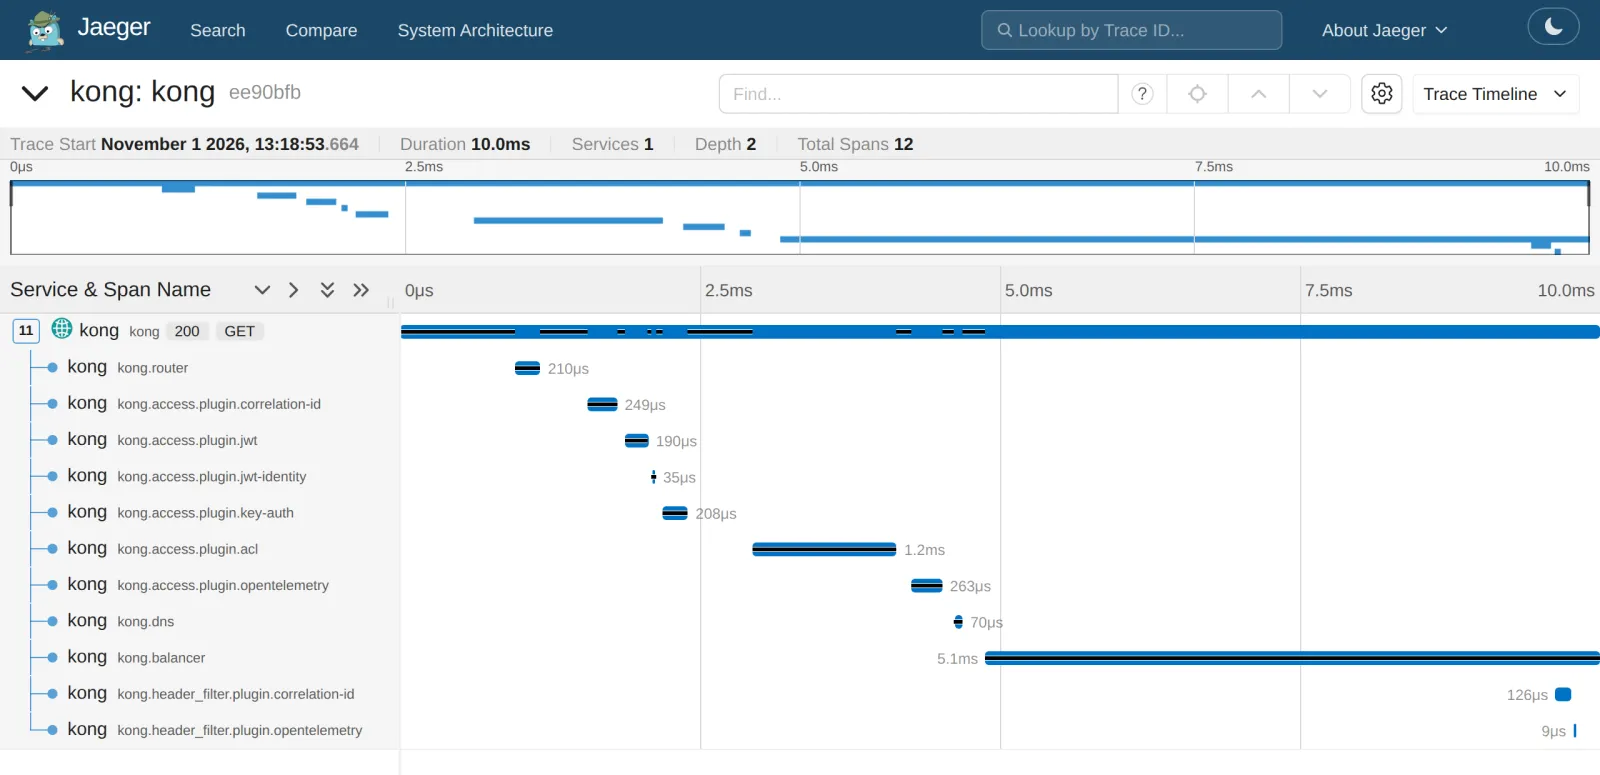
Jedes Plugin ist ein eigener Balken, auch dein
jwt-identity. Der längste Abschnitt ist
kong.balancer: Das ist die Zeit bis zur Antwort des
Backends.
Stand festhalten:
cd ~/kong-lab/kong
git add compose.yaml kong.yaml && git commit -qm "Tag 12: Metriken, Logs, Traces"
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
curl -s localhost:8100/metrics | grep -c '^kong_http_requests_total'Erwartet: mindestens zwei Zeitreihen.
2curl -s localhost:9090/api/v1/targets | jq -r '.data.activeTargets[0].health'Erwartet: Prometheus erreicht Kong.
upcurl -s localhost:16686/api/v3/services | jq -r '.services[0]'Erwartet: Jaeger kennt den Dienst kong.
kongChallenge
Wie viele Anfragen hat Kong seit dem Start mit einem Statuscode ab 400 beantwortet, aufgeteilt nach Code? Erzeug vorher ein paar Fehler.
Hinweis: kong_http_requests_total hat
ein Label code; PromQL kennt reguläre Ausdrücke mit
=~.
Lösung
for i in 1 2 3; do
  curl -s -o /dev/null $PROXY/whoami
  curl -s -o /dev/null $PROXY/api/v1/version/gibtsnicht
done
sleep 10
Q='sum(kong_http_requests_total{code=~"4.."}) by (code)'
curl -s localhost:9090/api/v1/query --data-urlencode "query=$Q" \
  | jq -r '.data.result[] | [.metric.code, .value[1]] | @tsv' | sort
Erwartet:
403 3
404 3
Ohne Schlüssel endet /whoami als gast und
scheitert an der ACL: 403, nicht 401 (Tag 6). Und
/api/v1/version/gibtsnicht reicht notes-api als 404 durch.
Für Alarme nimmst du statt der Summe seit dem Start die Rate, etwa
sum(rate(kong_http_requests_total{code=~"5.."}[5m])); sie
braucht aber einige Messpunkte, bevor sie etwas anzeigt.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Alarme: Prometheus-Regeln für Fehlerquote (5xx),
Latenz (p95 aus
kong_request_latency_ms),kong_datastore_reachable == 0und kranke Targets. - Logs zentral:
http-logan Loki, Elasticsearch oder einen Collector, mitcustom_fields_by_luazum Schwärzen und Anreichern. - Sampling: 100 % Traces kosten. Üblich sind wenige Prozent plus alle Fehler, oder Tail-Sampling im OpenTelemetry Collector.
- Konnect bringt Analytics mit; in OSS baust du das wie hier selbst.
- Kardinalität:
per_consumermit Tausenden Consumern bläht Prometheus auf; dann lieber über Logs auswerten.