Tag 9: Mehrere Alertmanager
Ziel: Eine zweite Umgebung
devmit eigenem Prometheus und Alertmanager kommt dazu. karma liest alle vier Alertmanager, fasst die drei Knoten von prod als Cluster zusammen und zeigt jeden Alarm nur einmal. · Dauer: ca. 50 min · Voraussetzung: Tag 8
Briefing
- Die Stärke von karma ist die Zusammenschau: viele
Alertmanager, ein Bildschirm. Jeder Eintrag unter
serversist ein Upstream. - Gleiche Alarme (gleiche Labels) aus mehreren Upstreams fasst karma zu einem zusammen (Deduplizierung). Am Alarm steht, wo er überall gefunden wurde.
- Upstreams, die zum selben HA-Cluster gehören, bekommen denselben
cluster-Namen. karma erkennt Cluster auch selbst, mitclustervergibst du lesbare Namen. - Der HA-Cluster teilt Silences und das Benachrichtigungs-Log, aber keine Alarme. Jeder Knoten kennt nur, was ihm geschickt wurde. Das zeigt sich heute.
 Prometheus (env=prod) ──► alertmanager, -2, -3 ─┐ cluster prod
 Prometheus-dev (env=dev) ──► alertmanager-dev ──┤ cluster dev
                                                 └──► karma :8000
Drill 1: Die Umgebung dev
Ein eigenes notes-api ohne Datenbank, mit eingebauter Fehlerquote, damit dev etwas zu melden hat. Dazu ein eigener Prometheus mit denselben Regeln und ein einzelner Alertmanager:
cd ~/am-lab
mkdir -p dev
cat > dev/prometheus.yml <<'EOF'
global:
  scrape_interval: 15s
  evaluation_interval: 15s
  external_labels:
    env: dev

rule_files:
  - /etc/prometheus/rules/*.yml

scrape_configs:
  - job_name: notes-api
    static_configs:
      - targets: ["notes-api-dev:8080"]

alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager-dev:9093"]
EOF
cat > dev/alertmanager.yml <<'EOF'
route:
  receiver: dev
  group_by: [alertname]

receivers:
  - name: dev
    webhook_configs:
      - url: http://alarm-log:5001/dev
EOF
external_labels: env: devunterscheidet die Alarme von prod, obwohl sie aus denselben Regeln stammen.- Der Alertmanager von dev ist bewusst schlicht: ein Receiver, alles dorthin.
Der Compose-Baustein:
cat > dev.yaml <<'EOF'
services:
  notes-api-dev:
    image: notes-api:0.8.0
    environment:
      NOTES_API_KEY: lab-api-key-123
      NOTES_ERROR_RATE: "0.2"

  last-dev:
    image: curlimages/curl:8.23.0
    entrypoint: ["sh", "-c"]
    command: ["while true; do curl -s -o /dev/null -m 5 http://notes-api-dev:8080/notes; sleep 1; done"]

  prometheus-dev:
    image: prom/prometheus:v3.16.0
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --web.external-url=http://${VM_IP}:9091
    volumes:
      - ./dev/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./prometheus/rules:/etc/prometheus/rules:ro
    ports:
      - "9091:9090"

  alertmanager-dev:
    image: prom/alertmanager:v0.35.0
    command:
      - --config.file=/etc/alertmanager/alertmanager.yml
      - --web.external-url=http://${VM_IP}:9096
      - --cluster.listen-address=
    volumes:
      - ./dev/alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
    ports:
      - "9096:9093"
EOF
echo "  - dev.yaml" >> compose.yaml
docker compose up -d- Ohne
NOTES_DB_URLhält notes-api die Notizen im Speicher. Für dev reicht das. - Die Regeln liest dev aus demselben Ordner wie prod. Eine Änderung gilt für beide.
docker compose up -derzeugt auch notes-api von prod neu, falls du in Tag 7 nochNOTES_ERROR_RATEgesetzt hattest. Die Fehlerquote in prod ist damit vorbei.
Nach gut drei Minuten feuert in dev die Fehlerquote:
amtool alert --alertmanager.url=http://localhost:9096Erwartet:
Alertname           Starts At                Summary                                             State
Watchdog            2026-11-16 20:24:18 UTC  Feuert immer. Fehlt er, ist die Alarmkette kaputt.  active
NotesHighErrorRate  2026-11-16 20:26:43 UTC  23.76% der Anfragen an /notes scheitern             active
Fortschritt speichern? Kostenlos registrieren
Drill 2: Vier Upstreams in karma
Ersetze in karma/karma.yaml den Abschnitt
alertmanager durch diesen:
alertmanager:
  interval: 30s
  servers:
    - name: prod-1
      cluster: prod
      uri: http://alertmanager:9093
      external_uri: http://172.16.0.61:9093
      timeout: 10s
      proxy: true
    - name: prod-2
      cluster: prod
      uri: http://alertmanager-2:9093
      external_uri: http://172.16.0.61:9094
      timeout: 10s
      proxy: true
    - name: prod-3
      cluster: prod
      uri: http://alertmanager-3:9093
      external_uri: http://172.16.0.61:9095
      timeout: 10s
      proxy: true
    - name: dev
      uri: http://alertmanager-dev:9093
      external_uri: http://172.16.0.61:9096
      timeout: 10s
proxy: true- Die Namen erscheinen in karma als
@alertmanager.prodheißt jetztprod-1. cluster: prodan allen drei Knoten. Ohne die Angabe erkennt karma den Cluster selbst und erzeugt einen Namen dafür. Der eigene Name liest sich besser.devhat keincluster. Ein einzelner Upstream bildet einen Cluster mit seinem eigenen Namen, hierdev.
docker compose restart karma
docker compose logs --no-log-prefix --since 20s karma | grep 'Configured Alertmanager'
Erwartet:
level=INFO msg="Configured Alertmanager source" name=prod-1 cluster=prod uri=http://alertmanager:9093 proxy=true readonly=false
level=INFO msg="Configured Alertmanager source" name=prod-2 cluster=prod uri=http://alertmanager-2:9093 proxy=true readonly=false
level=INFO msg="Configured Alertmanager source" name=prod-3 cluster=prod uri=http://alertmanager-3:9093 proxy=true readonly=false
level=INFO msg="Configured Alertmanager source" name=dev cluster=dev uri=http://alertmanager-dev:9093 proxy=true readonly=false
Und was karma von jedem Upstream geholt hat:
docker compose logs --no-log-prefix --since 20s karma | grep 'Deduplicating'Erwartet:
level=INFO msg="Deduplicating alert groups" alertmanager=dev groups=1
level=INFO msg="Deduplicating alert groups" alertmanager=prod-3 groups=4
level=INFO msg="Deduplicating alert groups" alertmanager=prod-2 groups=4
level=INFO msg="Deduplicating alert groups" alertmanager=prod-1 groups=8
prod-1 hat acht Gruppen, die beiden anderen nur vier.
Die Testalarme aus Tag 7 (PlatteVoll,
Werbeaktion) hast du mit amtool nur an Knoten
1 geschickt. Der Cluster hat sie nicht verteilt.
Öffne http://172.16.0.61:8000/?q=. Das leere
q= schaltet die Standardfilter aus Tag 8 für diesen Aufruf
ab.
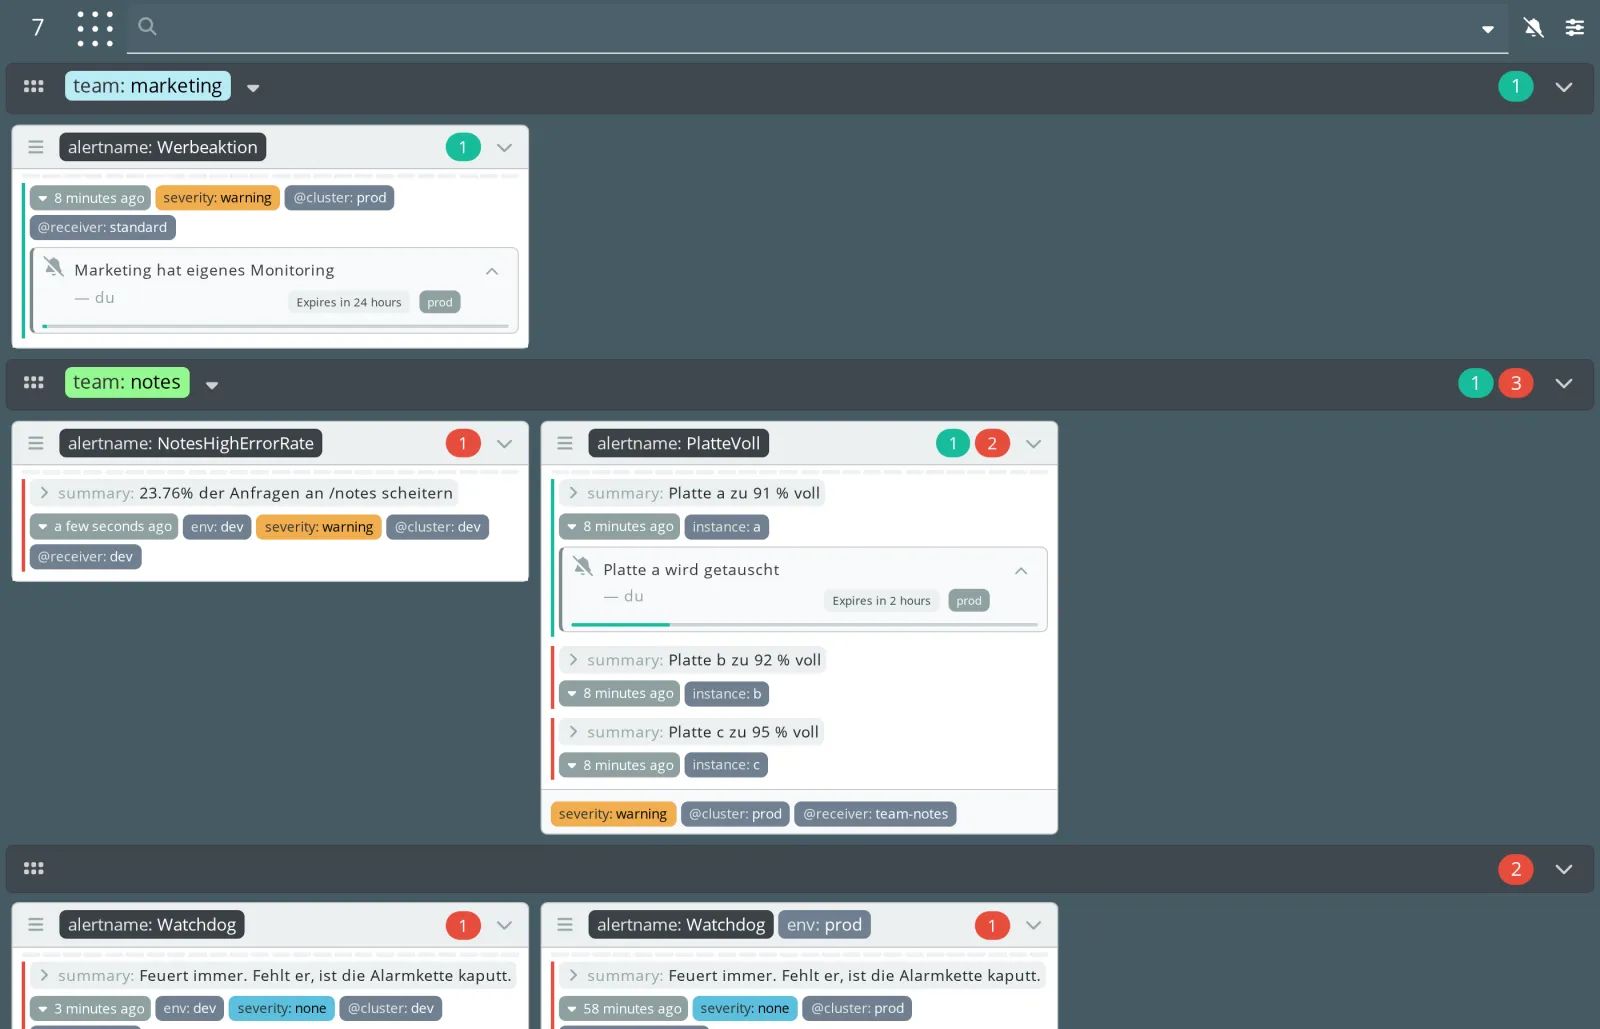
NotesHighErrorRatekommt jetzt aus dev, mitenv: devund@cluster: dev.- An Alarmen aus prod steht
@cluster: prod, egal von wie vielen Knoten sie kamen. - Silences tragen den Cluster als kleines Schild (
prod). Eine Silence gilt immer nur in dem Cluster, in dem sie angelegt wurde.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Wer kennt welchen Alarm?
Die Filter @alertmanager und @cluster
zeigen, woher ein Alarm kommt:
curl -s -G localhost:8000/counters.json --data-urlencode 'q=@cluster=prod' | jq .total
curl -s -G localhost:8000/counters.json --data-urlencode 'q=@alertmanager=prod-1' \
  | jq .total
curl -s -G localhost:8000/counters.json --data-urlencode 'q=@alertmanager=prod-2' \
  | jq .total
Erwartet:
5
5
1
Fünf Alarme in prod, alle fünf kennt prod-1.
prod-2 kennt nur einen: den Watchdog, den Prometheus an
alle drei Knoten schickt. Was passiert, wenn prod-1
ausfällt? Halte ihn an, dazu den Alertmanager von dev:
docker compose stop alertmanager alertmanager-devNach einer Minute sieht karma so aus:
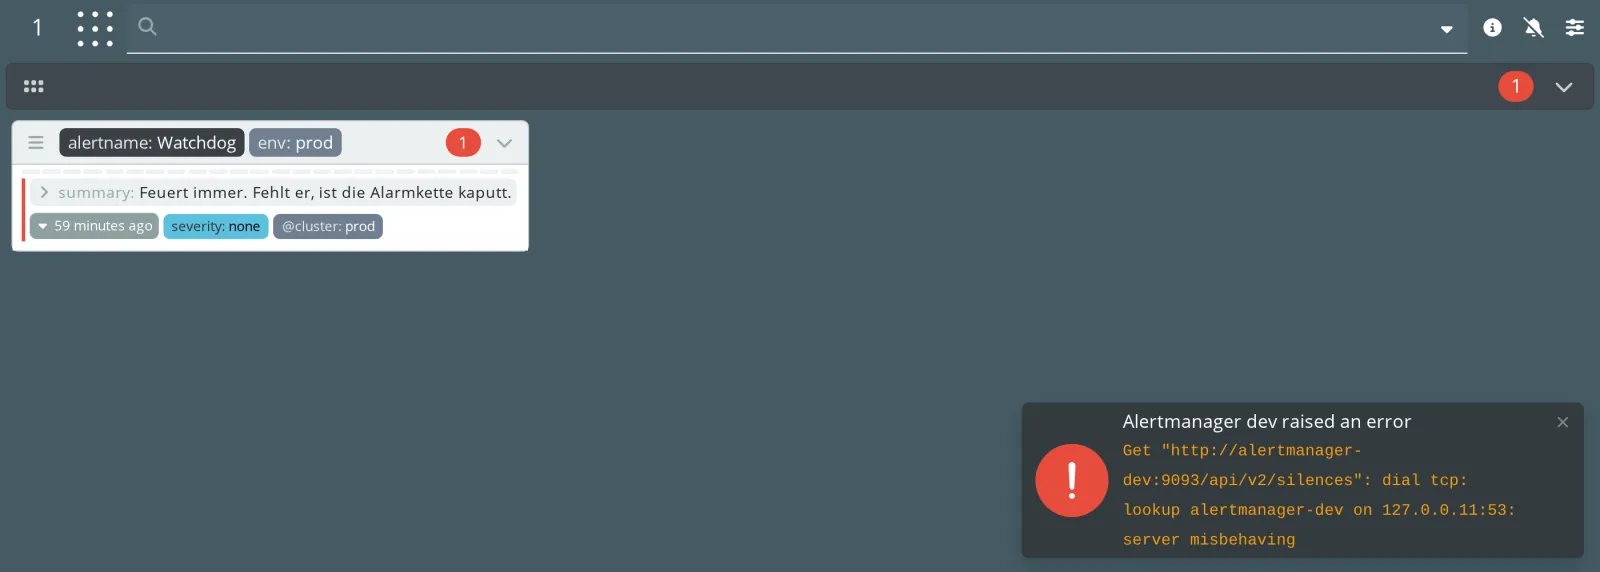
- Von prod bleibt nur der Watchdog. Alles, was nur
prod-1kannte, ist verschwunden. - Für dev zeigt karma unten rechts einen Fehler, oben erscheint ein Info-Symbol mit allen Fehlern.
- Für
prod-1erscheint keine Meldung als Kachel. Der Cluster lebt ja noch.
Die Metriken von karma sagen es genauer:
curl -s localhost:8000/metrics | grep '^karma_alertmanager_up'Erwartet:
karma_alertmanager_up{alertmanager="dev"} 0
karma_alertmanager_up{alertmanager="prod-1"} 0
karma_alertmanager_up{alertmanager="prod-2"} 1
karma_alertmanager_up{alertmanager="prod-3"} 1
Die Lehre aus dem Bild: Im HA-Betrieb muss jeder Absender
alle Knoten beliefern. Prometheus tut das, ein Skript
mit amtool an einen Knoten nicht. karma zeigt dir diesen
Fehler, sobald ein Knoten fehlt.
docker compose start alertmanager alertmanager-devNach dem Neustart kennt prod-1 die Testalarme aus Tag 7
nicht mehr. Der Alertmanager hält Alarme nur im Speicher, Prometheus
schickt seine eigenen nach spätestens einer Minute neu.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
curl -s localhost:8000/metrics | grep -c '^karma_alertmanager_up.* 1$'Erwartet: 4, alle Upstreams erreichbar.
curl -s -G localhost:8000/counters.json --data-urlencode 'q=@cluster=dev' | jq .totalErwartet: 2, Watchdog und Fehlerquote aus dev.
docker compose restart karma
docker compose logs --no-log-prefix --since 30s karma | grep -c 'Configured Alertmanager source'
Erwartet: 4, ein Upstream pro Zeile.
Challenge
Die Leitwarte will nicht mehr nach Team, sondern nach Cluster aufteilen: oben dev, darunter prod.
Hinweis: ui.multiGridLabel kennt neben
Label-Namen die Sonderwerte @alertmanager,
@cluster, @receiver und @auto.
YAML braucht für Werte mit @ Anführungszeichen.
Lösung
sed -i 's/  multiGridLabel: team/  multiGridLabel: "@cluster"/' karma/karma.yaml
grep multiGridLabel karma/karma.yaml
docker compose restart karma
Erwartet:
multiGridLabel: "@cluster"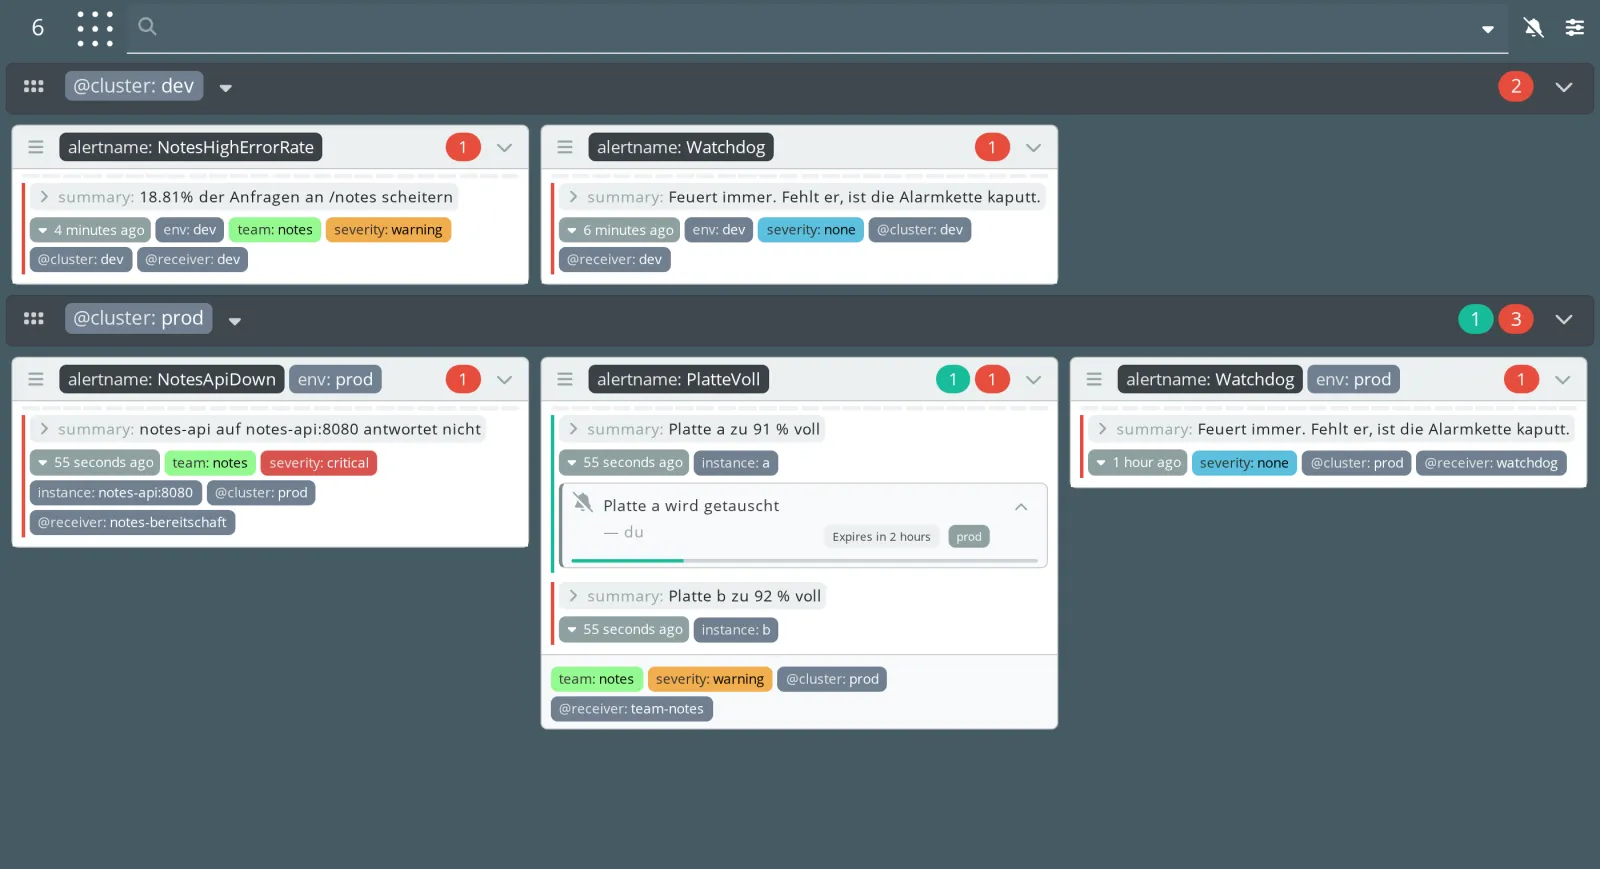
Die Raster stehen alphabetisch, dev vor
prod. Mit ui.multiGridSortReverse: true käme
prod nach oben.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Eine karma-Instanz für alle Umgebungen ist bequem. Sie ist aber auch ein Ziel, das alle Alertmanager lesen darf. Netz und Zugriff entsprechend absichern (Tag 11).
- Cluster-Namen in karma gleich den Umgebungsnamen wählen
(
prod,dev). Dann lesen sich Filter-URLs wie Sätze. karma_alertmanager_upgehört in Prometheus und auf einen Alarm. karma ist oft das Erste, worauf Menschen schauen. Fehlende Upstreams fallen sonst nicht auf.- Alarme, die nicht von Prometheus kommen (Skripte, Cronjobs, andere Systeme), immer an alle Knoten eines Clusters schicken.