Tag 2: Der Alertmanager
Ziel: Ein Alertmanager nimmt die Alarme von Prometheus an und schickt Benachrichtigungen an einen Webhook. Mit
amtoolsiehst du Alarme, prüfst die Konfiguration und löst Testalarme aus. · Dauer: ca. 50 min · Voraussetzung: Tag 1
Briefing
- Prometheus schickt jeden firing-Alarm etwa einmal pro Minute erneut an den Alertmanager. Der Alertmanager entscheidet, ob, wann und wohin daraus eine Benachrichtigung wird.
- Er gruppiert Alarme (
group_by), damit zehn kaputte Pods eine Nachricht ergeben und nicht zehn. Er routet sie an Receiver (Mail, Chat, Webhook) und verschickt am Ende eine resolved-Nachricht. - Stummschalten (Silences) und Unterdrücken (Inhibition) erledigt er auch. Das kommt an Tag 5.
- Als Empfänger dient im Lab alarm-log: ein kleiner Webhook-Empfänger aus dem Begleitcode, der jede Benachrichtigung als eine Zeile ins Log schreibt.
 Prometheus ── POST /api/v2/alerts ──► Alertmanager :9093 ── Webhook ──► alarm-log :5001
   (firing, jede Minute neu)           gruppieren · routen · warten      eine Zeile pro
                                                                         Benachrichtigung
Drill 1: amtool
amtool ist für den Alertmanager, was
promtool für Prometheus ist. Es liegt im Archiv des
Alertmanagers:
cd ~/am-lab
curl -fsSLO https://github.com/prometheus/alertmanager/releases/download/\
v0.35.0/alertmanager-0.35.0.linux-amd64.tar.gz
tar xzf alertmanager-0.35.0.linux-amd64.tar.gz
mv alertmanager-0.35.0.linux-amd64/amtool ~/.local/bin/
rm -r alertmanager-0.35.0.linux-amd64*
amtool --version 2>&1 | head -1
Erwartet:
amtool, version 0.35.0 (branch: HEAD, revision: 8cf67a8e75004bad6c3c6bacc829945cf8a3ee65)Damit du nicht bei jedem Aufruf --alertmanager.url
angeben musst:
mkdir -p ~/.config/amtool
cat > ~/.config/amtool/config.yml <<'EOF'
alertmanager.url: http://localhost:9093
EOF
Fortschritt speichern? Kostenlos registrieren
Drill 2: Der Empfänger alarm-log
Sieh dir das Werkzeug einmal an:
less code/alarm-log/alarm_log.py- 40 Zeilen Python ohne Abhängigkeiten. Jeder
POSTist eine Benachrichtigung des Alertmanagers, daraus wird eine Zeile: Uhrzeit, Pfad, Receiver, Status, Gruppen-Labels, Alarmnamen und wie viele davon firing und resolved sind. GET /liefert die letzte Benachrichtigung vollständig als JSON. So siehst du, was ein echter Empfänger wie ein Chat-Dienst bekäme.- Es läuft im offiziellen Python-Image, die Datei wird nur eingehängt.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Die Konfiguration
Die kleinste sinnvolle Konfiguration: eine Route, ein Receiver.
mkdir -p alertmanager
cat > alertmanager/alertmanager.yml <<'EOF'
route:
  receiver: alarm-log
  group_by: [alertname]

receivers:
  - name: alarm-log
    webhook_configs:
      - url: http://alarm-log:5001/
EOF
amtool check-config alertmanager/alertmanager.yml
Erwartet:
Checking 'alertmanager/alertmanager.yml'  SUCCESS
Found:
 - global config
 - route
 - 0 inhibit rules
 - 1 receivers
- 0 templatesrouteist die Wurzel des Routing-Baums. Jeder Alarm landet zuerst hier. Ohne Unter-Routen geht alles anreceiver: alarm-log.group_by: [alertname]fasst alle Alarme mit demselben Namen zu einer Gruppe zusammen. Eine Gruppe ergibt eine Benachrichtigung.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Alertmanager starten
cat > alerting.yaml <<'EOF'
services:
  alertmanager:
    image: prom/alertmanager:v0.35.0
    command:
      - --config.file=/etc/alertmanager/alertmanager.yml
      - --storage.path=/alertmanager
      - --web.external-url=http://${VM_IP}:9093
      - --cluster.listen-address=
    volumes:
      - ./alertmanager:/etc/alertmanager:ro
      - amdata:/alertmanager
    ports:
      - "9093:9093"

  alarm-log:
    image: python:3.14.10-alpine
    command: ["python", "-u", "/alarm_log.py"]
    volumes:
      - ./code/alarm-log/alarm_log.py:/alarm_log.py:ro
    ports:
      - "5001:5001"

volumes:
  amdata:
EOF
echo " - alerting.yaml" >> compose.yaml--storage.path: Hier speichert der Alertmanager Silences und das Benachrichtigungs-Log. Das Volumeamdatasorgt dafür, dass beides einen Neustart übersteht.--cluster.listen-address=mit leerem Wert schaltet den Cluster-Modus ab. Ohne den Schalter sucht ein einzelner Alertmanager nach Partnern. An Tag 6 schaltest du ihn bewusst ein.
Prometheus muss wissen, wohin es Alarme schickt:
cat >> prometheus/prometheus.yml <<'EOF'

alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager:9093"]
EOF
docker compose up -d
curl -s -X POST localhost:9090/-/reload
curl -s localhost:9090/api/v1/alertmanagers | jq -c '.data.activeAlertmanagers'
Erwartet:
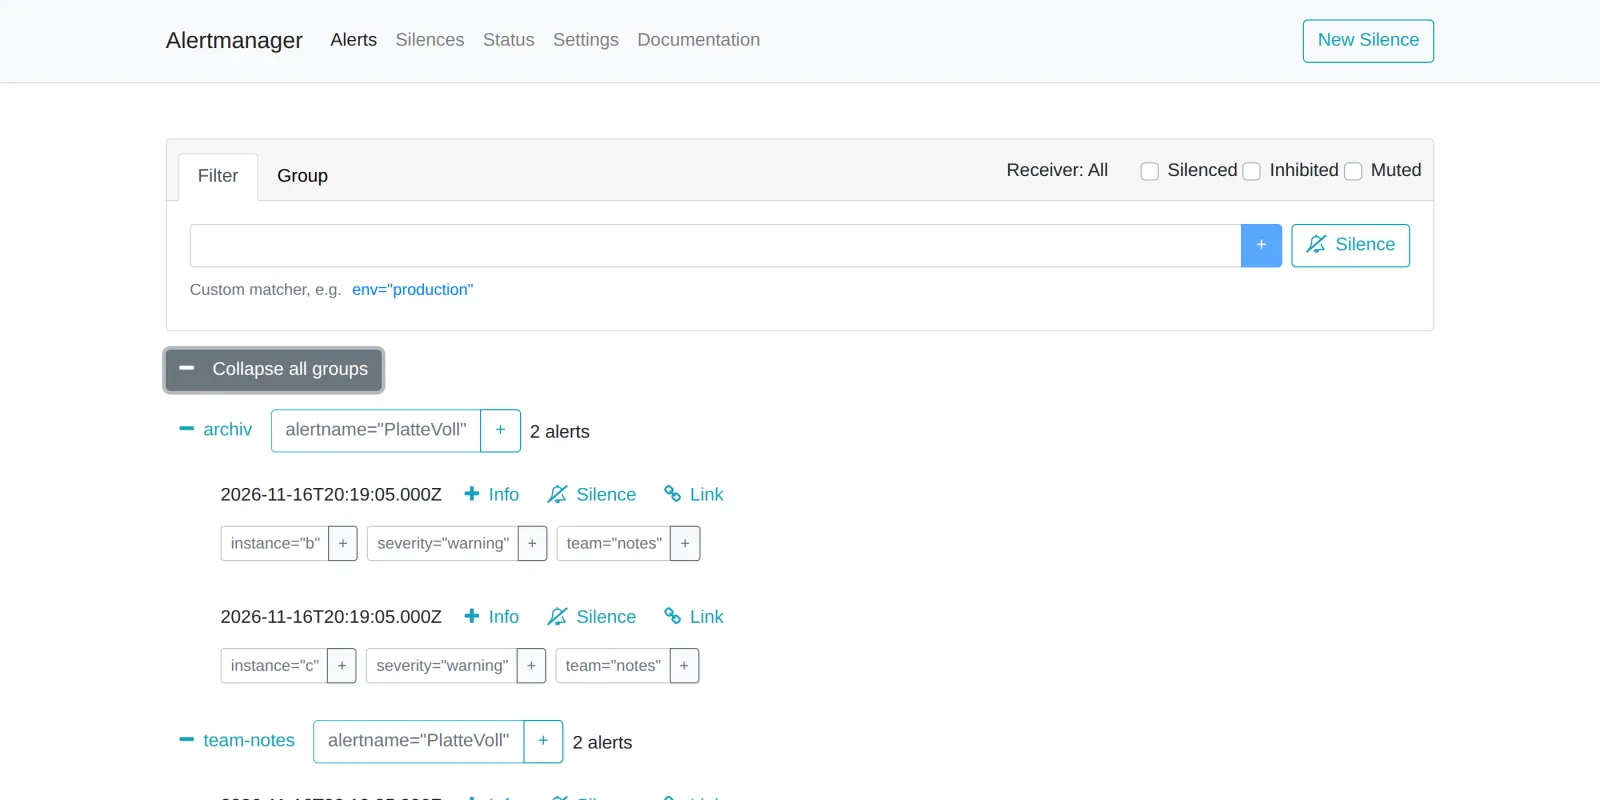
[{"url":"http://alertmanager:9093/api/v2/alerts"}]Prometheus spricht die API v2 des Alertmanagers. Die Weboberfläche
des Alertmanagers liegt unter http://172.16.0.61:9093. Sie
listet Alarme nach Receiver und Gruppe, kann filtern und Silences
anlegen. Für mehr als eine Handvoll Alarme wird sie schnell
unübersichtlich. Genau dafür gibt es ab Tag 7 karma.
Fortschritt speichern? Kostenlos registrieren
Drill 5: Die erste Benachrichtigung
docker compose stop notes-apiNach knapp zwei Minuten (eine Minute for, dazu
Auswertung und 30 Sekunden group_wait):
amtool alertErwartet:
Alertname     Starts At                Summary                                       State
NotesApiDown  2026-11-16 19:23:13 UTC  notes-api auf notes-api:8080 antwortet nicht  active
docker compose logs --no-log-prefix alarm-logErwartet:
19:23:43 / alarm-log firing [alertname=NotesApiDown] NotesApiDown (1 firing, 0 resolved)Zwischen Starts At (19:23:13) und der Benachrichtigung
(19:23:43) liegen genau 30 Sekunden. Das ist group_wait:
Der Alertmanager wartet nach dem ersten Alarm einer neuen Gruppe, ob
noch weitere dazukommen. Was kam beim Empfänger an?
curl -s localhost:5001 | jq .Erwartet (gekürzt):
{
  "receiver": "alarm-log",
  "status": "firing",
  "alerts": [
    {
      "status": "firing",
      "labels": {
        "alertname": "NotesApiDown",
        "env": "prod",
        "instance": "notes-api:8080",
        "job": "notes-api",
        "severity": "critical",
        "team": "notes"
      },
      "annotations": {
        "runbook_url": "https://wiki.example.com/runbooks/notes-api-down",
        "summary": "notes-api auf notes-api:8080 antwortet nicht"
      },
      "startsAt": "2026-11-16T19:23:13.784Z",
      "endsAt": "0001-01-01T00:00:00Z",
      "generatorURL": "http://172.16.0.61:9090/graph?g0.expr=up%7Bjob…",
      "fingerprint": "12201e3a4fb380a7"
    }
  ],
  "notification_reason": "first notification",
  "groupLabels": {
    "alertname": "NotesApiDown"
  },
  "commonLabels": { … },
  "commonAnnotations": { … },
  "externalURL": "http://172.16.0.61:9093",
  "version": "4",
  "groupKey": "{}:{alertname=\"NotesApiDown\"}",
  "truncatedAlerts": 0
}
env: prodist jetzt da. Prometheus hat dieexternal_labelsbeim Verschicken angehängt.generatorURLzeigt auf deine VM, dank--web.external-urlaus Tag 1.groupKeyidentifiziert die Gruppe:{}ist die Route (die Wurzel), dahinter die Gruppen-Labels.fingerprintist ein Hash über alle Labels. Gleiche Labels, gleicher Alarm.
Starte notes-api wieder:
docker compose start notes-apiDie resolved-Nachricht kommt nicht sofort. Der Alertmanager
verschickt Änderungen an einer Gruppe erst nach
group_interval, standardmäßig fünf Minuten. Nach dieser
Zeit:
docker compose logs --no-log-prefix alarm-log | tail -1Erwartet:
19:28:43 / alarm-log resolved [alertname=NotesApiDown] NotesApiDown (0 firing, 1 resolved)Fortschritt speichern? Kostenlos registrieren
Drill 6: Testalarme ohne Prometheus
Für die Routing-Übungen ab Tag 3 willst du nicht jedes Mal einen
Container anhalten. amtool kann selbst Alarme schicken:
amtool alert add alertname=Testalarm severity=info team=notes \
  --annotation='summary="Von Hand ausgelöst"'
amtool alert query alertname=Testalarm
Erwartet:
Alertname  Starts At                Summary             State
Testalarm 2026-11-16 19:09:15 UTC Von Hand ausgelöst active- Labels stehen als
name=wertdirekt hinteradd. - Werte mit Leerzeichen brauchen doppelte Anführungszeichen innerhalb
der einfachen. Ohne sie warnt
amtool, es habe auf den alten Matcher-Parser zurückgegriffen.
Wie lange lebt so ein Alarm?
amtool alert query alertname=Testalarm -o json | jq '.[0] | {startsAt, endsAt}'Erwartet:
{
  "startsAt": "2026-11-16T19:09:15.695Z",
  "endsAt": "2026-11-16T19:14:15.695Z"
}
Fünf Minuten, das ist resolve_timeout aus der globalen
Konfiguration. Prometheus schickt seine Alarme laufend neu und setzt
endsAt jedes Mal weiter in die Zukunft. Ein Alarm von Hand
bekommt keine Auffrischung und löst sich nach fünf Minuten selbst
auf.
amtool zeigt auch die Konfiguration, wie der
Alertmanager sie verstanden hat, mit allen Standardwerten:
amtool config routesErwartet:
Routing tree:
.
└── default-route  receiver: alarm-log
amtool config show gibt die ganze Konfiguration aus,
inklusive resolve_timeout: 5m und
send_resolved: true am Webhook.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
amtool check-config alertmanager/alertmanager.ymlErwartet: SUCCESS und 1 receivers.
curl -s localhost:9090/api/v1/alertmanagers | jq -c '.data.activeAlertmanagers'Erwartet: ein Eintrag mit
http://alertmanager:9093/api/v2/alerts.
docker compose logs --no-log-prefix alarm-logErwartet: mindestens eine Zeile firing und eine Zeile
resolved für NotesApiDown.
Challenge
Was passiert, wenn der Empfänger nicht erreichbar ist? Halte
alarm-log an, löse einen Testalarm aus und finde im Log und
in den Metriken des Alertmanagers, was er tut. Starte
alarm-log danach wieder. Kommt die Nachricht noch an?
Hinweis: Der Alertmanager hat selbst ein
/metrics. Suche nach
notification_requests.
Lösung
docker compose stop alarm-log
amtool alert add alertname=Empfaengertest severity=info
Nach gut 30 Sekunden:
docker compose logs --no-log-prefix alertmanager | tail -1Erwartet (umbrochen):
time=2026-11-16T19:20:33.347Z level=WARN source=retry_stage.go:174
msg="Notify attempt failed, will retry later" component=dispatcher
receiver=alarm-log integration=webhook[0]
aggrGroup="{}:{alertname=\"Empfaengertest\"}" attempts=1 reason=other
err="Post \"<redacted>\": dial tcp: lookup alarm-log on 127.0.0.11:53: server misbehaving"
curl -s localhost:9093/metrics | grep notification_requestsErwartet (gekürzt):
alertmanager_notification_requests_failed_total{integration="webhook"} 9
alertmanager_notification_requests_total{integration="webhook"} 21
Der Alertmanager versucht es mit wachsenden Abständen erneut. Die URL schwärzt er im Log, weil Webhook-URLs oft Tokens enthalten. Jetzt den Empfänger wieder starten:
docker compose start alarm-logNach höchstens einer Minute:
docker compose logs --no-log-prefix alarm-log | tail -1Erwartet:
19:20:54 / alarm-log firing [alertname=Empfaengertest] Empfaengertest (1 firing, 0 resolved)Die Nachricht kommt an. Der Alertmanager gibt erst auf, wenn bis zur
nächsten Runde (group_interval) kein Versuch geklappt hat.
Erst dann zählt alertmanager_notifications_failed_total.
Auf genau diese Metrik gehört ein Alarm, aber nicht über denselben Weg,
der gerade kaputt ist.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
alertmanager_notifications_failed_totalgehört in jedes Monitoring des Monitorings. Der Alarm darauf braucht einen zweiten Weg, etwa einen anderen Receiver.- Webhook-URLs mit Tokens (Slack, Teams) gehören nicht in Git. Der
Alertmanager kann sie mit
url_fileaus einer Datei lesen. --web.external-urlimmer setzen, bei Prometheus wie beim Alertmanager. Sonst führen die Links in jeder Benachrichtigung ins Leere.- Testalarme per
amtool alert addsind ein gutes Werkzeug, um nach jeder Konfigurationsänderung die Kette bis zum Empfänger zu prüfen.