Tag 10: Wenn ein Node ausfällt
Ziel: Du wartest einen Node ohne Datenverlust, liest die Zeitleiste eines Absturzes und holst eine Datenbank zurück, deren Node nicht wiederkommt. · Dauer: ca. 75 min · Voraussetzung: Tag 9
Briefing
- Geplante Wartung: Pods weg (
drain), Controller abgeben (evict), neu starten, warten bis--faultyleer ist, Node freigeben (uncordon). - Absturz mit schnellem Neustart: heilt sich selbst. Die meiste Zeit kostet das Warten auf den CSI-Treiber.
- Node bleibt weg: Kubernetes startet
pg-0nicht woanders, solange niemand bestätigt, dass der alte Node tot ist. Diese Bestätigung ist das Out-of-Service-Taint. - Das Messgerät aus Tag 8 (
pg-client) zeigt jede Schreibpause auf die Sekunde.
 Wartung:   drain -> evict -> reboot -> --faulty leer -> uncordon
 Absturz:   weg -> Boot -> CSI registriert -> Mount -> PostgreSQL startet
 Bleibt weg: NotReady -> 5 min -> Terminating (hängt) -> Taint -> neuer Pod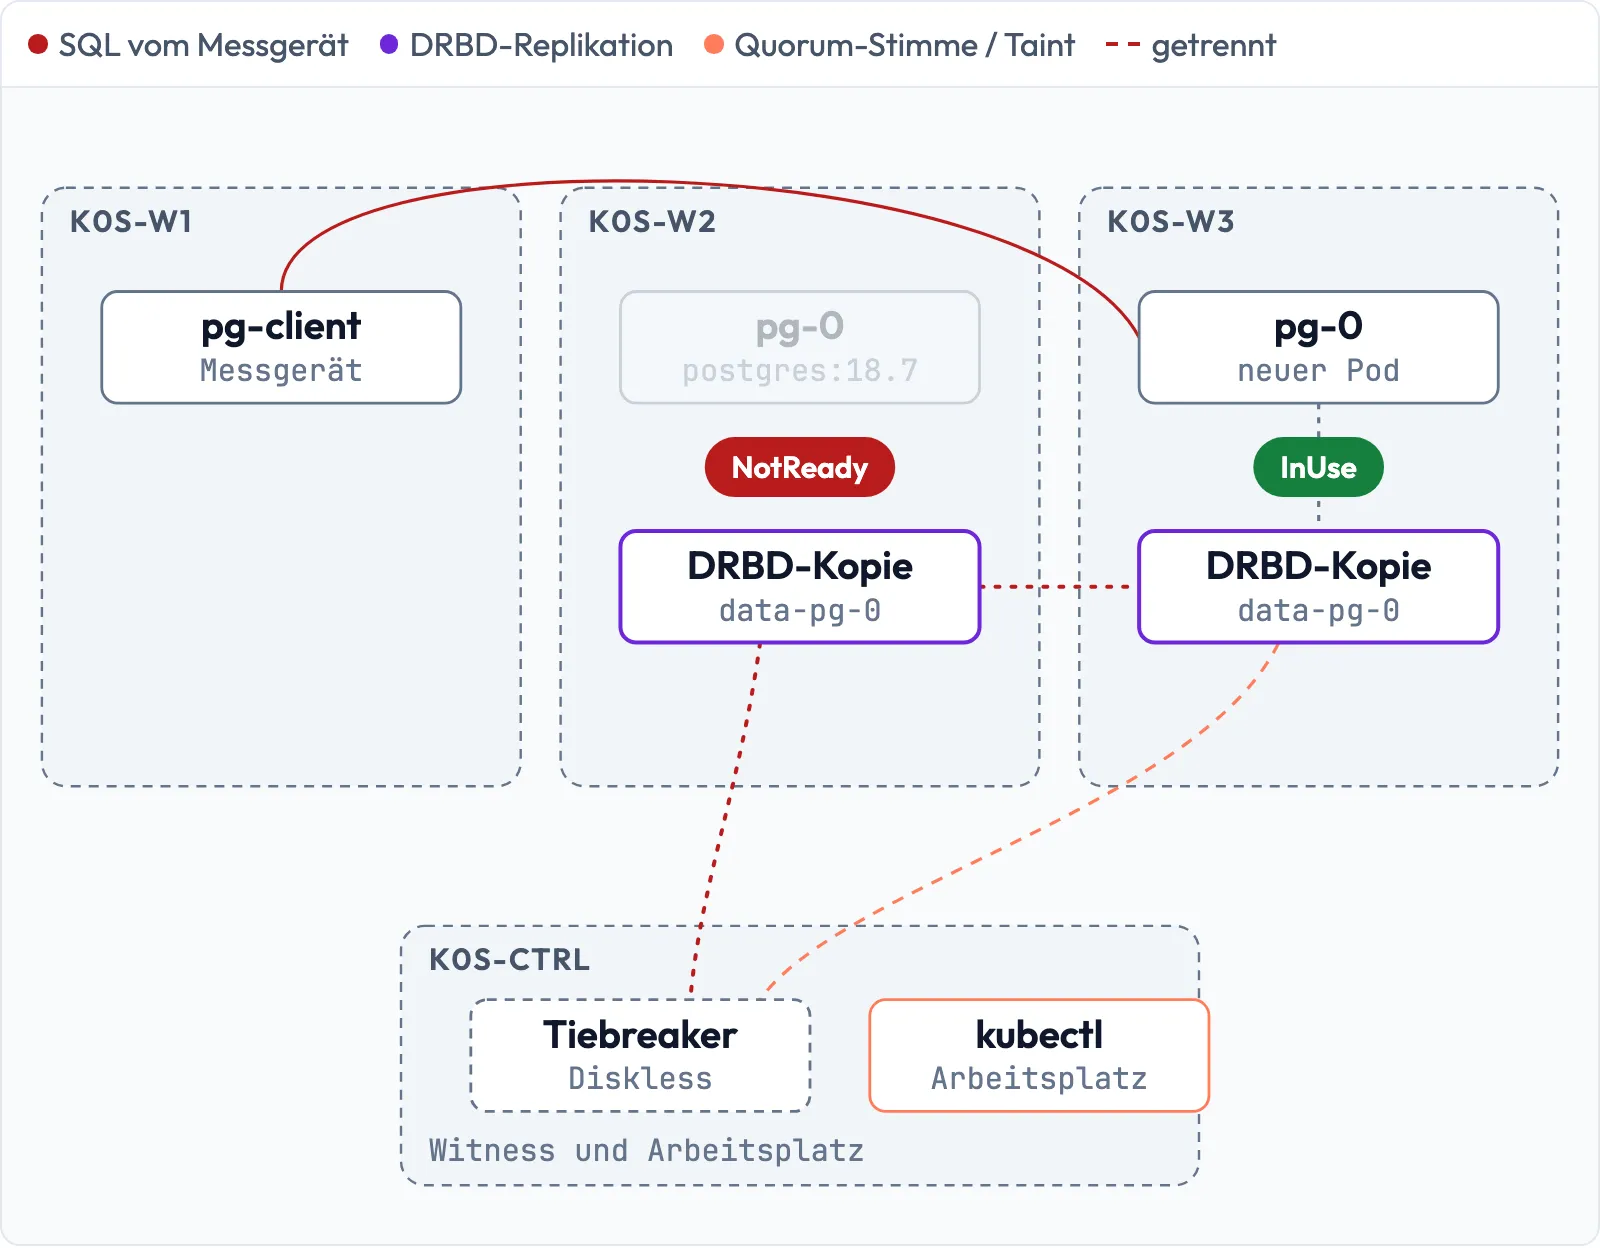
Drill 1: Das Lagebild
Vor jedem Eingriff klärst du drei Fragen: Wo läuft die Datenbank, wo liegen ihre Kopien, wo läuft der LINSTOR-Controller? Feste Annahmen helfen nicht – der Controller wandert bei jedem Failover.
# auf k0s-ctrl
mkdir -p ~/k0s-lab/tag10 && cd ~/k0s-lab/tag10
R=$(kubectl -n demo get pvc data-pg-0 -o jsonpath='{.spec.volumeName}')
kubectl -n demo get pod -o wide | cut -c1-90
linstor --no-utf8 --no-color resource list -r $R | cut -c44-110
for h in k0s-w1 k0s-w2 k0s-w3; do
  echo "$h: $(ssh $h sudo drbd-reactorctl status linstor_db | sed -n 2p)"
done
Erwartet (gekürzt):
NAME                         READY   STATUS    RESTARTS   AGE   IP            NODE
pg-0                         1/1     Running   0          14m   10.244.0.12   k0s-w3
pg-client-5b5b6d6bfd-98zm6   1/1     Running   0          15m   10.244.1.8    k0s-w2
...
| k0s-ctrl | DRBD,STORAGE            | Unused | Ok    | Diskless |
| k0s-w2   | DRBD,WRITECACHE,STORAGE | Unused | Ok    | UpToDate |
| k0s-w3   | DRBD,WRITECACHE,STORAGE | InUse  | Ok    | UpToDate |
k0s-w1: Promoter: Resource linstor_db currently active on this node
k0s-w2: Promoter: Resource linstor_db currently active on node 'k0s-w1'
k0s-w3: Promoter: Resource linstor_db currently active on node 'k0s-w1'
Bei dir können die Nodes anders verteilt sein. Ersetze in den
folgenden Drills die Namen durch deine: „der Node mit
pg-0“, „der Node mit dem Controller“.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Geplante Wartung
Der Node mit pg-0 soll neu starten. Schneide das
Messgerät mit, in einem zweiten Terminal oder im Hintergrund.
k0s-w1 sperrst du vorher mit cordon: Sonst
darf der Scheduler pg-0 auch dort starten, auf einem Node
ohne Kopie (diskless, Tag 8) – im Labor geschah genau das. So zieht die
Datenbank auf k0s-w2, den Node mit der zweiten Kopie:
# auf k0s-ctrl
kubectl -n demo logs -f deploy/pg-client --since=1s > puls-wartung.log &
kubectl cordon k0s-w1
kubectl drain k0s-w3 --ignore-daemonsets --delete-emptydir-data
ssh k0s-w3 'sudo drbd-reactorctl status linstor_db | sed -n 2p'
Erwartet (gekürzt):
node/k0s-w1 cordoned
...
evicting pod demo/pg-0
pod/pg-0 evicted
...
node/k0s-w3 drained
Promoter: Resource linstor_db currently active on node 'k0s-w1'
Der Controller läuft nicht hier, evict ist nicht nötig.
Liefe er hier, gäbst du ihn jetzt mit
sudo drbd-reactorctl evict linstor_db ab (Tag 6) und
wartest, bis linstor node list wieder antwortet. Jetzt der
Neustart:
# auf k0s-ctrl
ssh k0s-w3 'sudo systemctl reboot'
linstor --no-utf8 --no-color node list | grep k0s-w3
linstor --no-utf8 --no-color resource list --faulty | grep -c '| k0s'
Erwartet (ca. 30 s nach dem Neustart):
| k0s-w3   | LINUX    | SATELLITE | 10.10.0.13:3366 (PLAIN)   | OFFLINE |
7
Alle sieben Zeilen beider Ressourcen (linstor_db und
data-pg-0) gelten als fehlerhaft, solange ein Partner
fehlt.
Wiederhole die beiden linstor-Befehle, bis
k0s-w3 Online ist und 0 kommt. Im
Labor dauerte das vom reboot an gut zwei Minuten (2:11),
gemessen in einem späteren Lauf mit den Monitoring-Pods aus Tag 17 – an
Tag 10 geht das Herunterfahren schneller:
| Abschnitt | Dauer |
|---|---|
| Herunterfahren: das kubelet beendet die Pods geordnet (Tag 2), dann systemd | 43 s |
Boot bis k0sworker und linstor-satellite
laufen |
46 s |
Node in Kubernetes wieder Ready |
22 s |
Satellite Online (Java-Start, Abgleich mit dem
Controller) |
17 s |
Resync, bis --faulty leer ist |
3 s |
Die Teilzeiten liest du nachher auf dem Node selbst:
journalctl -b -1 -n1 (letzte Zeile vor dem Neustart) und
systemctl show -p ActiveEnterTimestamp linstor-satellite.
Achtung: Direkt nach
rebootzeigt LINSTOR noch bis zu gut einer MinuteOnlineund--faultyleer – der Node fährt erst geordnet herunter. Prüfe mitssh k0s-w3 uptime -s, dass er wirklich neu gestartet ist, bevor du den nächsten Node anfasst.
# auf k0s-ctrl
kubectl uncordon k0s-w1 k0s-w3
grep -c FEHLER puls-wartung.log
Erwartet:
node/k0s-w1 uncordoned
node/k0s-w3 uncordoned
5
Die fünf Fehler (knapp 15 s) stammen vom Umzug von pg-0
auf k0s-w2 beim drain, nicht vom Neustart: Der
Pod wartet, bis das Volume auf dem alten Node gelöst ist. Eine Datenbank
mit einer Instanz hat bei jedem Drain eine kurze Pause.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Das Messgerät in Sicherheit bringen
Für die nächsten Versuche darf pg-client nicht auf dem
Node laufen, den es trifft. Sieh nach, wo die beiden Pods jetzt
stehen:
# auf k0s-ctrl
kill %1
kubectl -n demo get pod -o wide | cut -c1-90
Erwartet (gekürzt):
pg-0                         1/1     Running   0          3m39s   10.244.1.11   k0s-w2
pg-client-5b5b6d6bfd-98zm6   1/1     Running   0          19m     10.244.1.8    k0s-w2
Beide auf k0s-w2. Sperr kurz die anderen Nodes und lass
den Client neu planen:
# auf k0s-ctrl
kubectl cordon k0s-w2 k0s-w3
kubectl -n demo delete pod -l app=pg-client
kubectl -n demo rollout status deploy/pg-client
kubectl uncordon k0s-w2 k0s-w3
kubectl -n demo get pod -l app=pg-client -o wide | cut -c1-90
Erwartet (gekürzt):
deployment "pg-client" successfully rolled out
...
pg-client-5b5b6d6bfd-r2ck8   1/1     Running   0          32s     10.244.2.8    k0s-w1
Fortschritt speichern? Kostenlos registrieren
Drill 4: Ein Absturz
Jetzt stürzt der Node mit pg-0 ab, ohne
Herunterfahren:
Achtung:
bin/proc/sysrq-triggerstartet den Host sofort neu, ohne Sync und ohne Rückfrage. Nur im Labor und nur auf dem Node, den du meinst.
# auf k0s-ctrl
kubectl -n demo logs -f deploy/pg-client --since=1s > puls-absturz.log &
ssh k0s-w2 'date +%T; echo b | sudo tee /proc/sysrq-trigger'
Die SSH-Sitzung hängt danach – beende sie mit Strg+C. Nach etwa drei Minuten:
# auf k0s-ctrl
kubectl -n demo get events --field-selector involvedObject.name=pg-0 \
  --sort-by=.lastTimestamp \
  -o custom-columns=ZEIT:.lastTimestamp,GRUND:.reason,MELDUNG:.message \
  | tail -8 | cut -c12-88
kubectl -n demo get events \
  --field-selector involvedObject.name=pg-0,reason=FailedMount \
  -o jsonpath='{.items[-1:].count} {.items[-1:].message}' | fold -w 80
Erwartet (gekürzt):
07:36:00Z   NodeNotReady             Node is not ready
07:36:15Z   TaintManagerEviction     Cancelling deletion of Pod demo/pg-0
07:36:46Z   FailedMount              MountVolume.MountDevice failed for volum
07:37:21Z   SandboxChanged           Pod sandbox changed, it will be killed a
07:37:23Z   Pulled                   Container image "postgres:18.7" already
07:37:23Z   Created                  Container created
07:37:24Z   Started                  Container started
7 MountVolume.MountDevice failed for volume "pvc-11dccaf7-..." : kubernetes.io/c
si: attacher.MountDevice failed to create newCsiDriverClient: driver name linsto
r.csi.linbit.com not found in the list of registered CSI drivers
TaintManagerEviction mit
Cancelling deletion heißt: Kubernetes hatte die Räumung des
Pods schon vorgemerkt (Taint not-ready) und bricht sie ab,
weil der Node zurück ist. Der Mount scheitert siebenmal, weil der
CSI-Treiber auf k0s-w2 noch nicht registriert ist. Sein
Init-Container linstor-wait-node-online wartet, bis der
Satellite in LINSTOR Online ist – der Satellite bremst also
auch den Mount:
# auf k0s-ctrl
P=$(kubectl -n piraeus-datastore get pod -o wide | awk '/csi-node.*k0s-w2/{print $1}')
kubectl -n piraeus-datastore get pod $P -o custom-columns=\
INIT:.status.initContainerStatuses[0].name,\
FERTIG:.status.initContainerStatuses[0].state.terminated.finishedAt
Erwartet:
INIT                       FERTIG
linstor-wait-node-online   2026-11-20T07:36:40Z
Die Zeitleiste aus dem Labor:
| Zeit | Ereignis |
|---|---|
| 07:35:12 | Absturz, ab 07:35:16 meldet das Messgerät FEHLER |
| 07:35:53 | k0s-w2 ist gebootet, k0sworker und
Satellite starten |
| 07:36:00 | Kubernetes merkt es erst jetzt: NodeNotReady |
| 07:36:34 | Satellite Online, 07:36:47 CSI-Treiber registriert |
| 07:37:18 | nächster Mount-Versuch nach Backoff des kubelets, klappt |
| 07:37:24 | PostgreSQL startet, ab 07:37:30 wieder ok |
Gut zwei Minuten Ausfall (138 s), keine Handarbeit, kein
Datenverlust. 31 Sekunden davon kostet allein das Backoff (07:36:47 bis
07:37:18): Das kubelet wartet nach jedem gescheiterten Mount länger.
Kubernetes hat den Pod nicht verschoben, weil der Node vor Ablauf der
fünf Minuten zurück war. DRBD hat derweil die Kopie auf
k0s-w2 nachgezogen:
# auf k0s-ctrl
kill %1
ssh k0s-w2 "sudo journalctl -k -b | grep -E 'resync-finished' | head -1 | cut -c1-110"
linstor --no-utf8 --no-color resource list --faulty | cut -c1-70
Erwartet (gekürzt):
Nov 20 07:36:37 k0s-w2 kernel: drbd pvc-11dccaf7-.../0 drbd1001: disk( Inconsistent ->
+-------------------------------------------------------------+
| ResourceName | Node | Layers | Usage | Conns | State | Vote |
|=============================================================|
+-------------------------------------------------------------+
Fortschritt speichern? Kostenlos registrieren
Drill 5: Ein Node, der nicht zurückkommt
Der schwerste Fall: Der Node mit pg-0 ist weg und bleibt
weg, etwa wegen eines defekten Netzteils. Ohne Zugriff auf den
Hypervisor stellst du das mit einer Firewall nach: Der Node verliert
jedes Netz, nur SSH vom Arbeitsplatz bleibt. Für den Cluster ist das
dasselbe wie ein ausgeschalteter Node. Ein Timer holt das Netz nach 30
Minuten sicher zurück. Starte vorher auf k0s-ctrl wieder
den Mitschnitt (… > puls-weg.log &).
Achtung: Die beiden
ACCEPT-Regeln für SSH von172.16.0.176müssen vor denDROP-Regeln stehen. Fehlen sie oder stimmt die Adresse nicht, sperrst du dich aus, bis der Timer nach 30 Minuten das Netz zurückholt.
# auf k0s-w2
sudo systemd-run --unit=netz-zurueck --on-active=30min iptables -t raw -F
sudo iptables -t raw -A PREROUTING -s 172.16.0.176 -p tcp --dport 22 -j ACCEPT
sudo iptables -t raw -A PREROUTING ! -i lo -j DROP
sudo iptables -t raw -A OUTPUT -d 172.16.0.176 -p tcp --sport 22 -j ACCEPT
sudo iptables -t raw -A OUTPUT ! -o lo -j DROP
Die Tabelle raw greift vor den Regeln von kube-router.
Nach 30 Sekunden:
# auf k0s-ctrl
ssh k0s-w2 "sudo drbdsetup status --verbose $R | head -1"
ssh k0s-w3 "sudo drbdadm status $R"
Erwartet:
pvc-11dccaf7-... node-id:1 role:Primary suspended:quorum
pvc-11dccaf7-... role:Secondary
  disk:UpToDate open:no
  k0s-ctrl role:Secondary
    peer-disk:Diskless peer-client:yes
  k0s-w2 connection:Connecting
Der isolierte Primary hat kein Quorum mehr und hält alle
Schreibvorgänge an. k0s-w3 hätte mit der Witness die
Mehrheit – aber niemand benutzt das Volume dort. Nach sechs Minuten:
# auf k0s-ctrl
kubectl get node k0s-w2 | cut -c1-19
kubectl -n demo get pod pg-0 -o wide | cut -c1-90
Erwartet (gekürzt):
NAME     STATUS
k0s-w2   NotReady
NAME   READY   STATUS        RESTARTS      AGE   IP            NODE
pg-0   1/1     Terminating   1 (10m ago)   15m   10.244.1.82   k0s-w2
Nach fünf Minuten (tolerationSeconds: 300) markiert
Kubernetes den Pod zum Löschen. Löschen kann ihn nur das kubelet auf
k0s-w2 – und das ist nicht erreichbar. Das StatefulSet
startet keinen Ersatz: Zwei pg-0 darf es nie geben, und
Kubernetes weiß nicht, ob die alte Instanz noch schreibt.
Fortschritt speichern? Kostenlos registrieren
Drill 6: Das Out-of-Service-Taint
Die Bestätigung „dieser Node ist tot“ gibst du mit einem Taint:
Achtung: Setze das Taint nur, wenn der Node sicher aus ist (Hypervisor, IPMI, Rechenzentrum). Lebt er noch, schützt dich DRBD-Quorum vor doppeltem Schreiben, aber die Anwendung dort bekommt I/O-Fehler (Tag 11).
# auf k0s-ctrl
kubectl taint node k0s-w2 node.kubernetes.io/out-of-service=nodeshutdown:NoExecute
kubectl -n demo wait --for=condition=Ready pod/pg-0 --timeout=180s
kubectl -n demo get pod pg-0 -o wide | cut -c1-90
linstor --no-utf8 --no-color resource list -r $R | cut -c44-120
Erwartet (gekürzt):
node/k0s-w2 tainted
pod/pg-0 condition met
pg-0   1/1     Running   0          6s    10.244.0.77   k0s-w3
...
| k0s-ctrl | DRBD,STORAGE            | Unused | Connecting(k0s-w2) | Diskless
| k0s-w2   | DRBD,WRITECACHE,STORAGE |        |                    |  Unknown
| k0s-w3   | DRBD,WRITECACHE,STORAGE | InUse  | Connecting(k0s-w2) | UpToDate
15 Sekunden nach dem Taint lief die Datenbank auf
k0s-w3, mit allen Daten. Hier landete sie auf dem Node mit
der zweiten Kopie. Wählt der Scheduler einen Node ohne Kopie, hängt
LINSTOR das Volume dort diskless an (Tag 8) – es läuft, aber jeder
Zugriff geht übers Netz.
# auf k0s-ctrl
kubectl get pods -A --field-selector spec.nodeName=k0s-w2 | cut -c1-60
Erwartet:
NAMESPACE     NAME                       READY   STATUS    R
kube-system   konnectivity-agent-zwktx   1/1     Running   3
kube-system   kube-proxy-tww5p           1/1     Running   1
kube-system   kube-router-8rxll          1/1     Running   1
Das Taint hat alles ohne passende Toleranz verdrängt – auch
linstor-csi-node. Das wird bei der Rückkehr wichtig.
Fortschritt speichern? Kostenlos registrieren
Drill 7: Der Node kommt zurück
Der Node ist repariert:
# auf k0s-w2
sudo systemctl stop netz-zurueck.timer
sudo iptables -t raw -F
# auf k0s-ctrl
ssh k0s-w2 "sudo drbdadm status $R | head -2; mount | grep -c drbd1001"Erwartet (fünf Sekunden nach der Freigabe):
pvc-11dccaf7-... role:Secondary suspended:quorum
force-io-failures:yes
1force-secondary (Tag 5) hat den alten Primary abgesetzt;
jeder Zugriff des alten Dateisystems scheitert
(force-io-failures:yes). suspended:quorum
zeigt: So kurz nach der Freigabe hat der Node sein Quorum noch nicht
zurück. Kein Split-Brain, die Daten von k0s-w3 gelten. Aber
das Gerät ist noch gemountet: Das kubelet will es aushängen und
scheitert, weil der CSI-Treiber dort fehlt:
# auf k0s-ctrl
ssh k0s-w2 "sudo journalctl -u k0sworker --since -1min" \
| grep -o 'UnmountVolume.TearDown failed' | head -1Erwartet:
UnmountVolume.TearDown failedNimm das Taint herunter:
# auf k0s-ctrl
kubectl taint node k0s-w2 node.kubernetes.io/out-of-service=nodeshutdown:NoExecute-
kubectl -n piraeus-datastore rollout status ds/linstor-csi-node
kubectl get csinode k0s-w2 -o jsonpath='{.spec.drivers[*].name}{"\n"}'Erwartet:
node/k0s-w2 untainted
daemon set "linstor-csi-node" successfully rolled out
linstor.csi.linbit.comBleibt die letzte Zeile leer, hat sich der Treiber noch nicht beim kubelet angemeldet – im Labor geschah das eine Sekunde nach dem Rollout. Wiederhole dann den letzten Befehl.
Das kubelet versucht das Aushängen mit wachsendem Abstand erneut. Nach etwa einer Minute:
# auf k0s-ctrl
ssh k0s-w2 "sudo drbdadm status $R | head -2; mount | grep -c drbd1001"
linstor --no-utf8 --no-color resource list --faulty | cut -c1-70Erwartet:
pvc-11dccaf7-... role:Secondary
  disk:UpToDate open:no
0
+-------------------------------------------------------------+
| ResourceName | Node | Layers | Usage | Conns | State | Vote |
|=============================================================|
+-------------------------------------------------------------+
Alles sauber, die Kopie auf k0s-w2 ist wieder aktuell.
Ausfall der Datenbank insgesamt: knapp sieben Minuten (6:47), davon fünf
Minuten Warten auf die Toleranz und 21 Sekunden nach dem Taint, bis
pg-client wieder ok meldete.
Tipp: LINSTOR legt bei einem toten Node keine neuen Kopien an.
linstor controller list-properties | grep AutoEvictzeigtDrbdOptions/AutoEvictAllowEviction false– vom Piraeus-Operator gesetzt (Tag 7). Ein ausgefallener Node bleibt ausgefallen, bis du ihn reparierst (Plattentausch: Tag 14) oder seine Kopien bewusst umziehst.
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig, auf welchem Node der LINSTOR-Controller gerade läuft. Zeitziel: 20 s
- Zeig alle Taints aller Nodes. Zeitziel: 20 s
- Zähl die Pods, die auf
k0s-w3laufen. Zeitziel: 15 s - Zeig, ab wann Kubernetes Pods eines unerreichbaren Nodes löscht. Zeitziel: 20 s
Lösung
# auf k0s-ctrl
for h in k0s-w1 k0s-w2 k0s-w3; do
  echo "$h $(ssh $h sudo drbd-reactorctl status linstor_db | sed -n 2p)"
done | grep 'this node'
kubectl get nodes -o custom-columns=NAME:.metadata.name,TAINTS:.spec.taints[*].key
kubectl get pods -A --field-selector spec.nodeName=k0s-w3 --no-headers | wc -l
kubectl -n demo get pod pg-0 -o jsonpath='{.spec.tolerations}' | tr '{' '\n' \
  | grep -o 'unreachable.*'
Erwartet (gekürzt):
k0s-w1 Promoter: Resource linstor_db currently active on this node
NAME     TAINTS
k0s-w1   <none>
k0s-w2   <none>
k0s-w3   <none>
8
unreachable","operator":"Exists","tolerationSeconds":300}]
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
# auf k0s-ctrl
kubectl get nodes -o custom-columns=NAME:.metadata.name,TAINTS:.spec.taints[*].key
Erwartet: drei Nodes, alle <none>
– kein Out-of-Service-Taint vergessen.
# auf k0s-ctrl
linstor --no-utf8 --no-color resource list --faulty
Erwartet: eine leere Tabelle.
# auf k0s-ctrl
ssh k0s-w2 'sudo iptables -t raw -S | grep -c DROP'
Erwartet: 0.
# auf k0s-ctrl
kubectl -n demo logs deploy/pg-client --tail=3
Erwartet: nur ok-Zeilen.
Challenge
Warte den Node, auf dem gerade der LINSTOR-Controller läuft: Pods weg, Controller abgeben, neu starten, sauber zurückholen. Miss, wie lange die LINSTOR-API nicht antwortet.
Hinweis: evict vor dem Neustart macht
aus einem Timeout eine Übergabe in Sekunden.
Lösung
# auf k0s-ctrl
kubectl drain k0s-w1 --ignore-daemonsets --delete-emptydir-data
ssh k0s-w1 'sudo drbd-reactorctl evict linstor_db'
date +%T; until linstor node list >/dev/null 2>&1; do sleep 1; done; date +%T
Erwartet (gekürzt):
node/k0s-w1 drained
Node 'k0s-w2' took over
Re-enabling linstor_db
07:50:36
07:51:03
Ab dem Ende von evict noch 27 Sekunden ohne API (die
Abgabe selbst kommt dazu), DRBD und die Datenbank liefen durch. Dann der
Neustart:
# auf k0s-ctrl
ssh k0s-w1 'sudo systemctl reboot'
ssh k0s-w1 uptime -s
linstor --no-utf8 --no-color node list | grep k0s-w1
linstor --no-utf8 --no-color resource list --faulty | grep -c '| k0s'
Wiederhole die drei Befehle, bis uptime -s eine neue
Zeit zeigt, k0s-w1 Online ist und
0 kommt. Im Labor dauerte das Herunterfahren diesmal 48
Sekunden (geordnetes Beenden der Pods, bis zu 60 s), der Node war nach
gut zwei Minuten (2:11) wieder Online. Währenddessen hing
linstor node list gut eine Minute, bis der Controller den
Satellite als OFFLINE führte.
# auf k0s-ctrl
kubectl uncordon k0s-w1
Der Controller bleibt auf k0s-w2. Willst du ihn zurück
auf k0s-w1, sperrst du den dritten Kandidaten und gibst ab
(Tag 6):
# auf k0s-w3
sudo systemctl mask --runtime drbd-services@linstor_db.target
# auf k0s-w2
sudo drbd-reactorctl evict linstor_db# auf k0s-w3
sudo systemctl unmask --runtime drbd-services@linstor_db.target
sudo drbd-reactorctl status linstor_db | sed -n 2pErwartet (gekürzt):
Node 'k0s-w1' took over
...
Promoter: Resource linstor_db currently active on node 'k0s-w1'
Fortschritt speichern? Kostenlos registrieren
Aufräumen
# auf k0s-ctrl
kill %1 2>/dev/null
Die Mitschnitte puls-*.log dürfen liegen bleiben.
Interview-Notiz
- Ein Node ist weg, das StatefulSet startet keinen Ersatz – warum? Kubernetes kann nicht unterscheiden, ob der Node tot oder nur unerreichbar ist. Ein zweiter Pod mit demselben Volume wäre gefährlich, also wartet es auf eine Bestätigung.
- Was macht das Out-of-Service-Taint? Es bestätigt, dass der Node aus ist. Kubernetes löscht seine Pods zwangsweise, löst die Volumes und plant neu.
- Was kostet ein Absturz mit schnellem Neustart? Gut zwei Minuten, vor allem Warten auf den Satellite, die Registrierung des CSI-Treibers und das Backoff des kubelets.
Enterprise-Notiz
- Das Taint gehört in ein Runbook mit Fencing: erst per IPMI oder Hypervisor sicher ausschalten, dann taint. Einen Teil davon automatisiert der Piraeus-HA-Controller (hier bewusst aus): Er verschiebt Pods, sobald der alte Node das DRBD-Quorum verliert.
- Wartungsfenster als Ablauf festschreiben (drain, evict, reboot,
--faulty, uncordon) und Node für Node abarbeiten – nie zwei Storage-Nodes gleichzeitig. - Die fünf Minuten
tolerationSecondssind Vorgabe; kürzere Werte am StatefulSet beschleunigen das Terminating, ändern aber nichts an der nötigen Bestätigung. AutoEvictAllowEvictionbewusst entscheiden: Automatisches Neuplatzieren kostet Platz und Netz, manuelles kostet Zeit mit nur einer Kopie.- Taints und NotReady-Nodes überwachen (
KubeNodeNotReadybringt kube-prometheus-stack mit, Taints brauchen eine eigene Regel aufkube_node_spec_taint; Routing wie in Tag 18) – ein vergessenes Out-of-Service-Taint legt den Node für jedes Volume lahm.