Tag 8: StorageClass und die erste Datenbank
Ziel: Die StorageClass
linstor-replicatedlegt Volumes mit zwei Kopien in zwei Zonen samt Writecache an, PostgreSQL 18 läuft darauf mit einem Schreib-Client als Messgerät, und der Pod zieht ohne Datenverlust auf andere Nodes um. · Dauer: ca. 45 min · Voraussetzung: Tag 7
Briefing
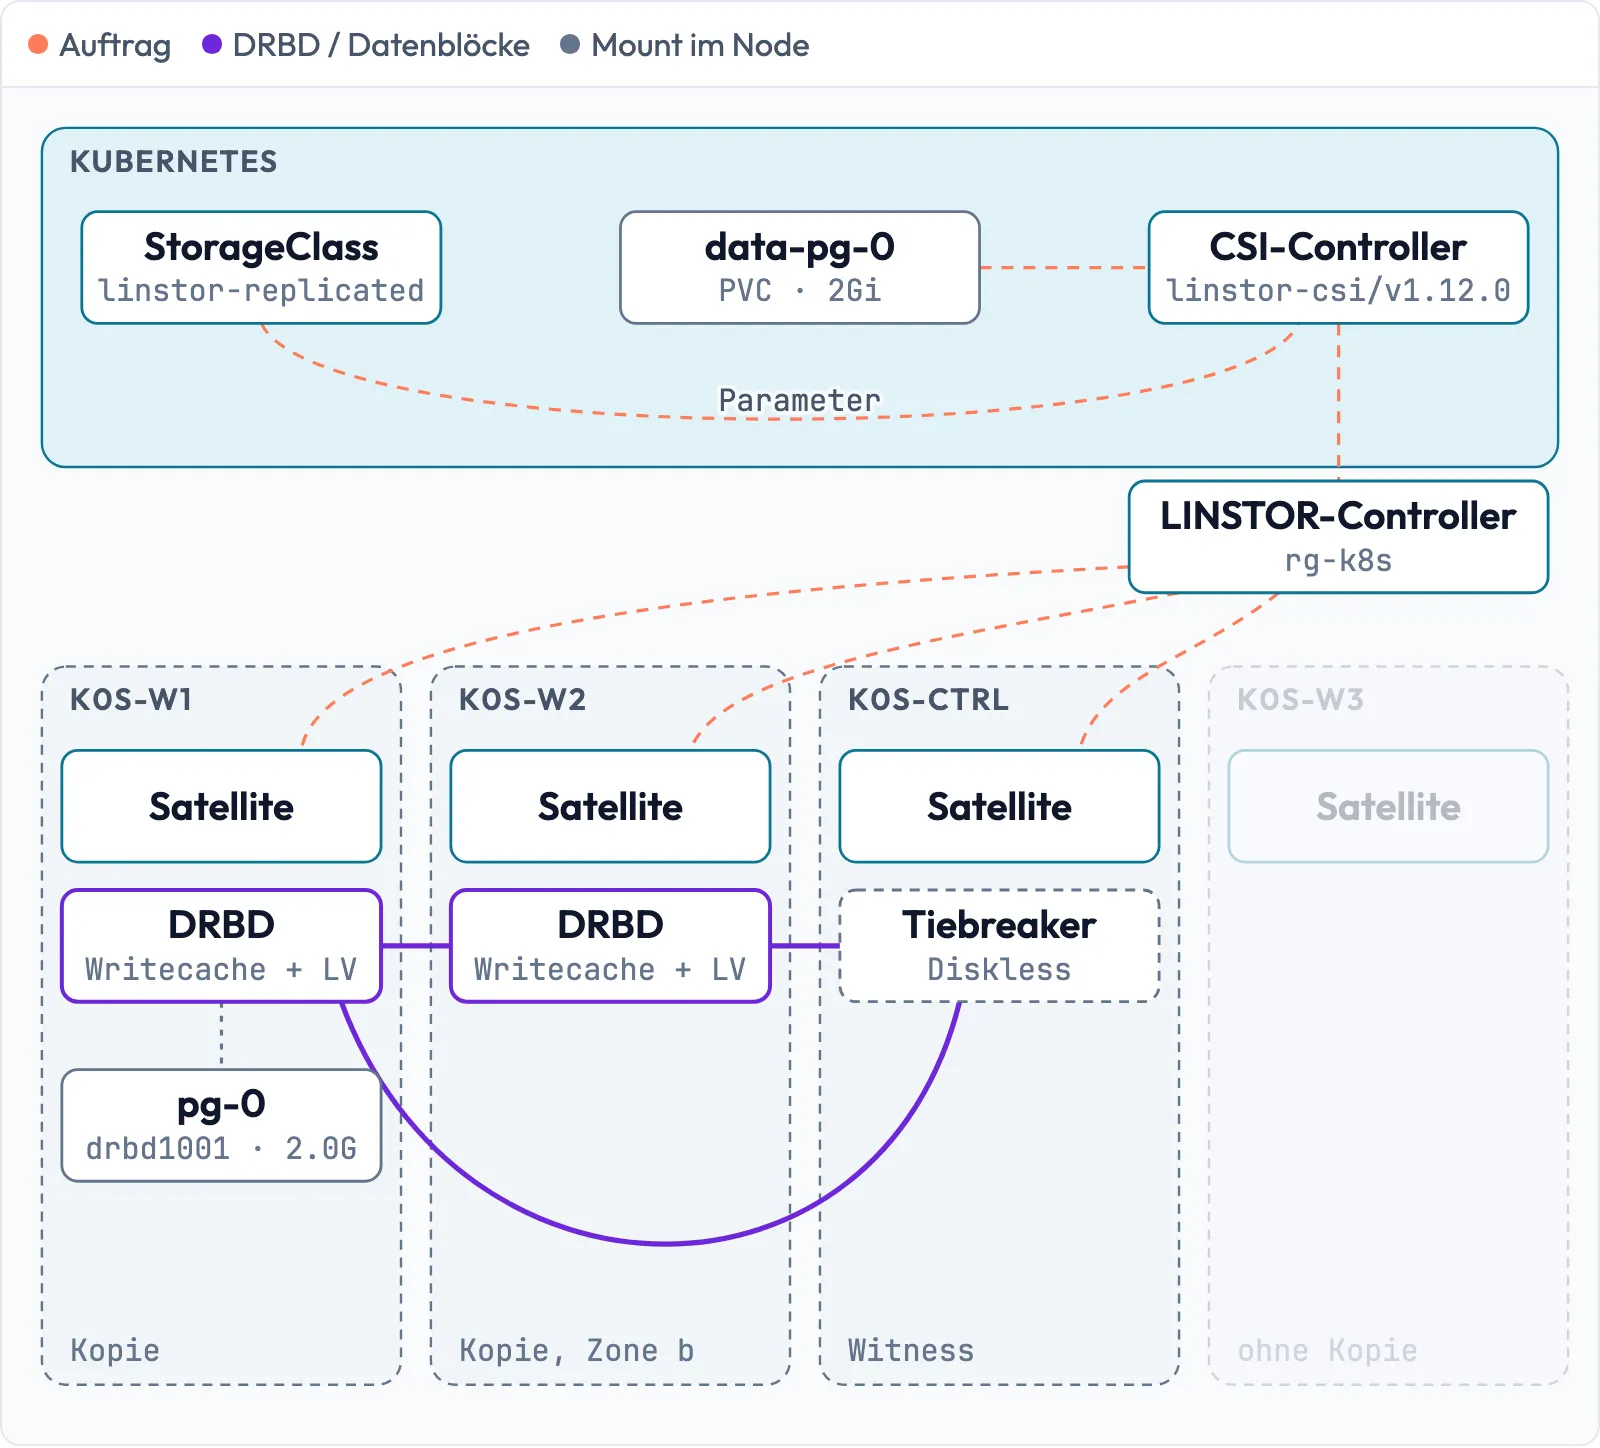
- Der CSI-Treiber übersetzt ein PVC in eine LINSTOR-Ressource. Wie sie aussieht, steht in den Parametern der StorageClass – nicht in der Resource-Group.
WaitForFirstConsumerlegt das Volume erst an, wenn der Pod einen Node hat.- Der Pod darf auf jedem Worker laufen: auf einem Node mit Kopie liest und schreibt er lokal, auf einem Node ohne Kopie hängt LINSTOR das Volume diskless über das Netz an.
- Der Schreib-Client
pg-clientschreibt jede Sekunde eine Zeile und loggtokoderFEHLER. Damit misst du ab heute jede Schreibpause.
Drill 1: Die Falle – nur die Resource-Group
Der naheliegende Gedanke: rg-k8s aus Tag 5 kann schon
alles, die StorageClass verweist nur darauf.
# auf k0s-ctrl
mkdir -p ~/k0s-lab/tag08 && cd ~/k0s-lab/tag08
cat > sc-nur-rg.yaml <<'EOF'
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: nur-rg
provisioner: linstor.csi.linbit.com
parameters:
  linstor.csi.linbit.com/resourceGroup: rg-k8s
volumeBindingMode: WaitForFirstConsumer
EOF
cat > test-nur-rg.yaml <<'EOF'
apiVersion: v1
kind: PersistentVolumeClaim
metadata: {name: tag08-test}
spec:
  storageClassName: nur-rg
  accessModes: [ReadWriteOnce]
  resources: {requests: {storage: 100Mi}}
---
apiVersion: v1
kind: Pod
metadata: {name: tag08-test}
spec:
  containers:
    - name: c
      image: busybox:1.37
      command: [sleep, infinity]
      volumeMounts: [{name: d, mountPath: /d}]
  volumes:
    - name: d
      persistentVolumeClaim: {claimName: tag08-test}
EOF
kubectl apply -f sc-nur-rg.yaml -f test-nur-rg.yaml
kubectl wait --for=condition=Ready pod/tag08-test --timeout=120s
linstor --no-utf8 --no-color resource list | grep pvc- | cut -c1-88
linstor --no-utf8 --no-color resource-group list -r rg-k8s | cut -c1-55
Erwartet (gekürzt):
pod/tag08-test condition met
| pvc-ab04a399-... | k0s-w3   | DRBD,STORAGE | InUse  | Ok    |
+-------------------------------------------------------
| ResourceGroup | SelectFilter                      | V
|=======================================================
| rg-k8s        | PlaceCount: 1                     | 0
|               | StoragePool(s): pool_data         |
|               | ReplicasOnDifferent: ['Aux/zone'] |
|               | LayerStack: ['DRBD', 'STORAGE']   |
Eine einzige Kopie ohne Writecache – und rg-k8s ist
umgeschrieben: PlaceCount: 1, LayerStack ohne
WRITECACHE. Der CSI-Treiber schreibt bei jedem Volume die
Parameter der StorageClass in die Resource-Group, was fehlt, setzt er
auf seine Vorgaben. Die StorageClass ist die Quelle der Wahrheit. Weg
damit:
# auf k0s-ctrl
kubectl delete -f test-nur-rg.yaml -f sc-nur-rg.yaml
Fortschritt speichern? Kostenlos registrieren
Drill 2: Die richtige StorageClass
Alles, was ein Volume ausmacht, steht in der StorageClass:
# auf k0s-ctrl
cat > storageclass.yaml <<'EOF'
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: linstor-replicated
  annotations:
    storageclass.kubernetes.io/is-default-class: "true"
provisioner: linstor.csi.linbit.com
parameters:
  linstor.csi.linbit.com/resourceGroup: rg-k8s
  linstor.csi.linbit.com/storagePool: pool_data
  linstor.csi.linbit.com/placementCount: "2"
  linstor.csi.linbit.com/replicasOnDifferent: Aux/zone
  linstor.csi.linbit.com/layerList: drbd writecache storage
  property.linstor.csi.linbit.com/Writecache/PoolName: pool_nvme
  property.linstor.csi.linbit.com/Writecache/Size: "5%"
  property.linstor.csi.linbit.com/DrbdOptions/Resource/quorum: majority
  property.linstor.csi.linbit.com/DrbdOptions/Resource/on-no-quorum: suspend-io
  ? property.linstor.csi.linbit.com/DrbdOptions/Resource/on-suspended-primary-outdated
  : force-secondary
  csi.storage.k8s.io/fstype: ext4
allowVolumeExpansion: true
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Delete
EOF
kubectl apply -f storageclass.yaml
kubectl get sc
Erwartet:
storageclass.storage.k8s.io/linstor-replicated created
NAME                           PROVISIONER              RECLAIMPOLICY   VOLUMEBINDING...
linstor-replicated (default)   linstor.csi.linbit.com   Delete          WaitForFirstC...
Das ?/: ist YAML für einen langen Schlüssel
auf eigener Zeile – nur damit die Zeile ins Buch passt.
property.linstor.csi.linbit.com/ setzt beliebige
LINSTOR-Eigenschaften an der Ressource.
allowVolumeExpansion brauchst du an Tag 12.
Fortschritt speichern? Kostenlos registrieren
Drill 3: PostgreSQL 18
Das Image postgres:18 erwartet das Volume unter
/var/lib/postgresql und legt die Daten selbst in
18/docker darunter ab – nicht mehr unter
/var/lib/postgresql/data wie bis Version 17.
# auf k0s-ctrl
cat > postgres.yaml <<'EOF'
apiVersion: v1
kind: Namespace
metadata: {name: demo}
---
apiVersion: v1
kind: Service
metadata: {name: pg, namespace: demo}
spec:
  selector: {app: pg}
  ports: [{port: 5432}]
---
apiVersion: apps/v1
kind: StatefulSet
metadata: {name: pg, namespace: demo}
spec:
  serviceName: pg
  replicas: 1
  selector: {matchLabels: {app: pg}}
  template:
    metadata: {labels: {app: pg}}
    spec:
      containers:
        - name: postgres
          image: postgres:18.7
          env:
            - {name: POSTGRES_PASSWORD, value: lab-pg-123}
          volumeMounts: [{name: data, mountPath: /var/lib/postgresql}]
  volumeClaimTemplates:
    - metadata: {name: data}
      spec:
        accessModes: [ReadWriteOnce]
        resources: {requests: {storage: 2Gi}}
EOF
kubectl apply -f postgres.yaml
kubectl -n demo rollout status sts/pg --timeout=300s
kubectl -n demo get pvc,pod -o wide | cut -c1-88
kubectl -n demo exec pg-0 -- sh -c 'df -h /var/lib/postgresql; ls /var/lib/postgresql'
Erwartet (gekürzt):
partitioned roll out complete: 1 new pods have been updated...
NAME                              STATUS   VOLUME...
persistentvolumeclaim/data-pg-0   Bound    pvc-395c4ec0-...
NAME       READY   STATUS    RESTARTS   AGE   IP           NODE     NOMINATED NODE...
pod/pg-0   1/1     Running   0          45s   10.244.2.6   k0s-w1   <none>...
Filesystem      Size  Used Avail Use% Mounted on
/dev/drbd1001   2.0G   40M  1.8G   3% /var/lib/postgresql
18
lost+found
Das Passwort steht nur fürs Labor im Klartext im Manifest.
lost+found stört nicht mehr, weil PostgreSQL 18 ein
Unterverzeichnis nimmt.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Was LINSTOR daraus gemacht hat
# auf k0s-ctrl
R=$(kubectl -n demo get pvc data-pg-0 -o jsonpath='{.spec.volumeName}')
linstor --no-utf8 --no-color resource list -r $R | cut -c44-100
linstor --no-utf8 --no-color resource-group list -r rg-k8s | cut -c1-70
linstor --no-utf8 --no-color resource-definition list-properties $R
Erwartet (gekürzt):
---------------------------------------------------------
| Node     | Layers                  | Usage  | Conns |
=========================================================
| k0s-ctrl | DRBD,STORAGE            | Unused | Ok    | D
| k0s-w1   | DRBD,WRITECACHE,STORAGE | InUse  | Ok    | U
| k0s-w2   | DRBD,WRITECACHE,STORAGE | Unused | Ok    | U
...
| rg-k8s        | PlaceCount: 2                                 |
|               | StoragePool(s): pool_data                     |
|               | ReplicasOnDifferent: ['Aux/zone']             |
|               | LayerStack: ['DRBD', 'WRITECACHE', 'STORAGE'] |
...
| Aux/csi-provisioning-completed-by    | linstor-csi/v1.12.0 |
| Aux/csi.storage.k8s.io/pvc/name      | data-pg-0           |
| Aux/csi.storage.k8s.io/pvc/namespace | demo                |
| DrbdOptions/Resource/quorum          | majority            |
...
Zwei Zonen, Writecache, Tiebreaker auf der Witness, und
rg-k8s ist wieder repariert. Damit ist auch belegt: CSI
v1.12.0 legt gegen LINSTOR 1.34.2 Volumes an. Über
Aux/csi.storage.k8s.io/pvc/name findest du zu jeder
Ressource das PVC, ohne Kubernetes zu fragen.
Tipp: Der Treiber hat auch die Volume-Group von
rg-k8sentfernt (linstor volume-group list rg-k8sist leer). Einspawn-resourcesvon Hand ausrg-k8serzeugt danach Ressourcen ohne Volume. Für Tests von Hand nimm eine eigene Gruppe.
Fortschritt speichern? Kostenlos registrieren
Drill 5: Das Messgerät
# auf k0s-ctrl
cat > pg-client.yaml <<'EOF'
apiVersion: apps/v1
kind: Deployment
metadata: {name: pg-client, namespace: demo}
spec:
  replicas: 1
  selector: {matchLabels: {app: pg-client}}
  template:
    metadata: {labels: {app: pg-client}}
    spec:
      containers:
        - name: client
          image: postgres:18.7
          env: [{name: PGPASSWORD, value: lab-pg-123}]
          command: [bash, -c]
          args:
            - |
              until timeout 3 psql -h pg -U postgres -qc "create table if not exists
                puls (zeit timestamptz default now())"; do sleep 2; done
              while true; do
                if timeout 3 psql -h pg -U postgres -qc \
                  "insert into puls default values" 2>/dev/null; then
                  echo "$(date +%T) ok"
                else
                  echo "$(date +%T) FEHLER"
                fi
                sleep 1
              done
EOF
kubectl apply -f pg-client.yaml
kubectl -n demo rollout status deploy/pg-client
kubectl -n demo logs deploy/pg-client --tail=3
Erwartet:
deployment.apps/pg-client created
deployment "pg-client" successfully rolled out
01:24:04 ok
01:24:06 ok
01:24:07 ok
timeout 3 sorgt dafür, dass ein hängender Schreibzugriff
nach drei Sekunden als FEHLER zählt, statt das Messgerät
mit anzuhalten. In der until-Schleife verhindert es, dass
der Client beim Start an einem noch nicht bereiten Server dauerhaft
hängen bleibt – das passiert sonst etwa beim Restore an Tag 13.
Fortschritt speichern? Kostenlos registrieren
Drill 6: Umzug auf die andere Kopie
# auf k0s-ctrl
kubectl -n demo exec pg-0 -- psql -U postgres \
  -c "create table notizen(id serial primary key, text text,
      zeit timestamptz default now())" \
  -c "insert into notizen(text) values ('geschrieben auf k0s-w1')"
kubectl cordon k0s-w1
kubectl -n demo delete pod pg-0
kubectl -n demo wait --for=condition=Ready pod/pg-0 --timeout=180s
kubectl -n demo get pod pg-0 -o wide | cut -c1-80
kubectl -n demo exec pg-0 -- psql -U postgres -c "select * from notizen"
kubectl uncordon k0s-w1
kubectl -n demo logs deploy/pg-client | uniq -c -f1
Erwartet (gekürzt):
CREATE TABLE
INSERT 0 1
node/k0s-w1 cordoned
pod "pg-0" deleted from demo namespace
pod/pg-0 condition met
NAME   READY   STATUS    RESTARTS   AGE   IP           NODE     NOMINATED NODE   READINE
pg-0   1/1     Running   0          9s    10.244.1.9   k0s-w2   <none>           <none>
 id |          text          |             zeit
----+------------------------+-------------------------------
  1 | geschrieben auf k0s-w1 | 2026-11-20 01:24:21.405699+00
(1 row)

node/k0s-w1 uncordoned
     17 01:24:02 ok
      3 01:24:25 FEHLER
      9 01:24:35 ok
Der Pod läuft auf k0s-w2, der Kopie in Zone b, die Zeile
ist da. Drei Fehlversuche, gut zehn Sekunden Pause – das ist der
Neustart von PostgreSQL, nicht der Speicher. In LINSTOR ist jetzt
k0s-w2 InUse.
Fortschritt speichern? Kostenlos registrieren
Drill 7: Umzug auf einen Node ohne Kopie
k0s-w3 hat keine Kopie. Sperre die beiden anderen
Worker, dann bleibt nur er:
# auf k0s-ctrl
kubectl cordon k0s-w1 k0s-w2
kubectl -n demo delete pod pg-0
kubectl -n demo wait --for=condition=Ready pod/pg-0 --timeout=180s
kubectl uncordon k0s-w1 k0s-w2
linstor --no-utf8 --no-color resource list -r $R | cut -c44-100
ssh k0s-w3 "sudo drbdadm status $R"
Erwartet (gekürzt):
...
| k0s-ctrl | DRBD,STORAGE            | Unused | Ok    | D
| k0s-w1   | DRBD,WRITECACHE,STORAGE | Unused | Ok    | U
| k0s-w2   | DRBD,WRITECACHE,STORAGE | Unused | Ok    | U
| k0s-w3   | DRBD,STORAGE            | InUse  | Ok    | D
...
pvc-395c4ec0-... role:Primary
  disk:Diskless client:yes open:yes
  k0s-w1 role:Secondary
    peer-disk:UpToDate
  k0s-w2 role:Secondary
    peer-disk:UpToDate
LINSTOR hat auf k0s-w3 eine diskless Ressource angelegt:
Jeder Schreibzugriff geht über das Storage-Netz an beide Kopien, jeder
Lesezugriff an eine davon. Zur Witness gibt es keine Verbindung – zwei
Diskless-Teilnehmer haben sich nichts zu sagen. Diesmal war die Pause
länger:
# auf k0s-ctrl
kubectl -n demo describe pod pg-0 | grep -E 'Attach|Pulled' | cut -c1-88
Erwartet (gekürzt):
  Warning  FailedAttachVolume      56s   attachdetach-controller  Waiting for detach...
  Normal   SuccessfulAttachVolume  51s   attachdetach-controller  AttachVolume.Attach...
  Normal   Pulled                  17s   kubelet                  spec.containers{pos...
Der Speicher war nach fünf Sekunden da, 29 Sekunden kostete das
Image, das auf k0s-w3 noch nicht lag. In Produktion gehören
Images vorab auf alle Nodes.
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig den Namen der LINSTOR-Ressource hinter
data-pg-0. Zeitziel: 20 s - Zeig die Standard-StorageClass. Zeitziel: 10 s
- Zeig die letzten drei Zeilen des Messgeräts. Zeitziel: 10 s
- Zeig, ob
pg-0gerade lokal oder diskless schreibt. Zeitziel: 30 s
Lösung
# auf k0s-ctrl
kubectl -n demo get pvc data-pg-0 -o jsonpath='{.spec.volumeName}{"\n"}'
kubectl get sc
kubectl -n demo logs deploy/pg-client --tail=3
kubectl -n demo get pod pg-0 -o jsonpath='{.spec.nodeName}{"\n"}'
linstor --no-utf8 --no-color resource list -r $R | grep InUse | cut -c44-100
Erwartet (gekürzt):
pvc-395c4ec0-...
linstor-replicated (default)   linstor.csi.linbit.com   Delete          WaitForFirstC...
01:27:20 ok
01:27:21 ok
01:27:22 ok
k0s-w3
| k0s-w3   | DRBD,STORAGE            | InUse  | Ok    | D
DRBD,STORAGE ohne WRITECACHE und
State mit D… heißt diskless.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
# auf k0s-ctrl
kubectl -n demo get pvc,pod
Erwartet: data-pg-0 Bound
2Gi auf linstor-replicated, pg-0 und
pg-client Running.
# auf k0s-ctrl
kubectl -n demo logs deploy/pg-client --tail=5
Erwartet: nur ok-Zeilen mit
fortlaufender Uhrzeit.
# auf k0s-ctrl
linstor --no-utf8 --no-color resource-group list -r rg-k8s | cut -c1-70
Erwartet: PlaceCount: 2,
ReplicasOnDifferent: ['Aux/zone'],
LayerStack: ['DRBD', 'WRITECACHE', 'STORAGE'].
Challenge
pg-0 läuft diskless auf k0s-w3. Hol die
Daten zum Pod, ohne ihn anzuhalten: k0s-w3 soll eine Kopie
mit Daten bekommen, die Kopie auf k0s-w1 (gleiche Zone)
soll weg. Am Ende sind es wieder zwei Kopien in zwei Zonen, und das
Messgerät zeigt keinen Fehler.
Hinweis: linstor resource toggle-disk
macht aus einer diskless Ressource eine mit Daten.
Lösung
# auf k0s-ctrl
linstor resource toggle-disk k0s-w3 $R --storage-pool pool_data
linstor --no-utf8 --no-color resource list -r $R | cut -c44-100
Erwartet (gekürzt):
SUCCESS:
    Addition of disk to resource 'pvc-395c4ec0-...' on node 'k0s-w3' registered
...
INFO:
    Tie breaker marked for deletion
...
| k0s-w1 | DRBD,WRITECACHE,STORAGE | Unused | Ok    |
| k0s-w2 | DRBD,WRITECACHE,STORAGE | Unused | Ok    |
| k0s-w3 | DRBD,WRITECACHE,STORAGE | InUse  | Ok    | Syn
Mit drei Kopien braucht es keinen Tiebreaker mehr. Warte, bis
k0s-w3 UpToDate ist, dann die überzählige
Kopie löschen:
# auf k0s-ctrl
linstor resource delete k0s-w1 $R
linstor --no-utf8 --no-color resource list -r $R | cut -c44-100
kubectl -n demo logs deploy/pg-client --since=5m | uniq -c -f1 | tail -1
Erwartet (gekürzt):
INFO:
    Tie breaker resource 'pvc-395c4ec0-...' created on k0s-ctrl
...
| k0s-ctrl | DRBD,STORAGE            | Unused | Ok    | D
| k0s-w2   | DRBD,WRITECACHE,STORAGE | Unused | Ok    | U
| k0s-w3   | DRBD,WRITECACHE,STORAGE | InUse  | Ok    | U
     81 01:25:30 ok
Der Resync lief unter der laufenden Datenbank, ohne einen einzigen Fehler. Prüfe noch, wo der Writecache der neuen Kopie gelandet ist:
# auf k0s-ctrl
ssh k0s-w3 "sudo lvs --noheadings -o lv_name,vg_name,lv_size | grep ${R:0:12}"
Erwartet (gekürzt):
  pvc-395c4ec0-....cache_00000 data  104.00m
  pvc-395c4ec0-..._00000       data    2.00g
Das Cache-LV liegt in VG data, nicht in
cache: toggle-disk nimmt für den Cache
denselben Pool wie für die Daten und übergeht
Writecache/PoolName. Im Labor geprüft mit LINSTOR 1.34.2
und 1.35.3 – mit und ohne --storage-pool, auch mit der
Eigenschaft an Resource- oder Volume-Definition. Ein frisches
linstor resource create auf einem Node ohne Ressource legt
den Cache dagegen richtig in pool_nvme. Der Writecache
läuft so, beschleunigt aber nichts. Bei dir bereinigt das spätestens der
Restore an Tag 13, der das Volume neu anlegt. Ohne Restore: Sobald
pg-0 woanders läuft, die Kopie auf k0s-w3 mit
linstor resource delete löschen und mit
linstor resource create neu anlegen.
Fortschritt speichern? Kostenlos registrieren
Aufräumen
Nichts. demo/pg und pg-client bleiben als
Testlast für die folgenden Tage.
Interview-Notiz
- Woher kommen Replikate und Layer eines CSI-Volumes? Aus den Parametern der StorageClass. Der Treiber schreibt sie bei jedem Volume in die Resource-Group.
- Kann ein Pod auf einem Node ohne Kopie laufen? Ja, diskless: DRBD liest und schreibt über das Netz. Langsamer, aber ohne Datenverlust.
- Wie misst du die Auswirkung einer Wartung auf eine Datenbank? Mit einem Client, der im Sekundentakt schreibt und Erfolg oder Fehler mit Zeitstempel protokolliert.
Enterprise-Notiz
- Eine StorageClass pro Klasse (z. B.
linstor-fastmit Writecache,linstor-bulkohne), je mit eigener Resource-Group, damit sich die Klassen nicht gegenseitig umschreiben. allowRemoteVolumeAccessin der StorageClass begrenzt, wo diskless gemountet werden darf – etwa nur innerhalb der Zone, wenn das Netz zwischen den Zonen teuer ist.- Passwörter als Secret (besser: External Secrets/Vault), Datenbanken mit einem Operator wie CloudNativePG statt eigenem StatefulSet.
- Images vorab verteilen oder eine Registry in der Nähe betreiben – sonst bestimmt der Image-Pull die Ausfallzeit.