Tag 6: Controller-HA mit drbd-reactor und VIP
Ziel: Die Controller-Datenbank liegt auf der DRBD-Ressource
linstor_db, drbd-reactor startet Mount, VIP und Controller immer nur dort, wo sie Primary ist, und du hast geplanten Wechsel, harten Absturz und Netztrennung durchgespielt. · Dauer: ca. 75 min · Voraussetzung: Tag 5
Briefing
- Der Controller ist bis auf seine H2-Datenbank unter
/var/lib/linstorzustandslos. Wer diese Datei hat, kann Controller sein. - Die Datenbank kommt auf eine kleine DRBD-Ressource
linstor_dbmit drei Kopien auf den Workern. Die Witness ist diskless dabei. - drbd-reactor beobachtet
linstor_db. Wo sie Primary werden darf, startet er eine Kette: Mount → VIP10.10.0.100→linstor-controller. - Zwei Controller gleichzeitig verhindert das DRBD-Quorum: Ohne Mehrheit wird niemand Primary.
 k0s-w1 (aktiv)                k0s-w2, k0s-w3 (bereit)
 linstor_db Primary            linstor_db Secondary
 /var/lib/linstor gemountet    drbd-reactor wartet
 VIP 10.10.0.100 auf ens19
 linstor-controller läuft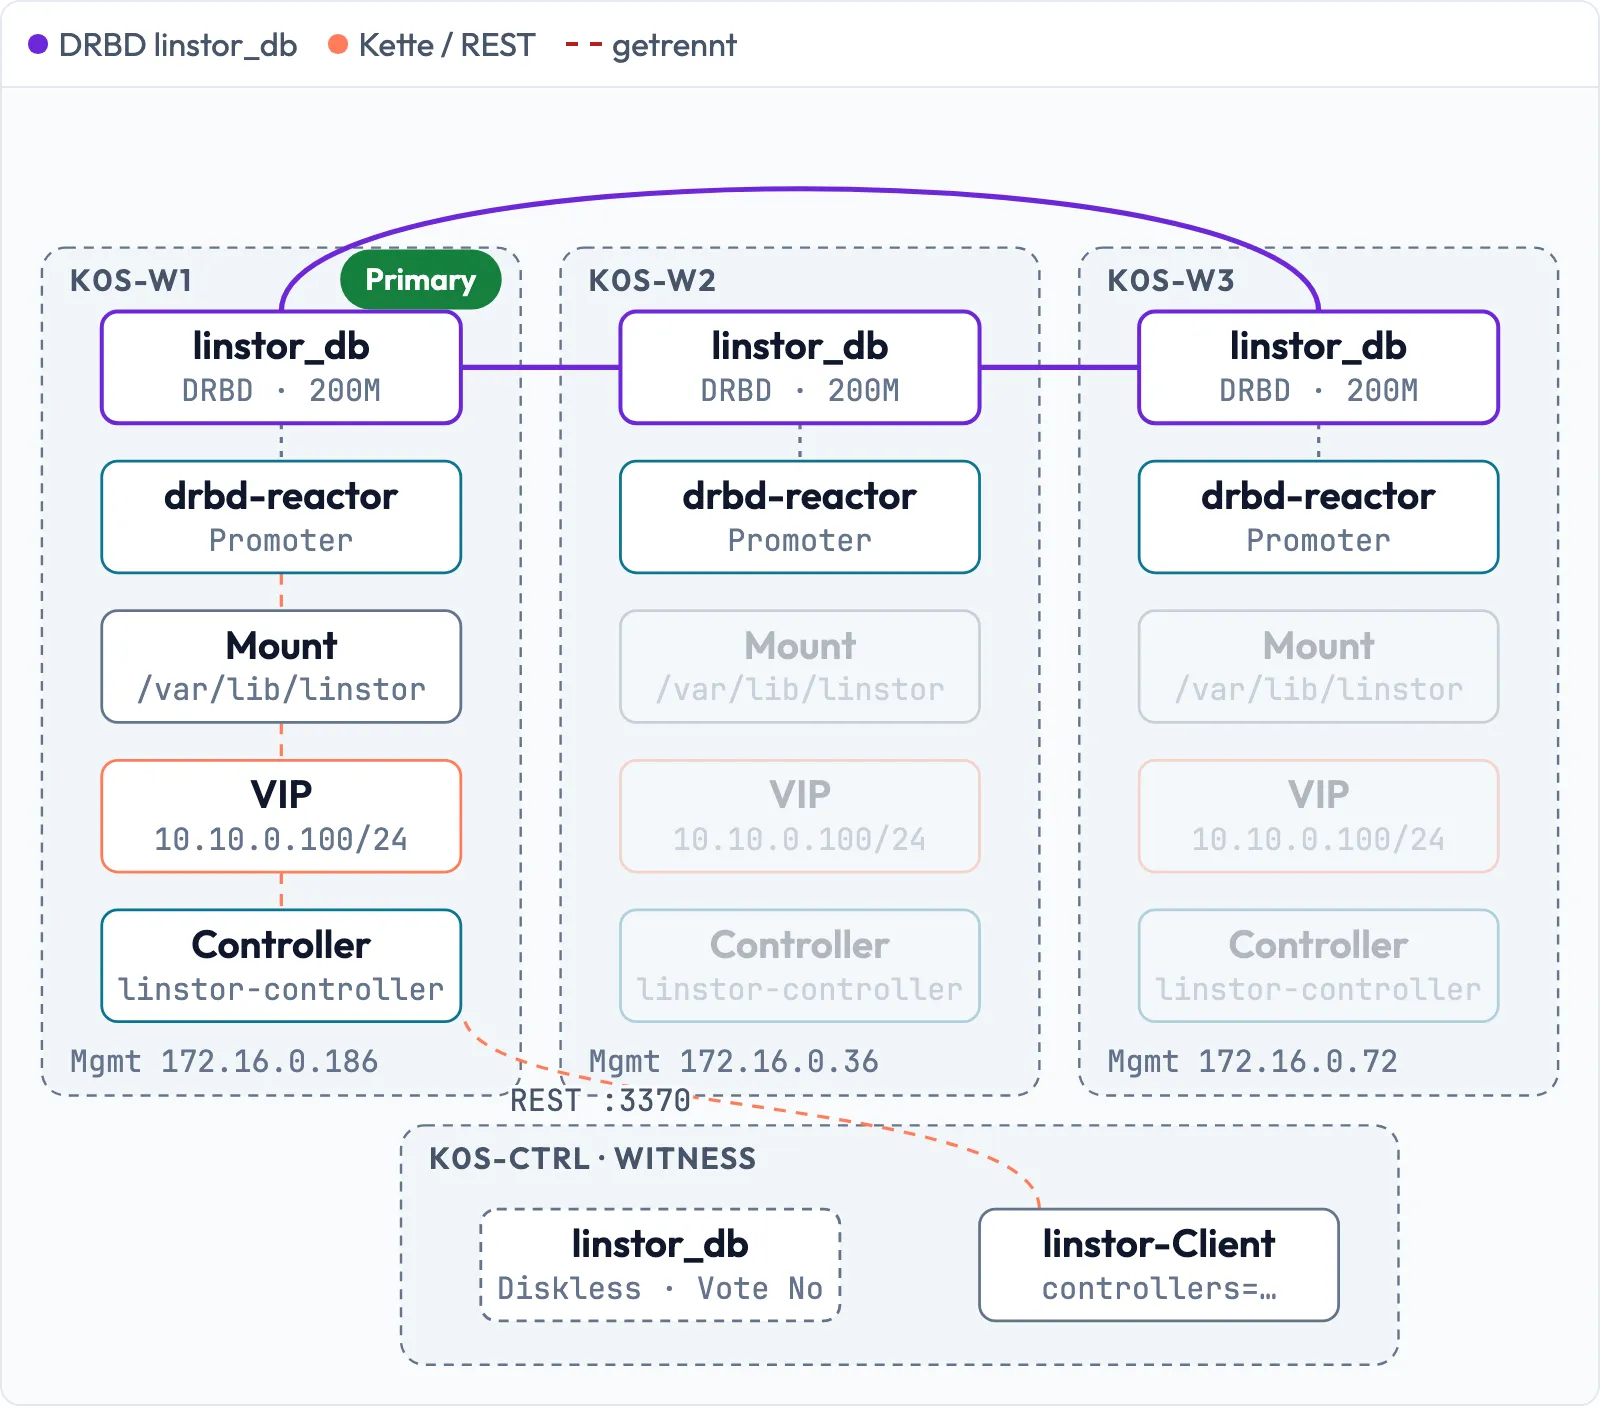
Drill 1: Die Ressource linstor_db
# auf k0s-ctrl
mkdir -p ~/k0s-lab/tag06 && cd ~/k0s-lab/tag06
linstor resource-group create linstor-db-grp --storage-pool pool_data --place-count 3 \
  --diskless-on-remaining true
linstor resource-group drbd-options --auto-promote=no --quorum=majority \
  --on-suspended-primary-outdated=force-secondary \
  --on-no-quorum=io-error --on-no-data-accessible=io-error linstor-db-grp
linstor volume-group create linstor-db-grp
linstor resource-group spawn-resources linstor-db-grp linstor_db 200M
linstor --no-utf8 --no-color resource list -r linstor_db
Erwartet (gekürzt):
SUCCESS:
    New resource group 'linstor-db-grp' created.
...
+---------------------------------------------------------------------------+
| ResourceName | Node     | Layers       | Usage  | Conns |    State | Vote |
|===========================================================================|
| linstor_db   | k0s-ctrl | DRBD,STORAGE | Unused | Ok    | Diskless | No   |
| linstor_db   | k0s-w1   | DRBD,STORAGE | Unused | Ok    | UpToDate | Yes  |
| linstor_db   | k0s-w2   | DRBD,STORAGE | Unused | Ok    | UpToDate | Yes  |
| linstor_db   | k0s-w3   | DRBD,STORAGE | Unused | Ok    | UpToDate | Yes  |
+---------------------------------------------------------------------------+| Option | Warum |
|---|---|
auto-promote=no |
Nur drbd-reactor macht Primary, nicht wer zuerst öffnet |
on-no-quorum=io-error |
Controller bekommt sofort Fehler, drbd-reactor gibt ab |
on-suspended-primary-outdated |
veralteter Ex-Primary wird zwangsweise Secondary |
--diskless-on-remaining |
Witness diskless dabei |
Bei drei Kopien mit Daten gibt es auch ohne Witness eine klare
Mehrheit (2 von 3), ihre Stimme zählt hier nicht: Vote No.
Anders als bei rg-k8s gilt io-error statt
suspend-io: Ein hängender Controller wäre schlimmer als
einer, der sofort abgibt.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Die leeren Datenbanken auf k0s-w2 und k0s-w3
An Tag 3 lief der Controller kurz auf allen Kandidaten. Jeder hat dabei eine eigene, leere Datenbank angelegt – und die liegt noch da:
# auf k0s-w2
sudo ls -l /var/lib/linstor
Erwartet (gekürzt):
-rw-r--r-- 1 61437 64264 172032 Nov 20 00:22 linstordb.mv.dbSolange linstor_db dort gemountet ist, verdeckt der
Mount diese Datei. Startet aber jemand den Controller
ohne Mount (Wartung, Tippfehler, falsche Reihenfolge),
läuft ein zweiter Controller mit leerem Cluster – die Falle aus Tag 3 in
schlimmer. Zwei Schutzmaßnahmen: die alte Datei weg, und der Controller
startet nur auf einem Mount.
# auf k0s-w2
sudo mv /var/lib/linstor /var/lib/linstor.leer
sudo mkdir /var/lib/linstor
sudo mkdir -p /etc/systemd/system/linstor-controller.service.d
sudo tee /etc/systemd/system/linstor-controller.service.d/nur-mit-db.conf <<'EOF'
[Unit]
ConditionPathIsMountPoint=/var/lib/linstor
EOF
sudo systemctl daemon-reload
sudo systemctl start linstor-controller
systemctl status linstor-controller --no-pager | grep -E 'Active|condition'
Erwartet (gekürzt):
[Unit]
ConditionPathIsMountPoint=/var/lib/linstor
     Active: inactive (dead)
... was skipped because of an unmet condition check (ConditionPathIsMountPoint=/v...
Wiederhole das auf k0s-w3. Die Besitzer sind Zahlen,
weil die Unit mit DynamicUser=true läuft. Ihr
ExecStartPre setzt die Rechte bei jedem Start neu – auch
auf einem frisch gemounteten Dateisystem.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Die Datenbank umziehen
Die Mount-Unit kommt auf alle drei Kandidaten. Sie wird nicht aktiviert, nur drbd-reactor startet sie:
# auf k0s-w1
sudo tee /etc/systemd/system/var-lib-linstor.mount >/dev/null <<'EOF'
[Unit]
Description=Filesystem for the LINSTOR controller

[Mount]
What=/dev/drbd/by-res/linstor_db/0
Where=/var/lib/linstor
EOF
sudo systemctl daemon-reload
systemctl is-enabled var-lib-linstor.mount
Erwartet:
staticWiederhole das auf k0s-w2 und k0s-w3. Der
Dateiname muss zum Pfad passen: /var/lib/linstor wird zu
var-lib-linstor.mount. Jetzt der Umzug auf
k0s-w1, wo der Controller noch mit der Datenbank auf der
Systemplatte läuft:
# auf k0s-w1
sudo systemctl disable --now linstor-controller
sudo mv /var/lib/linstor /var/lib/linstor.orig
sudo mkdir /var/lib/linstor
sudo drbdadm primary linstor_db
sudo mkfs.ext4 -q -b 4096 /dev/drbd/by-res/linstor_db/0
sudo systemctl start var-lib-linstor.mount
sudo cp -a /var/lib/linstor.orig/. /var/lib/linstor/
sudo ls -l /var/lib/linstor
findmnt /var/lib/linstor
sudo umount /var/lib/linstor
sudo drbdadm secondary linstor_db
Erwartet (gekürzt):
Removed "/etc/systemd/system/multi-user.target.wants/linstor-controller.service".
-rw-r--r-- 1 61437 64264 385024 Nov 20 00:46 linstordb.mv.db
drwx------ 2 root  root   16384 Nov 20 00:46 lost+found
TARGET           SOURCE        FSTYPE OPTIONS
/var/lib/linstor /dev/drbd1000 ext4   rw,relatime
Ab jetzt ist der Controller aus, bis drbd-reactor ihn startet. Die
Volumes laufen trotzdem weiter. Lege auf k0s-w1 dieselbe
Drop-in-Datei nur-mit-db.conf an wie in Drill 2.
Achtung:
/var/lib/linstor.origist deine Sicherung von vor dem Umzug. Starte nie einen Controller, der darauf zeigt: Er hätte einen veralteten Stand. Löschen erst, wenn der Controller einige Tage stabil auflinstor_dbläuft.
Fortschritt speichern? Kostenlos registrieren
Drill 4: drbd-reactor einrichten
Für die VIP nutzt drbd-reactor den OCF-Agenten IPaddr2
aus dem Pacemaker-Umfeld, ohne Pacemaker:
# auf k0s-w1
sudo apt-get install -y resource-agents-base
sudo tee /etc/drbd-reactor.d/linstor_db.toml >/dev/null <<'EOF'
[[promoter]]
id = "linstor_db"
[promoter.resources.linstor_db]
start = [
  "var-lib-linstor.mount",
  "ocf:heartbeat:IPaddr2 linstor_vip ip=10.10.0.100 cidr_netmask=24 nic=ens19",
  "linstor-controller.service",
]
on-drbd-demote-failure = "reboot"
stop-services-on-exit = true
EOF
sudo tee /etc/linstor/linstor-client.conf >/dev/null <<'EOF'
[global]
controllers=10.10.0.100
EOF
Wiederhole das auf k0s-w2 und k0s-w3.
| Zeile | Bedeutung |
|---|---|
start = [...] |
Kette, beim Abgeben rückwärts |
ocf:heartbeat:IPaddr2 ... |
VIP im Storage-Netz, wandert mit |
on-drbd-demote-failure = "reboot" |
hält etwas das Gerät fest, startet der Node neu |
stop-services-on-exit |
Stopp von drbd-reactor fährt auch die Kette herunter |
Die Witness erreicht die VIP nicht – sie hat keine Adresse im Storage-Netz. Sie bekommt die Liste der Kandidaten und probiert sie der Reihe nach:
# auf k0s-ctrl
sudo tee /etc/linstor/linstor-client.conf >/dev/null <<'EOF'
[global]
controllers=172.16.0.186,172.16.0.36,172.16.0.72
EOF
ip route get 10.10.0.100
Erwartet:
10.10.0.100 via 172.16.0.1 dev eth0 src 172.16.0.176 uid 1000
    cache
Fortschritt speichern? Kostenlos registrieren
Drill 5: Den Promoter starten
Zuerst auf k0s-w1, damit der Controller dort startet, wo
er gerade war:
# auf k0s-w1
sudo systemctl restart drbd-reactor
sleep 15
sudo drbd-reactorctl status linstor_db
ip -br addr show ens19
Erwartet:
/etc/drbd-reactor.d/linstor_db.toml:
Promoter: Resource linstor_db currently active on this node
● drbd-services@linstor_db.target
● ├─ drbd-promote@linstor_db.service
● ├─ var-lib-linstor.mount
● ├─ ocf.rs@linstor_vip_linstor_db.service
● └─ linstor-controller.service

ens19            UP             10.10.0.11/24 10.10.0.100/24 fe80::be24:11ff:feba:...
Dann sudo systemctl restart drbd-reactor auf
k0s-w2 und k0s-w3. Dort zeigt der Status leere
Kreise:
# auf k0s-w2
sudo drbd-reactorctl status linstor_db
Erwartet:
/etc/drbd-reactor.d/linstor_db.toml:
Promoter: Resource linstor_db currently active on node 'k0s-w1'
○ drbd-services@linstor_db.target
○ ├─ drbd-promote@linstor_db.service
○ ├─ var-lib-linstor.mount
○ ├─ ocf.rs@linstor_vip_linstor_db.service
○ └─ linstor-controller.service
Und der Beweis, dass der umgezogene Controller alles noch weiß:
# auf k0s-ctrl
linstor --no-utf8 --no-color node list
linstor --no-utf8 --no-color resource list -r linstor_db
Erwartet (gekürzt):
| k0s-ctrl | LINUX    | SATELLITE | 172.16.0.176:3366 (PLAIN) | Online |
| k0s-w1   | LINUX    | SATELLITE | 10.10.0.11:3366 (PLAIN)   | Online |
...
| linstor_db   | k0s-w1   | DRBD,STORAGE | InUse  | Ok    | UpToDate | Yes  |
...
Fortschritt speichern? Kostenlos registrieren
Drill 6: Geplanter Wechsel
Öffne ein zweites Terminal auf k0s-w2 als Messgerät für
die REST-API über die VIP:
# auf k0s-w2
while sleep 1; do
  curl -sf -m 2 -o /dev/null http://10.10.0.100:3370/v1/controller/version \
    && echo "$(date +%T) ok" || echo "$(date +%T) weg"
done
Im ersten Terminal schiebst du den Controller weg, etwa vor einer Wartung:
# auf k0s-w1
sudo drbd-reactorctl evict linstor_db
Erwartet:
/etc/drbd-reactor.d/linstor_db.toml:
Evicting linstor_db
Created symlink /run/systemd/system/drbd-services@linstor_db.target → /dev/null.
20..19..
Node 'k0s-w3' took over
Re-enabling linstor_db
Removed /run/systemd/system/drbd-services@linstor_db.target.
Erwartet im Messgerät (gekürzt, Ende mit Strg+C):
00:49:01 ok
00:49:02 weg
...
00:49:17 weg
00:49:19 ok
Etwa 16 Sekunden ohne API – fast alles davon ist der Java-Start des
Controllers. evict maskiert die Kette kurz, damit
k0s-w1 sie nicht sofort zurückholt. Laufende Volumes merken
davon nichts: Die Daten fließen zwischen den DRBD-Modulen, nicht über
den Controller.
Fortschritt speichern? Kostenlos registrieren
Drill 7: Harter Absturz
Jetzt ohne Vorwarnung. Wer gerade aktiv ist, sagt dir die Witness:
Achtung:
bin/proc/sysrq-triggerstartet den Host sofort neu, ohne Dateisysteme zu synchronisieren – wie ein Druck auf den Reset-Knopf. Nur im Labor.
# auf k0s-ctrl
sudo drbdadm status linstor_db | grep Primary
ssh k0s-w3 'date +%T; echo b | sudo tee /proc/sysrq-trigger'
Erwartet:
  k0s-w3 role:Primary
00:50:17
b
Die SSH-Sitzung hängt, k0s-w3 ist weg. Auf einem der
beiden anderen Kandidaten:
# auf k0s-w2
sudo journalctl -k --since "-2min" | grep 'k0s-w3: PingAck'
sudo journalctl -u drbd-reactor -u linstor-controller --since "-2min" \
  | grep -E 'may promote|Controller initialized' | cut -c1-88
Erwartet (gekürzt):
Nov 20 00:50:26 k0s-w2 kernel: drbd linstor_db k0s-w3: PingAck did not arrive in time.
Nov 20 00:50:26 k0s-w2 drbd-reactor[24466]: INFO [drbd_reactor::plugin::promoter] run...
Nov 20 00:50:43 k0s-w2 Controller[25503]: 2026-11-20 00:50:43.004 [Main] INFO LINST...| Zeit | Ereignis |
|---|---|
| 00:50:17 | Absturz k0s-w3 |
| 00:50:26 | DRBD merkt es (Ping-Timeout), k0s-w2 darf Primary
werden |
| 00:50:28 | Mount und VIP auf k0s-w2 |
| 00:50:43 | Controller bereit, nach 26 Sekunden |
k0s-w3 kommt nach dem Neustart als Secondary zurück.
drbd-reactor holt den Controller nicht zurück – es gibt keinen
„Heimat-Node“.
Fortschritt speichern? Kostenlos registrieren
Drill 8: Quorum verhindert zwei Controller
Was passiert, wenn der aktive Node lebt, aber die anderen nicht mehr
erreicht? Trenne k0s-w2 vom DRBD-Verkehr (Ports 7000–7999),
SSH und Kubernetes laufen weiter:
# auf k0s-w2
sudo iptables -I INPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sudo iptables -I OUTPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sleep 30
sudo drbdadm status linstor_db
sudo drbd-reactorctl status linstor_db | head -3
systemctl is-active linstor-controller
Erwartet:
linstor_db role:Secondary
  disk:UpToDate quorum:no open:no
  k0s-ctrl connection:Connecting
  k0s-w1 connection:Connecting
  k0s-w3 connection:Connecting

/etc/drbd-reactor.d/linstor_db.toml:
Promoter: Resource linstor_db currently active on <unknown>
○ drbd-services@linstor_db.target
inactive
k0s-w2 sieht nur noch sich selbst – eine von drei
Stimmen, quorum:no. drbd-reactor hat die Kette sofort
gestoppt, und ohne Quorum wird k0s-w2 nicht wieder Primary.
Auf der anderen Seite haben k0s-w1 und k0s-w3
zusammen die Mehrheit:
# auf k0s-ctrl
linstor --no-utf8 --no-color resource list -r linstor_db | cut -c1-88
Erwartet (gekürzt):
| linstor_db   | k0s-ctrl | DRBD,STORAGE | Unused | Connecting(k0s-w2)                 |
| linstor_db   | k0s-w1   | DRBD,STORAGE | InUse  | Connecting(k0s-w2)                 |
| linstor_db   | k0s-w2   | DRBD,STORAGE | Unused | Connecting(k0s-w3,k0s-ctrl,k0s-w1) |
| linstor_db   | k0s-w3   | DRBD,STORAGE | Unused | Connecting(k0s-w2)                 |
Die API war im Labor 21 Sekunden weg, dann lief der Controller auf
k0s-w1 – und nur dort. Netz wiederherstellen:
# auf k0s-w2
sudo iptables -D INPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sudo iptables -D OUTPUT -p tcp -m multiport --ports 7000:7999 -j DROP
sleep 15
sudo drbdadm status linstor_db
Erwartet:
linstor_db role:Secondary
  disk:UpToDate open:no
  k0s-ctrl role:Secondary
    peer-disk:Diskless peer-client:yes
  k0s-w1 role:Primary
    peer-disk:UpToDate
  k0s-w3 role:Secondary
    peer-disk:UpToDate
Tipp: Simuliere die Trennung nicht mit
ip link set ens19 down. Im Labor hat derIPaddr2-Agent beim Neustart der Kette die Schnittstelle mit „Bringing device ens19 up“ selbst wieder hochgefahren. Und solange der Primary die Witness über das Management-Netz erreicht, bleibt er Primary: Die abgeschnittenen Secondaries markieren sich über die Witness selbst alsOutdated.
Fortschritt speichern? Kostenlos registrieren
Übung: Speed-Drills
- Zeig von der Witness aus, wo der Controller gerade läuft. Zeitziel: 10 s
- Zeig, auf welchem Node die VIP liegt. Zeitziel: 30 s
- Zeig, welche Units zur Kette auf dem aktiven Node gehören. Zeitziel: 20 s
- Zeig, dass der Controller auf
k0s-w3nicht ohne Mount starten würde. Zeitziel: 20 s
Lösung
# auf k0s-ctrl
sudo drbdadm status linstor_db | grep Primary
for h in k0s-w1 k0s-w2 k0s-w3; do ssh $h 'ip -br addr show ens19' | grep -q '\.100/' \
  && echo $h; done
ssh k0s-w1 'sudo drbd-reactorctl status linstor_db'
ssh k0s-w3 'systemctl cat linstor-controller | grep Condition'
Erwartet (gekürzt):
  k0s-w1 role:Primary
k0s-w1
...
● ├─ var-lib-linstor.mount
● ├─ ocf.rs@linstor_vip_linstor_db.service
● └─ linstor-controller.service
ConditionPathIsMountPoint=/var/lib/linstor
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
# auf k0s-ctrl
linstor --no-utf8 --no-color resource list -r linstor_db
Erwartet: drei Kopien UpToDate auf den
Workern, eine davon InUse, Witness Diskless,
alle Ok.
# auf k0s-ctrl
for h in k0s-w1 k0s-w2 k0s-w3; do
  ssh $h 'sudo drbd-reactorctl status linstor_db | sed -n 2p'
done
Erwartet: einmal
currently active on this node, zweimal
active on node '…' mit demselben Namen.
# auf k0s-ctrl
for h in k0s-w1 k0s-w2 k0s-w3; do ssh $h systemctl is-enabled linstor-controller; done
Erwartet: dreimal disabled – nur
drbd-reactor startet den Controller.
# auf k0s-ctrl
ssh k0s-w2 'sudo iptables -S | grep -c 7000:7999'
Erwartet: 0 – die Regeln aus Drill 8
sind weg.
Challenge
Für eine Wartung an k0s-w1 soll der Controller gezielt
auf k0s-w3 – nicht auf k0s-w2.
evict allein überlässt die Wahl dem schnellsten
Kandidaten.
Hinweis: evict maskiert die Kette auf
dem eigenen Node. Das kannst du auf einem anderen Node auch von
Hand.
Lösung
# auf k0s-w2
sudo systemctl mask --runtime drbd-services@linstor_db.target
# auf k0s-w1
sudo drbd-reactorctl evict linstor_db# auf k0s-w2
sudo systemctl unmask --runtime drbd-services@linstor_db.target
sudo drbd-reactorctl status linstor_db | sed -n 2pErwartet (gekürzt):
Created symlink /run/systemd/system/drbd-services@linstor_db.target → /dev/null.
...
Node 'k0s-w3' took over
...
Removed "/run/systemd/system/drbd-services@linstor_db.target".
Promoter: Resource linstor_db currently active on node 'k0s-w3'
--runtime legt die Maske unter /run ab, ein
Neustart hebt sie also auch auf.
drbd-reactorctl evict --keep-masked hilft hier nicht: Auf
einem inaktiven Node meldet es nur
nothing to do on this node, ignoring.
Fortschritt speichern? Kostenlos registrieren
Aufräumen
# auf k0s-w2
sudo rm -rf /var/lib/linstor.leer
Dasselbe auf k0s-w3. /var/lib/linstor.orig
auf k0s-w1 bleibt vorerst als Sicherung.
Hast du die Challenge gemacht, läuft der Controller jetzt auf
k0s-w3. Hol ihn mit demselben Griff zurück nach
k0s-w1, damit dein Stand zu den Ausgaben der nächsten Tage
passt: auf k0s-w2 maskieren, auf k0s-w3
räumen, auf k0s-w2 wieder freigeben.
# auf k0s-w2
sudo systemctl mask --runtime drbd-services@linstor_db.target
# auf k0s-w3
sudo drbd-reactorctl evict linstor_db# auf k0s-w2
sudo systemctl unmask --runtime drbd-services@linstor_db.target
sudo drbd-reactorctl status linstor_db | sed -n 2pErwartet (gekürzt):
Created symlink /run/systemd/system/drbd-services@linstor_db.target → /dev/null.
...
Evicting linstor_db
...
Node 'k0s-w1' took over
Re-enabling linstor_db
...
Removed "/run/systemd/system/drbd-services@linstor_db.target".
Promoter: Resource linstor_db currently active on node 'k0s-w1'
Interview-Notiz
- Wie machst du den LINSTOR-Controller hochverfügbar? Datenbank auf einer DRBD-Ressource mit drei Kopien, drbd-reactor startet Mount, VIP und Controller dort, wo sie Primary ist. Kein Pacemaker nötig.
- Was passiert mit den Volumes, wenn der Controller ausfällt? Nichts. DRBD repliziert weiter. Nur Anlegen, Löschen und Ändern warten.
- Wie verhinderst du zwei Controller? DRBD-Quorum: Nur wer die Mehrheit sieht, wird Primary, und nur auf dem Primary läuft der Controller.
Enterprise-Notiz
- Drei Kopien von
linstor_dbauf drei Fehlerbereiche verteilen; die Witness nicht im selben Rack wie zwei Kandidaten. - Datenbank regelmäßig sichern
(
linstor controller backupdboder Kopie des Dateisystems) und vor jedem LINSTOR-Update – Tag 15. - Statt H2 ist auch eine externe Datenbank (PostgreSQL) oder der
Kubernetes-API-Server als Backend möglich; dann fällt
linstor_dbweg, die Abhängigkeit wandert aber mit. - drbd-reactor überwachen:
:9942/metrics(Tag 17) unddrbd-reactorctl statusin den Wartungs-Runbooks.