Tag 15: Wettkampf: Desaster-Drills
Ziel: Du findest und behebst acht typische Störungen des Portals unter Zeitdruck – vom widerrufenen Token bis zur verschwundenen Datenbank. · Dauer: ca. 120 min · Voraussetzung: Tag 14
Briefing
- Ein Skript baut jeweils einen Fehler in dein Lab ein:
sabotage.sh <n>. Mitsabotage.sh <n> --resetist er wieder weg,sabotage.sh reset-allräumt alles auf. - Pro Szenario: Lage lesen, Uhr starten, Symptom ansehen, mit der Diagnose die Ursache beweisen, Fix anwenden, Gegenprobe machen.
- Erst selbst probieren, dann Diagnose und Fix im Buch lesen. Die Zeiten trägst du am Ende in die Bewertungstabelle ein.
- Faustregel: erst eingrenzen (Browser, Backend, Katalog, Forgejo, Datenbank), dann in genau dieser Schicht ins Log schauen.
Browser ─ Frontend :3000 ─ Backend :7007 ─┬─ Katalog ─── Gitea-Provider ─┐
404, Login  app.extensions  Log, HTTP 500 ├─ Scaffolder ─ publish:gitea ─┼─► Forgejo
                                          ├─ TechDocs ── mkdocs (venv) ──┘   :3300
                                          └─ PostgreSQL :5432 (bs-postgres)
Vorausgesetzt wird der Stand Ende Tag 14: Gitea-Provider,
kranich/org, kranich/templates, TechDocs mit
venv, Startseite aus Tag 9, Login und Policy aus Tag 12, PostgreSQL aus
Tag 13. Vor dem Start muss das Gelände grün sein:
source ~/backstage-lab/setup/env.sh
mkdir -p ~/backstage-lab/tag15 && cd ~/backstage-lab/tag15
docker start bs-postgres >/dev/null && ~/backstage-lab/setup/portal.sh start
~/backstage-lab/setup/check.sh | tail -3
~/backstage-lab/code/tag15/sabotage.sh status
Erwartet (statt der ersten Zeile ggf. „✔ läuft bereits: …“):
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
✔ Backend bereit (http://localhost:7007)
✔ Frontend erreichbar (http://localhost:3000)
✔ Katalog-API mit Lab-Token
✔ Status gezeigt
Das Skript schreibt nur in dein Lab: Forgejo (Repos, Team, Token),
die local-Datei, das venv und den Postgres-Container. Alle Befehle unten
setzen ein Terminal mit geladenem env.sh voraus. Kurzform
für die Drills:
alias sabotage=~/backstage-lab/code/tag15/sabotage.shDrill 1: Der Bot kommt nicht mehr rein
Zeitlimit: 10 min
Lage: Montagmorgen. Jemand hat in Forgejo „alte
Tokens aufgeräumt”. Seitdem kommen Änderungen an
catalog-info.yaml nicht mehr im Portal an.
sabotage 1Erwartet:
✔ Szenario 1 ausgelöst – viel ErfolgSymptom: Nach spätestens einer Minute zeigt jede Entity aus Forgejo eine rote Fehlerkarte wie in der Abbildung. Die Daten selbst sind noch da – der Katalog behält den letzten guten Stand.
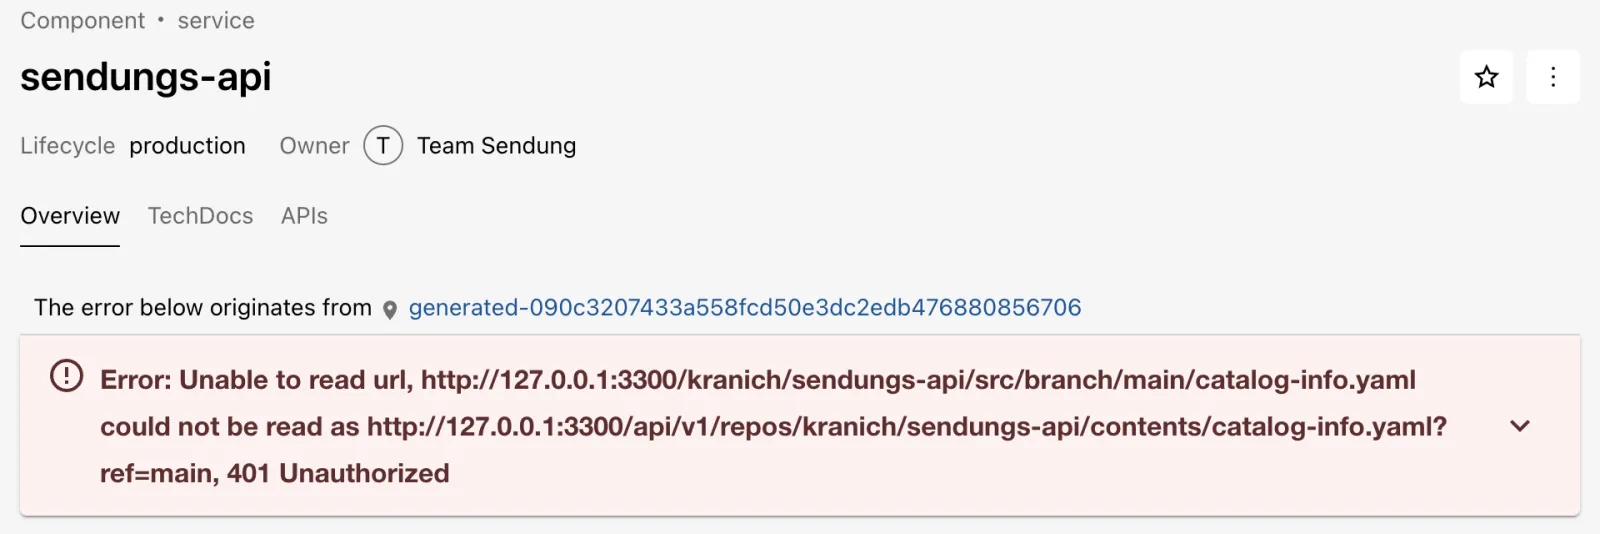
Diagnose: Wie viele Locations sind betroffen, und was sagt der Provider?
bs 'catalog/entities?filter=kind=location' \
  | jq -r '.[].status.items[]?.message' | grep -o '[0-9]* Unauthorized' | uniq -c
~/backstage-lab/setup/portal.sh logs 300 | sed 's/\x1b\[[0-9;]*m//g' \
  | grep -o 'Failed to fetch page [^,]*, status: [0-9]*' | tail -1
Erwartet (die Zahl hängt von deinem Katalog ab):
   6 401 Unauthorized
Failed to fetch page 1 of repos, status: 401
401 heißt: Forgejo kennt den Absender nicht. Gegenprobe mit dem Token, das das Portal benutzt:
curl -s -H "Authorization: token $FORGEJO_TOKEN" "$FORGEJO/api/v1/user" \
  | jq -r .message | grep -o 'access token does not exist'
Erwartet:
access token does not existFix: Neues Token erzeugen (up.sh legt
eins an, wenn die Datei fehlt), env.sh neu laden und das
Portal neu starten – die Konfiguration liest
${FORGEJO_TOKEN} nur beim Start.
rm ~/backstage-lab/setup/forgejo-token
~/backstage-lab/setup/up.sh
source ~/backstage-lab/setup/env.sh
curl -s -o /dev/null -w '%{http_code}\n' -H "Authorization: token $FORGEJO_TOKEN" \
  "$FORGEJO/api/v1/user"
~/backstage-lab/setup/portal.sh restart
sleep 30
bs 'catalog/entities?filter=kind=location' | jq '[.[].status.items[]?] | length'
sabotage 1 --reset
Erwartet:
✔ Forgejo läuft: http://127.0.0.1:3300 (lab-admin / lab-admin-pw-123)
200
✔ gestoppt
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
0
✔ Szenario 1 zurückgesetzt
Warum kein 403? 403 hieße „bekannt, aber nicht erlaubt” – das ist Drill 4.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Das Team heißt jetzt anders
Zeitlimit: 10 min
Lage: Team Sendung hat sich in
kranich/org umbenannt. Seitdem meldet die Seite von
sendungs-api eine gelbe Warnung, und Anna sieht unter „Owned” nichts
mehr.
sabotage 2Symptom: Nach etwa einer Minute steht auf der
Entity-Seite von sendungs-api die Warnung wie in der Abbildung. Der
Owner wird nur noch als Text team-sendung angezeigt, nicht
mehr als Gruppe „Team Sendung”.
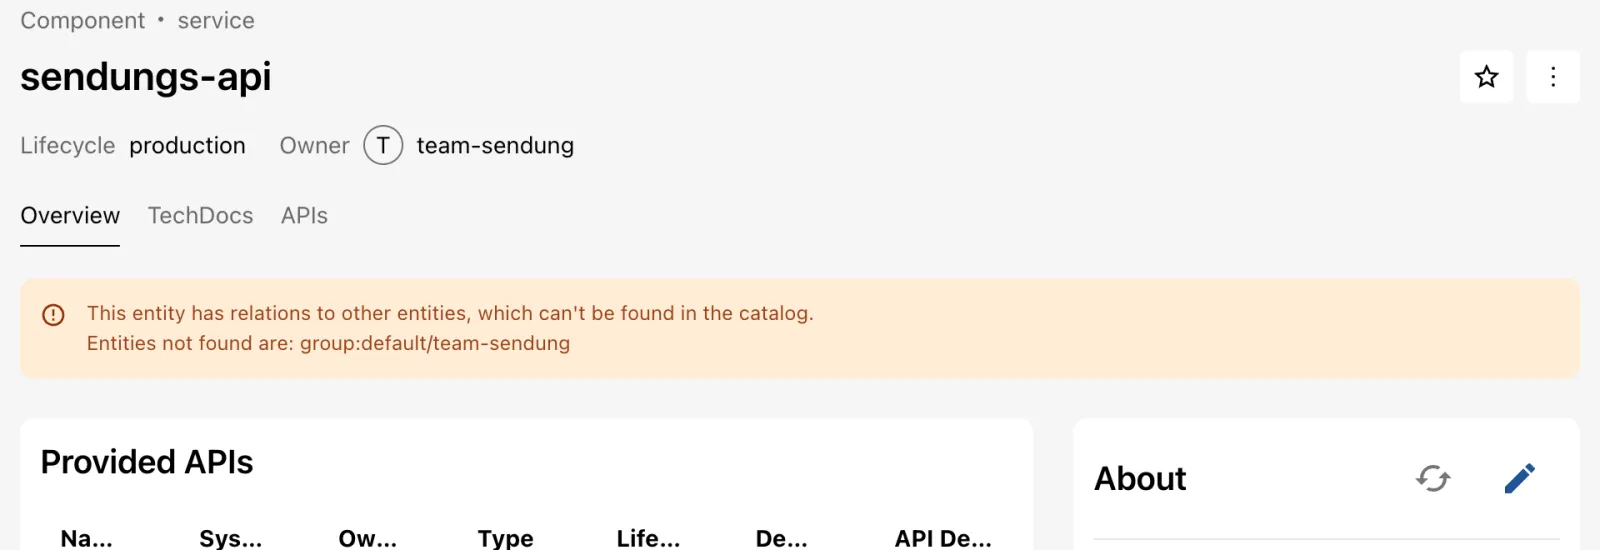
Diagnose: Welche Owner gibt es, die keine Gruppe im
Katalog sind? Und wer hat zuletzt an kranich/org
gearbeitet?
bs 'catalog/entities?fields=spec.owner' | jq -r '.[].spec.owner // empty' \
  | sort -u > owner.txt
bs 'catalog/entities?filter=kind=group&fields=metadata.name' \
  | jq -r '.[].metadata.name' | sort > gruppen.txt
comm -23 owner.txt gruppen.txt
curl -sf "$FORGEJO/api/v1/repos/kranich/org/commits?limit=2" \
  | jq -r '.[] | "\(.sha[0:7]) \(.commit.message | split("\n")[0])"'
Erwartet (SHAs weichen ab):
team-sendung
f700b3d Team Sendung heißt jetzt team-sendungen
fbf3b13 Initialer Stand
Fix: Zwei Wege: den Owner in allen Repos nachziehen oder die Umbenennung zurücknehmen. Hier ist Letzteres richtig, denn alle Entities von Team Sendung und zwei User hängen am alten Namen:
git clone -q http://lab-admin:[email protected]:3300/kranich/org.git org-fix
cd org-fix
git -c user.name="Lab Admin" -c [email protected] revert --no-edit HEAD \
  | head -1
git push -q origin main && cd .. && rm -rf org-fix
sleep 60
bs catalog/entities/by-name/group/default/team-sendung | jq -r .metadata.name
sabotage 2 --reset
Erwartet:
[main b2e0ada] Revert "Team Sendung heißt jetzt team-sendungen"
team-sendung
✔ Szenario 2 zurückgesetzt
Die alte Gruppe war nach der Umbenennung verwaist und wurde gelöscht, die Relationen der Components zeigten ins Leere. Backstage benennt Referenzen nie automatisch um.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Das neue Template taucht nicht auf
Zeitlimit: 15 min
Lage: Team Web hat im eigenen Repo
kranich/vorlagen-web ein Template „Statische Website”
angelegt. Der Gitea-Provider findet jedes Repo – aber unter
Create erscheint es nicht.
sabotage 3Symptom: Auch nach zwei Minuten zeigt
Create nur die Templates aus
kranich/templates wie in der Abbildung. Kein Fehler im GUI,
keine Fehlerkarte.
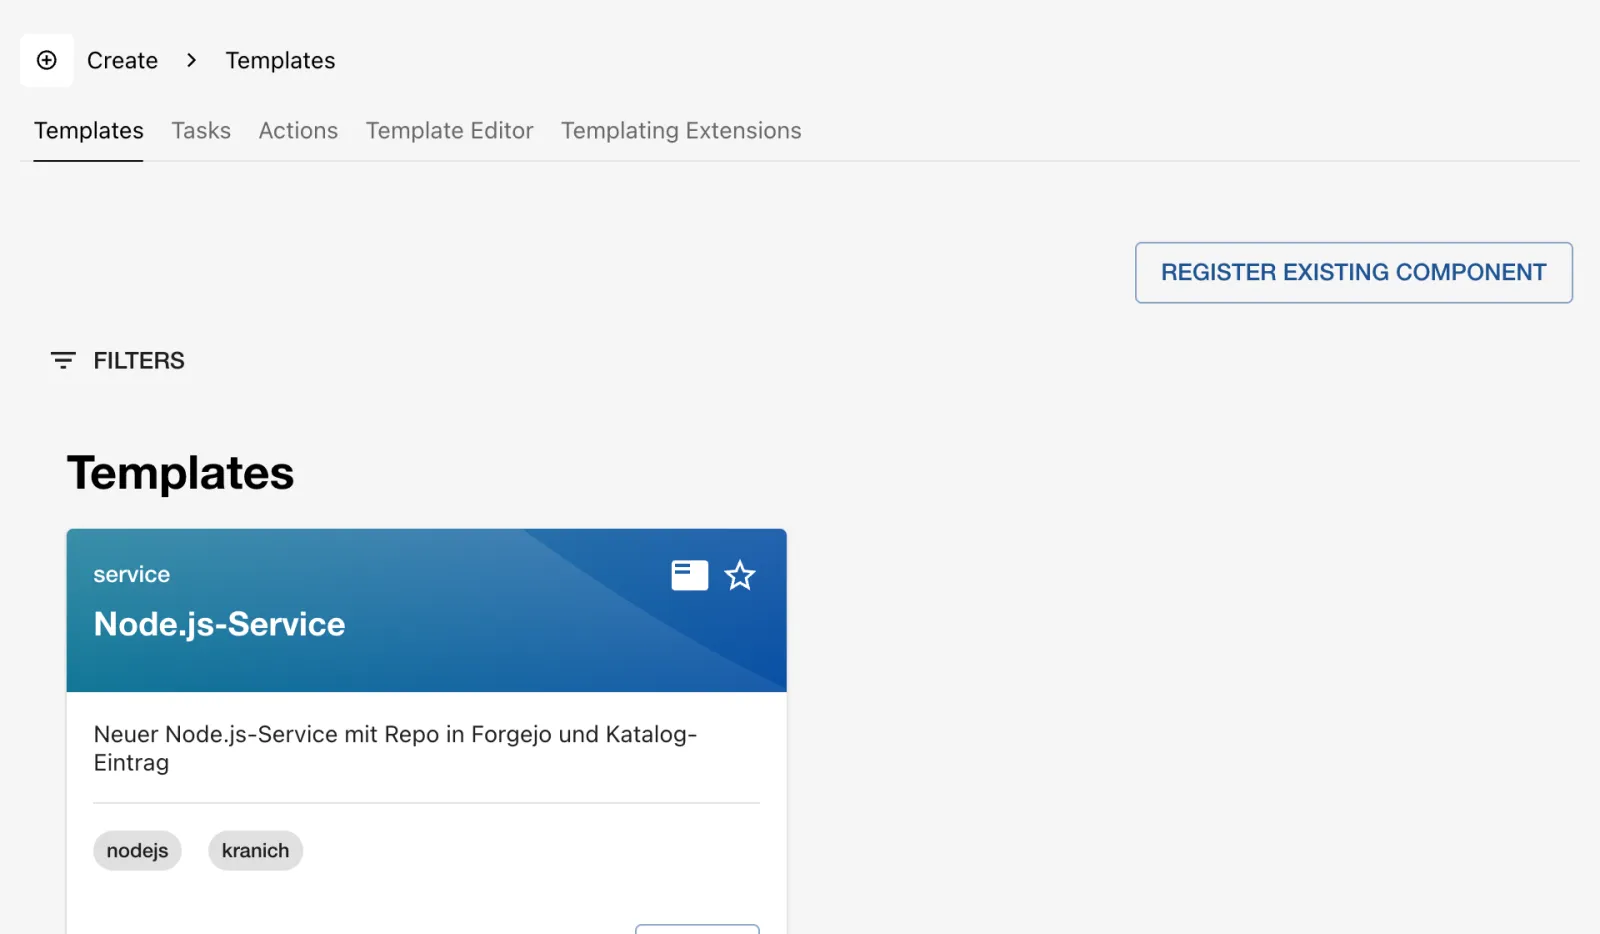
Diagnose: Weder das Template noch seine Location sind im Katalog. Wenn das GUI schweigt, steht der Grund im Backend-Log:
bs 'catalog/entities?filter=kind=template' | jq -r '.[].metadata.name'
bs 'catalog/entities?filter=kind=location' | jq -r '.[].spec.target // empty' \
  | grep -c vorlagen
~/backstage-lab/setup/portal.sh logs 300 | sed 's/\x1b\[[0-9;]*m//g' \
  | grep -o 'Entity template:[^ ]*\|is not of an allowed kind' | tail -2
Erwartet (plus deine Templates aus Tag 6):
node-service
0
Entity template:default/statische-website
is not of an allowed kind
Die Regel aus Tag 5 erlaubt Template nur unter
kranich/templates/**.
Fix: Entweder das Template nach
kranich/templates umziehen (die saubere Lösung für ein
zentrales Plattform-Team) oder die Regel bewusst um ein Muster für
Team-Repos erweitern. Hier die zweite Variante:
cd ~/backstage-lab/portal
yq -i '(.catalog.rules[] | select(.allow[] == "Template") | .locations) +=
  [{"type": "url", "pattern": "http://127.0.0.1:3300/kranich/vorlagen-*/**"}]' \
  app-config.local.yaml
yq '.catalog.rules[] | select(.allow[] == "Template")' app-config.local.yaml
~/backstage-lab/setup/portal.sh restart && sleep 45
bs 'catalog/entities?filter=kind=template' | jq -r '.[].metadata.name'
Erwartet:
allow: [Template]
locations:
  - type: url
    pattern: http://127.0.0.1:3300/kranich/templates/**
  - type: url
    pattern: http://127.0.0.1:3300/kranich/vorlagen-*/**
✔ gestoppt
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
node-service
statische-website
sabotage 3 --reset löscht das Repo und entfernt das
Muster wieder aus der local-Datei (wirksam ab dem nächsten
Neustart).
Achtung:
select(.allow == ["Template"])findet nichts – yq vergleicht Listen nicht als Ganzes. Darum.allow[] == "Template".
Fortschritt speichern? Kostenlos registrieren
Drill 4: Das Template scheitert beim Anlegen des Repos
Zeitlimit: 10 min
Lage: Ein Admin hat in Forgejo die Teams der Org
kranich „bereinigt”. Seitdem scheitert jeder Golden Path.
Du startest den Task per API mit dem Lab-Token (ein Service-Principal,
die Policy aus Tag 12 greift nicht):
sabotage 4
cat > auftrag.json <<'EOF'
{"templateRef": "template:default/node-service",
 "values": {"name": "retouren-api", "description": "Retouren erfassen",
   "owner": "group:default/team-sendung", "port": 8083, "techdocs": false,
   "repoUrl": "127.0.0.1:3300?owner=kranich&repo=retouren-api"}}
EOF
ID=$(bs scaffolder/v2/tasks -X POST -H 'Content-Type: application/json' \
  -d @auftrag.json | jq -r .id)
sleep 15; bs scaffolder/v2/tasks/$ID | jq -r .status
echo "$APP/create/tasks/$ID"
Erwartet (ID weicht ab):
✔ Szenario 4 ausgelöst – viel Erfolg
failed
http://localhost:3000/create/tasks/2a84c1fa-ba6e-4f6d-ae6e-b15fffcd8323
Symptom: Öffne die ausgegebene URL. Erwartet: Schritt Repo in Forgejo anlegen ist rot, darüber die Fehlermeldung wie in der Abbildung.
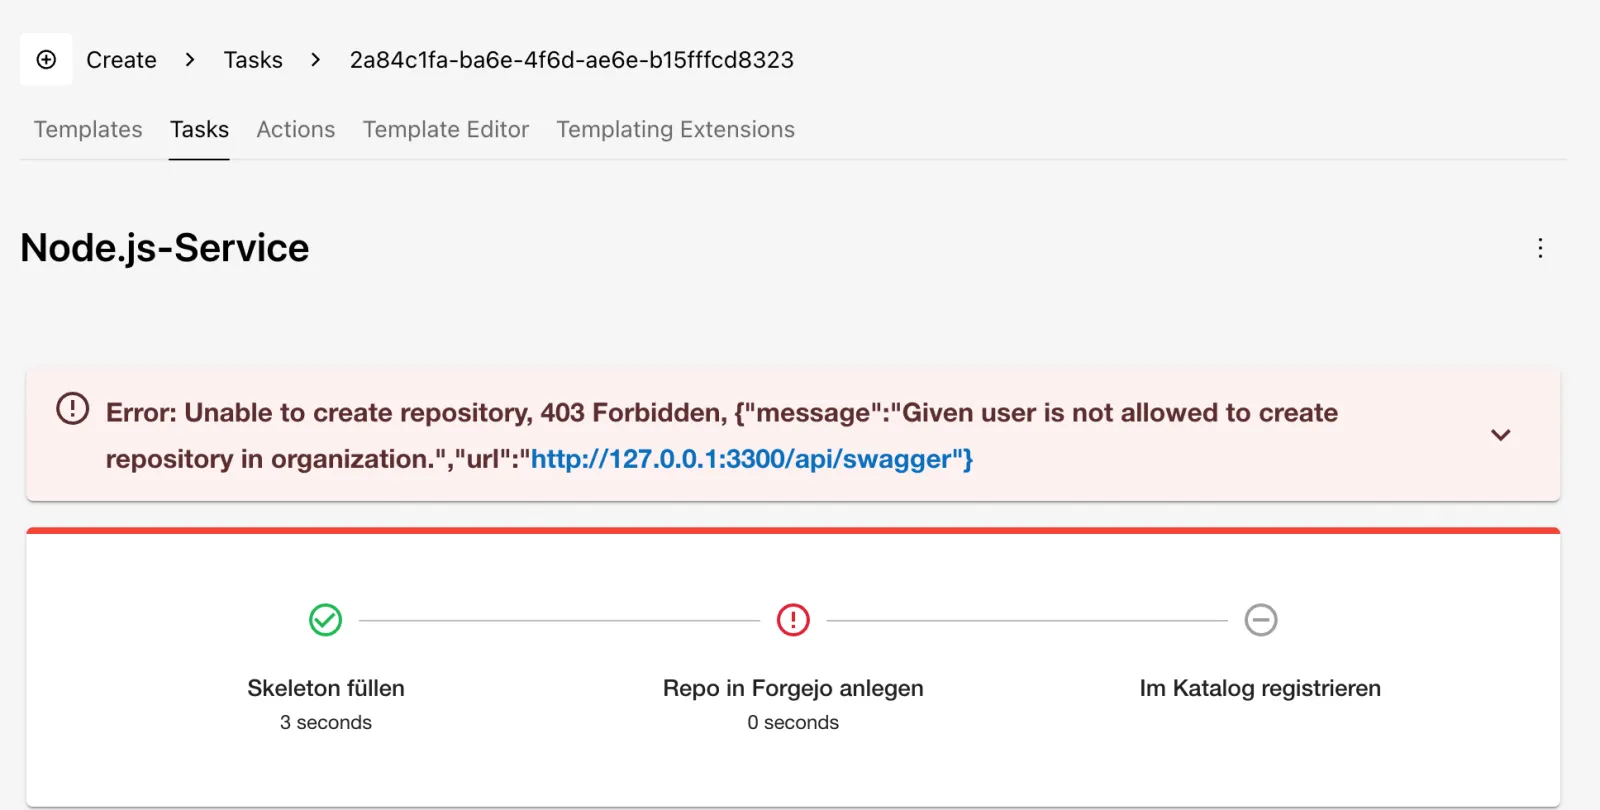
Diagnose: Dieselbe Meldung im Task-Log, dann die
Frage an Forgejo, in welchen Orgs der Bot Mitglied ist und wer im Team
Owners steht:
bs "scaffolder/v2/tasks/$ID/events" | jq -r '.[] | select(.type=="log")
  | .body.message' | grep -o 'Unable to create repository, 403 Forbidden'
curl -s -H "Authorization: token $FORGEJO_TOKEN" "$FORGEJO/api/v1/user/orgs" \
  | jq -c '[.[].username]'
team=$(curl -sf -u "$ADMIN" "$FORGEJO/api/v1/orgs/kranich/teams" \
  | jq -r '.[] | select(.name=="Owners").id')
curl -sf -u "$ADMIN" "$FORGEJO/api/v1/teams/$team/members" | jq -c '[.[].login]'
Erwartet:
Unable to create repository, 403 Forbidden
[]
["lab-admin"]
Das Token ist gültig (sonst 401), aber dem Bot fehlt das Recht, in
kranich Repos anzulegen. Lesen klappt weiter, weil die
Repos öffentlich sind.
Fix: Bot zurück ins Team Owners (das
macht auch seed.sh) und den Task wiederholen:
curl -sf -u "$ADMIN" -X PUT "$FORGEJO/api/v1/teams/$team/members/backstage-bot" \
  -w '%{http_code}\n'
ID=$(bs scaffolder/v2/tasks -X POST -H 'Content-Type: application/json' \
  -d @auftrag.json | jq -r .id)
sleep 15; bs scaffolder/v2/tasks/$ID | jq -r .status
sabotage 4 --reset
Erwartet:
204
completed
✔ Szenario 4 zurückgesetzt
Der Reset löscht kranich/retouren-api und seine
Katalog-Location wieder. Im Team Owners darf der Bot mehr
als nötig – in Produktion genügt ein eigenes Team mit „Repos anlegen”
(Enterprise-Notiz).
Fortschritt speichern? Kostenlos registrieren
Drill 5: Die Startseite ist weg
Zeitlimit: 10 min
Lage: Ein Kollege wollte nur lokal die Seite
„App-Struktur” umbenennen und hat dafür einen Block
app.extensions in die local-Datei geschrieben. Das Skript
startet das Portal neu.
sabotage 5Erwartet:
• Portal wird neu gestartet …
✔ Szenario 5 ausgelöst – viel Erfolg
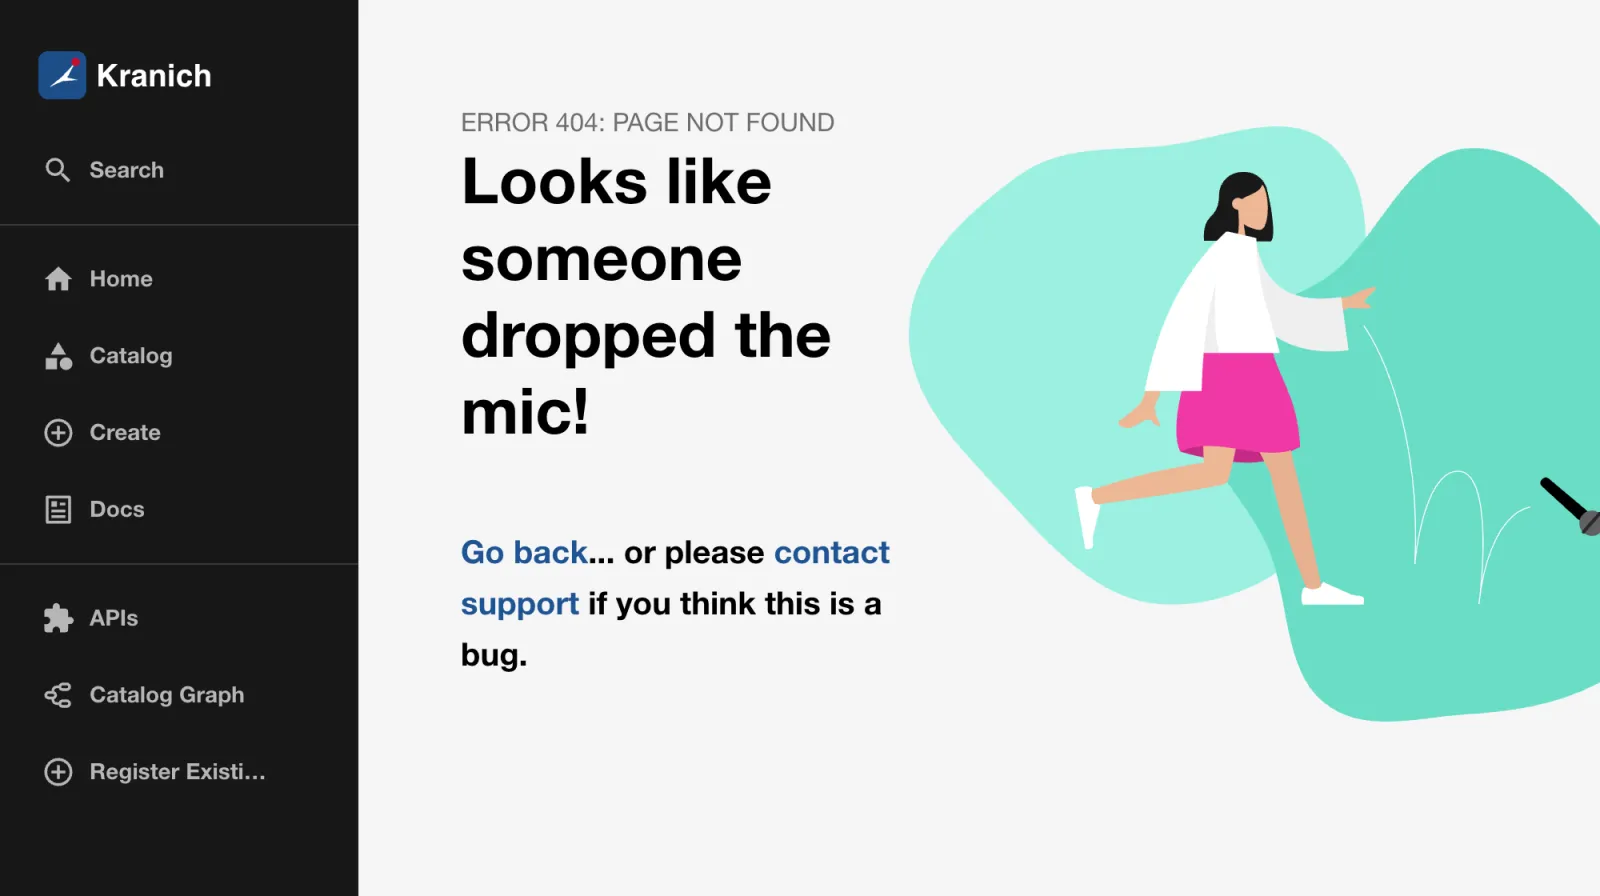
Symptom: http://localhost:3000/ zeigt
die 404-Seite wie in der Abbildung. Der Katalog unter
/catalog geht noch. curl $APP/ liefert
trotzdem 200 – das 404 entsteht erst im Browser, wenn das Routing der
App keine Seite für / findet.
Diagnose: Welche Datei definiert
app.extensions, und was kommt beim Frontend nach dem
Zusammenführen an?
cd ~/backstage-lab/portal
grep -n 'extensions:' app-config*.yaml
yarn backstage-cli config:print --frontend --lax 2>/dev/null | yq '.app.extensions'
Erwartet:
app-config.local.yaml:3:  extensions:
app-config.yaml:8:  extensions:
- page:app-visualizer:
    config:
      title: Struktur
Listen werden beim Zusammenführen nicht gemischt, sondern ersetzt
(Tag 9): Von deinen Extensions aus app-config.yaml bleibt
nur die eine aus der local-Datei übrig. page:home mit
path: / ist weg.
Fix: Block aus der local-Datei entfernen (die
Umbenennung gehört in die Liste in app-config.yaml), neu
starten, Seite neu laden:
yq -i 'del(.app.extensions)' app-config.local.yaml
~/backstage-lab/setup/portal.sh restart
sabotage 5 --reset
Erwartet: die Startseite aus Tag 9 unter
http://localhost:3000/.
✔ gestoppt
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
✔ Szenario 5 zurückgesetzt
Fortschritt speichern? Kostenlos registrieren
Drill 6: TechDocs baut nicht mehr
Zeitlimit: 10 min
Lage: Nach einem Python-Update „funktioniert TechDocs nicht mehr”. Die schon gebauten Seiten liefert das Portal aus dem Speicher; neu gebaut wird nichts.
sabotage 6Symptom: Der Tab TechDocs von sendungs-api baut die Doku neu und meldet nach einigen Sekunden einen Fehler wie in der Abbildung – ähnlich wie das Docker-Fehlerbild aus Tag 7, nur mit anderer Ursache.
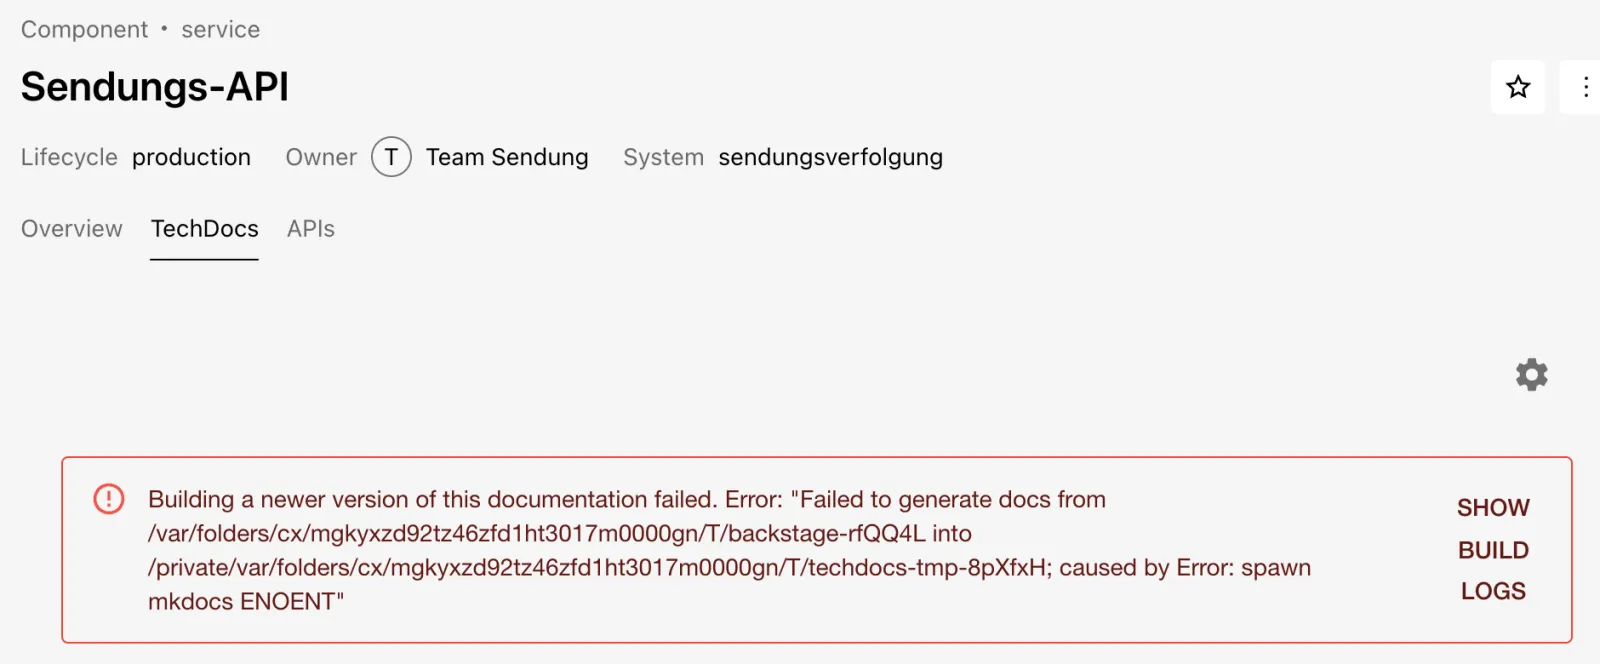
Diagnose: Den Build ohne Browser anstoßen (Tag 7) und nach dem Generator suchen:
bs techdocs/sync/default/component/sendungs-api -N \
  | grep -o 'spawn mkdocs ENOENT' | head -1
command -v mkdocs || echo "mkdocs: nicht gefunden"
ls ~/backstage-lab/venv/bin | grep mkdocs
pip show mkdocs | grep -E '^(Version|Location)'
Erwartet (Python-Version kann abweichen):
spawn mkdocs ENOENT
mkdocs: nicht gefunden
mkdocs-get-deps
Version: 1.6.1
Location: /Users/<du>/backstage-lab/venv/lib/python3.14/site-packages
ENOENT beim spawn heißt: Das Programm liegt
nicht im PATH des Backends. Das Paket ist installiert, nur
das Startskript venv/bin/mkdocs fehlt.
Tipp: Liefert
techdocs/syncnur{"updated":false}ohne Log, warte eine Minute: Nach einem erfolgreichen Build prüft TechDocs dieselbe Entity höchstens einmal pro Minute erneut.
Fix: Das Paket ohne Abhängigkeiten neu installieren
– pip legt das Startskript wieder an. Ein Neustart ist nicht nötig, das
Backend sucht mkdocs bei jedem Build neu.
pip install -q --force-reinstall --no-deps \
  "mkdocs==$(pip show mkdocs | awk '/^Version/{print $2}')"
command -v mkdocs
bs techdocs/sync/default/component/sendungs-api -N | grep -A1 'event: finish'
sabotage 6 --reset
Erwartet:
/Users/<du>/backstage-lab/venv/bin/mkdocs
event: finish
data: {"updated":true}
✔ Szenario 6 zurückgesetzt
Fortschritt speichern? Kostenlos registrieren
Drill 7: Die Datenbank ist weg
Zeitlimit: 5 min
Lage: Nach dem Mittag „hängt” das Portal. Das
Backend läuft laut portal.sh, aber nichts lädt mehr.
sabotage 7Symptom: Lade das Portal im Browser neu und klicke bei Guest auf Enter. Die Anmeldung scheitert mit der irreführenden Meldung wie in der Abbildung (im Entwicklungsmodus als rotes Fehler-Overlay). Wer noch angemeldet ist, sieht leere Listen und Fehlerhinweise.
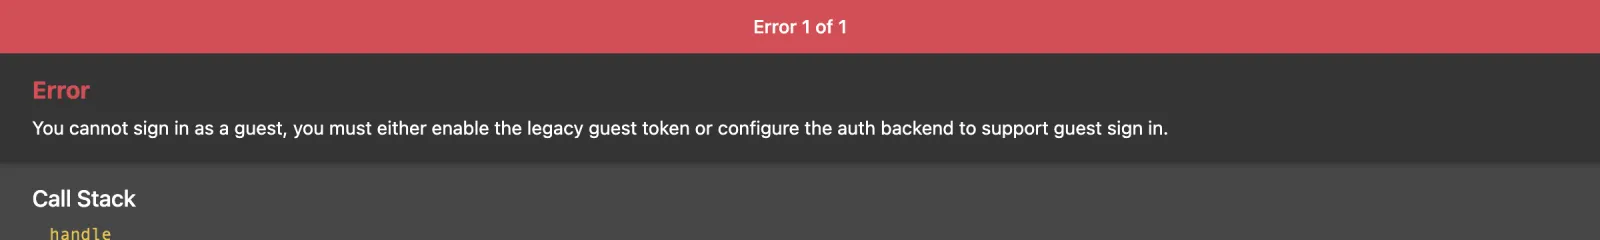
Diagnose: Die Readiness prüft nur, ob das Backend hochgefahren ist – nicht, ob die Datenbank antwortet. Die APIs dagegen liefern 500:
~/backstage-lab/setup/portal.sh status
curl -s -o /dev/null -w '%{http_code}\n' -H "Authorization: Bearer $BACKSTAGE_TOKEN" \
  "$BACKSTAGE/api/catalog/entities?limit=1"
~/backstage-lab/setup/portal.sh logs 1000 | sed 's/\x1b\[[0-9;]*m//g' \
  | grep -o 'GET /api/auth/guest/refresh HTTP/1.1" 500\|ECONNREFUSED [0-9.:]*' \
  | sort | uniq -c
docker ps -a --filter name=bs-postgres --format '{{.Names}}: {{.Status}}'
Erwartet (Zahlen und Zeiten weichen ab):
✔ läuft: http://localhost:3000
500
    948 ECONNREFUSED 127.0.0.1:5432
      2 GET /api/auth/guest/refresh HTTP/1.1" 500
bs-postgres: Exited (0) 2 minutes ago
Der Login braucht die Datenbank: Das Auth-Plugin legt dort u. a. seine Signierschlüssel ab und meldet im Log:
auth error Request failed with status 500 connect ECONNREFUSED 127.0.0.1:5432Die Zeilen mit ECONNREFUSED fluten das Log (mehrere pro
Sekunde), darum die 1000 Zeilen.
Fix: Container starten, auf Postgres warten, Portal neu starten (frische Verbindungen für alle Plugins):
docker start bs-postgres
until docker exec bs-postgres pg_isready -h 127.0.0.1 -U backstage; do sleep 1; done
~/backstage-lab/setup/portal.sh restart
bs 'catalog/entities?limit=1' | jq length
sabotage 7 --reset
Erwartet (ggf. vorher ein paar Zeilen
127.0.0.1:5432 - no response):
bs-postgres
127.0.0.1:5432 - accepting connections
✔ gestoppt
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
1
✔ Szenario 7 zurückgesetzt
Tipp: Nach jedem Neustart des Rechners ist das der häufigste „Fehler” im Lab. In Produktion gehört die Datenbank in das Monitoring (eigener Check auf Postgres),
/.backstage/health/v1/readinessallein genügt nicht.
Fortschritt speichern? Kostenlos registrieren
Drill 8: Zwei Repos, ein Name
Zeitlimit: 15 min
Lage: Team Sendung baut die API neu und hat dafür
kranich/sendungs-api-neu angelegt –
catalog-info.yaml einfach kopiert, Beschreibung angepasst.
Das Portal zeigt aber weiter die alte Beschreibung, und eine Entity für
das neue Repo gibt es nicht.
sabotage 8Symptom: Auch nach zwei Minuten zeigt die About-Karte von sendungs-api die alte Beschreibung wie in der Abbildung. Kein Fehler im GUI, keine Fehlerkarte.
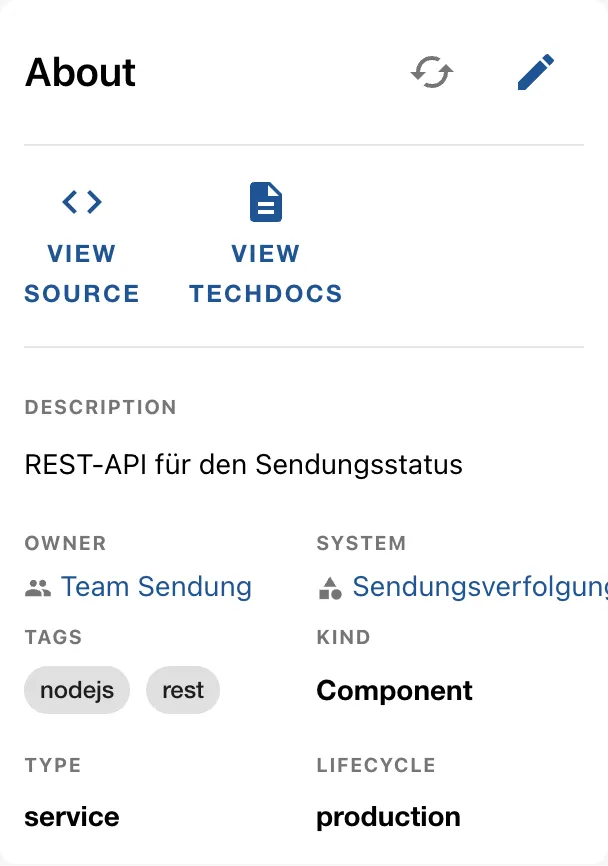
Diagnose: Woher stammt die Entity, und was sagt das Log zum neuen Repo?
bs catalog/entities/by-name/component/default/sendungs-api \
  | jq -r '.metadata.annotations["backstage.io/managed-by-location"]'
~/backstage-lab/setup/portal.sh logs 300 | sed 's/\x1b\[[0-9;]*m//g' \
  | grep -o 'conflicting entityRef component:[^ ]*' | sort | uniq -c
Erwartet:
url:http://127.0.0.1:3300/kranich/sendungs-api/src/branch/main/catalog-info.yaml
      1 conflicting entityRef component:default/sendungs-api
Die vollständige Logzeile (Level warn, Plugin
catalog) lautet
Detected conflicting entityRef component:default/sendungs-api already referenced by url:…/kranich/sendungs-api/… and now also url:…/kranich/sendungs-api-neu/….
Wer zuerst da war, gewinnt (Tag 3). Die Warnung kommt nur einmal, kurz
nachdem der Provider das neue Repo gefunden hat – ist sie aus den
letzten 300 Zeilen schon herausgerutscht, such mit einer größeren
Zahl.
Fix: Ein Entity-Name ist pro Kind und Namespace eindeutig. Die Kopie bekommt einen eigenen Namen:
git clone -q \
  http://lab-admin:[email protected]:3300/kranich/sendungs-api-neu.git neu
cd neu
sed -i.bak 's/^  name: sendungs-api$/  name: sendungs-api-neu/' catalog-info.yaml
rm catalog-info.yaml.bak && grep '^  name:' catalog-info.yaml
git -c user.name="Lab Admin" -c [email protected] commit -qam "Eigener Name"
git push -q origin main && cd .. && rm -rf neu
sleep 90
bs catalog/entities/by-name/component/default/sendungs-api-neu \
  | jq -r .metadata.description
sabotage 8 --reset
Erwartet:
  name: sendungs-api-neu
Sendungs-API v2 – neue Implementierung in Go
✔ Szenario 8 zurückgesetzt
Soll die neue Implementierung den alten Namen übernehmen, muss die
alte Quelle zuerst weg: Repo archivieren oder
catalog-info.yaml dort löschen, warten, bis die Entity
verwaist und entfernt ist – erst dann gewinnt die neue Location.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
Alle Sabotagen zurücksetzen, dann Gelände und Szenarien prüfen. Das
Skript liegt unter
~/backstage-lab/code/tag15/kontrolle.sh:
#!/usr/bin/env bash
# kontrolle.sh – Kontrollpunkt Tag 15 (✔/✘): alle acht Sabotagen behoben?
# Exit-Code = Anzahl Fehler.
source "${LAB:-$HOME/backstage-lab}/setup/env.sh"
PG="${PG:-bs-postgres}"
fail=0
t() { if eval "$2" >/dev/null 2>&1; then echo "✔ $1"
  else echo "✘ $1"; fail=$((fail+1)); fi; }
fj() { curl -sf -H "Authorization: token $FORGEJO_TOKEN" "$FORGEJO/api/v1/$1"; }
fehlt() { ! curl -sf -u "$ADMIN" "$FORGEJO/api/v1/repos/kranich/$1"; }

t "Keine Sabotage mehr aktiv" "! ls $LAB/tag15/.sabotage/aktiv-* "
t "1 Bot-Token gültig" "fj user | jq -e '.login == \"backstage-bot\"'"
t "1 Keine Processing-Errors an Locations" \
  "bs 'catalog/entities?filter=kind=location' \
     | jq -e '[.[].status.items[]?] | length == 0'"
t "2 Gruppe team-sendung im Katalog" \
  "bs catalog/entities/by-name/group/default/team-sendung"
t "3 Kein Repo kranich/vorlagen-web mehr" "fehlt vorlagen-web"
t "4 Bot darf Repos in kranich anlegen (Owners)" \
  "fj user/orgs | jq -e 'map(.username) | index(\"kranich\")'"
t "5 Keine app.extensions in der local-Datei" \
  "[ \"\$(yq '.app.extensions' $PORTAL/app-config.local.yaml)\" = null ]"
t "6 mkdocs im PATH" "command -v mkdocs"
t "7 PostgreSQL ($PG) bereit" "docker exec $PG pg_isready -h 127.0.0.1 -U backstage"
t "8 Kein Repo kranich/sendungs-api-neu mehr" "fehlt sendungs-api-neu"
exit "$fail"
sabotage reset-all
~/backstage-lab/setup/check.sh | grep -c '✔'
bash ~/backstage-lab/code/tag15/kontrolle.shErwartet:
✔ keine Sabotage mehr aktiv
9
✔ Keine Sabotage mehr aktiv
✔ 1 Bot-Token gültig
✔ 1 Keine Processing-Errors an Locations
✔ 2 Gruppe team-sendung im Katalog
✔ 3 Kein Repo kranich/vorlagen-web mehr
✔ 4 Bot darf Repos in kranich anlegen (Owners)
✔ 5 Keine app.extensions in der local-Datei
✔ 6 mkdocs im PATH
✔ 7 PostgreSQL (bs-postgres) bereit
✔ 8 Kein Repo kranich/sendungs-api-neu mehr
check.sh muss alle neun Punkte grün melden. Ein ✘ in
kontrolle.sh verrät die Nummer des Drills, den du noch
einmal anschauen solltest.
Challenge
Partner-Modus: Jemand anderes löst sabotage random aus,
während du nicht hinsiehst (alleine: Befehl ausführen, Terminal leeren).
Finde ohne Buch und ohne kontrolle.sh heraus, was kaputt
ist, behebe es und beweise es. Zeitlimit: 10 Minuten.
Hinweis: Arbeite die Schichten aus dem Briefing von außen nach innen ab: Status und API, dann Fehler an Entities, dann das Backend-Log nach Stichwörtern.
Lösung
Eine Triage, die jedes der acht Szenarien in wenigen Befehlen eingrenzt:
sabotage random
~/backstage-lab/setup/portal.sh status
curl -s -o /dev/null -w 'API: %{http_code}\n' \
  -H "Authorization: Bearer $BACKSTAGE_TOKEN" "$BACKSTAGE/api/catalog/entities?limit=1"
bs 'catalog/entities?filter=kind=location' \
  | jq -r '.[].status.items[]?.message' | cut -c1-60 | sort | uniq -c
muster='not of an allowed kind|conflicting entityRef|status: 40[13]|ENOENT'
~/backstage-lab/setup/portal.sh logs 500 | sed 's/\x1b\[[0-9;]*m//g' \
  | grep -oE "$muster|ECONNREFUSED" | sort | uniq -c
command -v mkdocs >/dev/null || echo "mkdocs fehlt"
yq '.app.extensions' ~/backstage-lab/portal/app-config.local.yaml
Lies das Ergebnis so: API 500 und ECONNREFUSED → Drill
7; status: 401 oder Unauthorized → Drill 1;
not of an allowed kind → Drill 3;
conflicting entityRef → Drill 8; mkdocs fehlt
→ Drill 6; eine Liste statt null bei
app.extensions → Drill 5. Bleibt alles still, starte einen
Template-Task (403 → Drill 4) und prüfe die Owner aus Drill 2 mit
comm. Alte Treffer im Log stammen ggf. noch aus den Drills
(z. B. conflicting entityRef aus Drill 8) – zählt nur, was
nach sabotage random neu dazukommt. Danach Auflösung und
Aufräumen:
sabotage status
sabotage reset-all
Erwartet (Beispiel):
aktiv: Szenario 2
✔ Status gezeigt
✔ Szenario 2 zurückgesetzt
✔ keine Sabotage mehr aktiv
Fortschritt speichern? Kostenlos registrieren
Bewertung
Trag deine Zeiten ein. Punkte: im Zeitlimit 3, bis zum doppelten Limit 1, sonst 0 – mit Buch gelesen zählt die Hälfte.
| Szenario | Zeitlimit | Deine Zeit | Punkte |
|---|---|---|---|
| 1 Token widerrufen (401) | 10 min | ||
| 2 Owner-Gruppe umbenannt | 10 min | ||
| 3 Template von Regel blockiert | 15 min | ||
| 4 publish:gitea mit 403 | 10 min | ||
| 5 app.extensions in local-Datei | 10 min | ||
| 6 mkdocs fehlt | 10 min | ||
| 7 PostgreSQL gestoppt | 5 min | ||
| 8 Doppelter Entity-Name | 15 min | ||
| Challenge (blind) | 10 min | ||
| Summe | 95 min | max. 27 |
Ab 21 Punkten bist du bereit für den Bereitschaftsdienst am eigenen
Portal, unter 12 lohnt sich ein zweiter Durchgang mit
sabotage random in ein paar Tagen.
Enterprise-Notiz
- Fehlerbilder als Runbooks mit genau diesem Muster (Symptom, Diagnosebefehl, Fix) neben das Portal legen – am besten als TechDocs im Repo des Plattform-Teams.
- Alarme statt Zufallsfunde: Processing-Errors, fehlgeschlagene Provider-Läufe und Scaffolder-Tasks über Logs/Metriken (Tag 14) überwachen; ablaufende Tokens mit Ablaufdatum anlegen und vor Ablauf rotieren.
- Konfiguration in CI prüfen:
backstage-cli config:checkund ein Review fürcatalog.rules,app.extensionsund Integrationen; local-Dateien gibt es in Produktion nicht. - Technische Konten (Bot) mit minimalen Rechten in einem eigenen Team,
nicht in
Owners; Team-Umbenennungen über einen Prozess, der Owner-Referenzen mitzieht. - GameDays wie dieses Kapitel regelmäßig in einer Staging-Umgebung, mit Readiness-Prüfung, die auch die Datenbank einschließt.