Tag 8: Suche und API-Doku
Ziel: Du findest alles im Portal über Suche und Such-API, weißt, wann der Index neue Entities kennt, und dokumentierst APIs als OpenAPI, AsyncAPI und GraphQL. · Dauer: ca. 90 min · Voraussetzung: Tag 7
Briefing
- Die Suche durchsucht nicht den Katalog live, sondern einen Index. Ihn füllen Kollatoren (Collators) nach Zeitplan: einer für den Katalog, einer für TechDocs.
- Die Suchmaschine (Search Engine) ist austauschbar. Mit SQLite läuft
Lunr im Arbeitsspeicher des Backends, mit PostgreSQL
das Modul
search-backend-module-pg. - Eine API-Entity trägt ihre Definition in
spec.definition– inline oder per$textaus einer Datei im Repo.spec.typeentscheidet über die Darstellung. - Vorausgesetzt: Stand Ende Tag 7, also Portal mit Gitea-Provider,
Organisation aus
kranich/orgund gebaute TechDocs fürsendungs-api.
 Katalog ──► Kollator software-catalog ─┐  Zeitplan      GET /api/search/query
                                        ├─► (Standard ─► Lunr (RAM) ─► Search-Seite,
 TechDocs ─► Kollator techdocs ─────────┘   10 min)      oder Postgres  Modal, bs
Drill 1: Welche Suchmaschine läuft?
create-app trägt in packages/backend/src/index.ts schon
alles ein: das Such-Backend, die Postgres-Engine und zwei Kollatoren.
Welche Engine wirklich arbeitet, verrät das Log:
source ~/backstage-lab/setup/env.sh
grep -n 'search' $PORTAL/packages/backend/src/index.ts | grep backend.add
sed 's/\x1b\[[0-9;]*m//g' $LAB/portal.log | grep 'search warn Postgres' | cut -c26-100
sed 's/\x1b\[[0-9;]*m//g' $LAB/portal.log \
  | grep -oE 'task: search_index_[a-z_]+.*"cadence":"[^"]+"' \
  | sed -E 's/task: ([a-z_]+).*"cadence":"([^"]+)"/\1 \2/'
Erwartet:
50:backend.add(import('@backstage/plugin-search-backend'));
54:backend.add(import('@backstage/plugin-search-backend-module-pg'));
57:backend.add(import('@backstage/plugin-search-backend-module-catalog'));
58:backend.add(import('@backstage/plugin-search-backend-module-techdocs'));
search warn Postgres search engine is not supported, skipping registration
search_index_software_catalog PT10M
search_index_techdocs PT10M
Warum? Das pg-Modul prüft beim Start die Datenbank. Bei SQLite meldet
es sich ab, und search-backend nimmt mangels registrierter
Engine den eingebauten LunrSearchEngine (Quelltext:
plugin-search-backend/dist/plugin.cjs.js). Eine Log-Zeile
„Lunr” gibt es nicht – die Warnung ist das Indiz. PT10M
heißt: Beide Kollatoren bauen ihren Index alle zehn Minuten neu.
Tipp: Die Zeilennummern in
index.tsweichen ab, wenn du an den Vortagen mehr Module eingetragen hast. Wichtig sind die vier Zeilen.
Fortschritt speichern? Kostenlos registrieren
Drill 2: Suchmodal und Search-Seite
- Klicke in der Sidebar ganz oben auf Search. Es öffnet sich ein Modal.
- Tippe
sendung. Die Treffer erscheinen beim Tippen, ohne Enter. - Erwartet: das Modal wie in der Abbildung, mit hervorgehobenen Wortteilen.
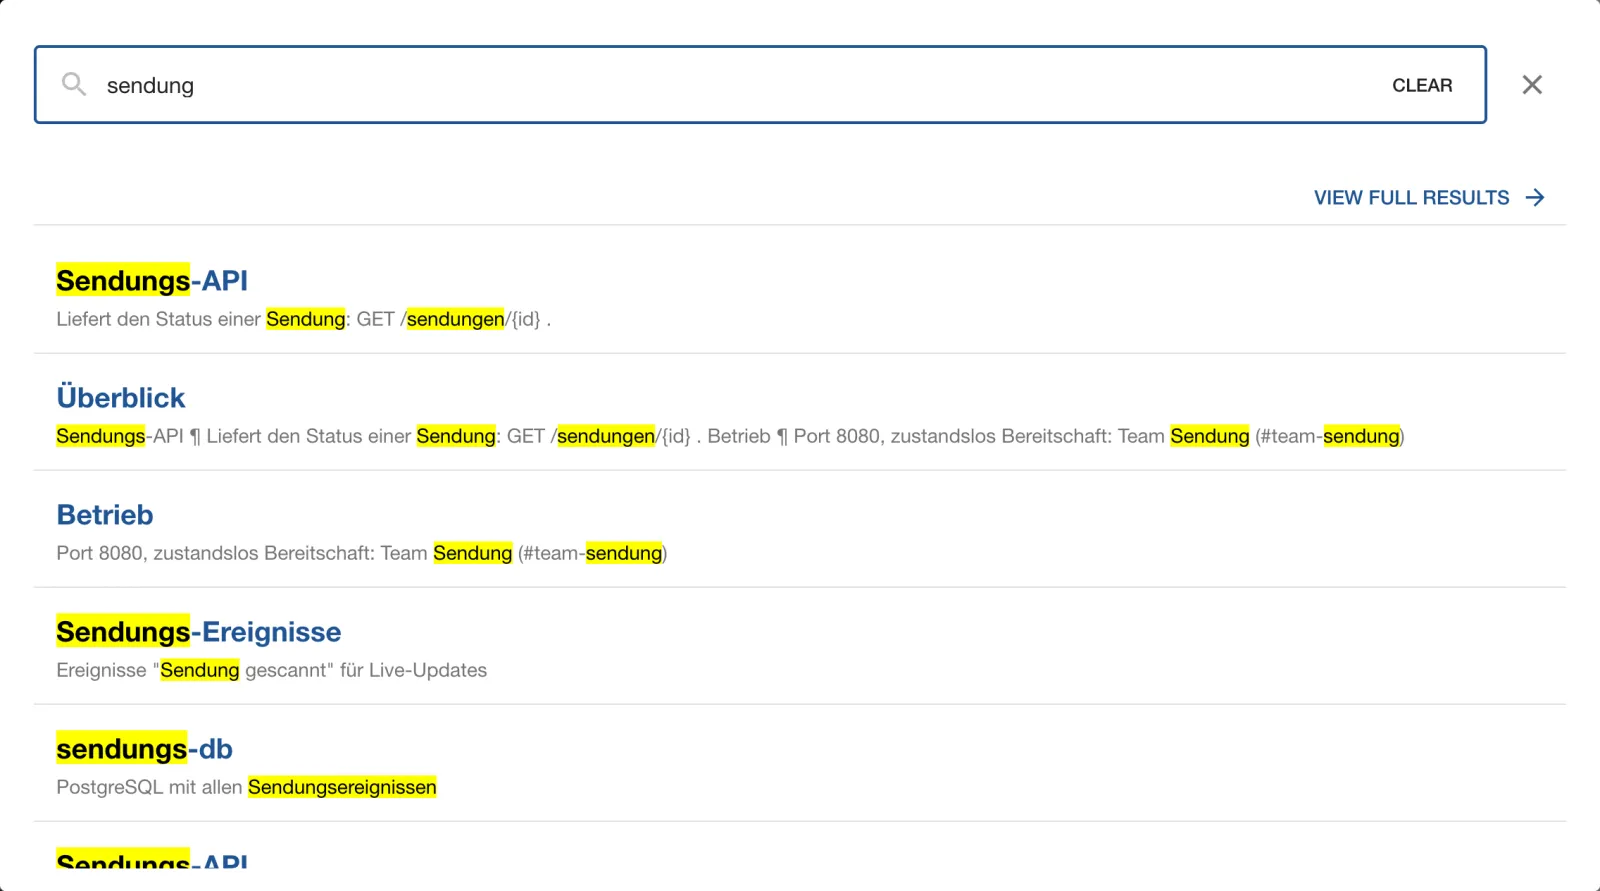
Ein Tastenkürzel zum Öffnen gibt es in dieser Version nicht.
SidebarSearchModal (eingebunden in
packages/app/src/modules/nav/Sidebar.tsx) reagiert nur auf
den Klick, Esc schließt das Modal.
- Klicke auf VIEW FULL RESULTS. Du landest auf
http://localhost:3000/search?query=sendung. - Erwartet: die Search-Seite wie in der Abbildung. Links Result Type mit Software Catalog und Documentation, darunter die Filter Kind und Lifecycle. Jeder Treffer zeigt Kind, Type, Lifecycle und Owner als Chips. Sind die TechDocs aus Tag 7 schon indexiert, mischen sich Treffer mit Dokument-Symbol darunter.
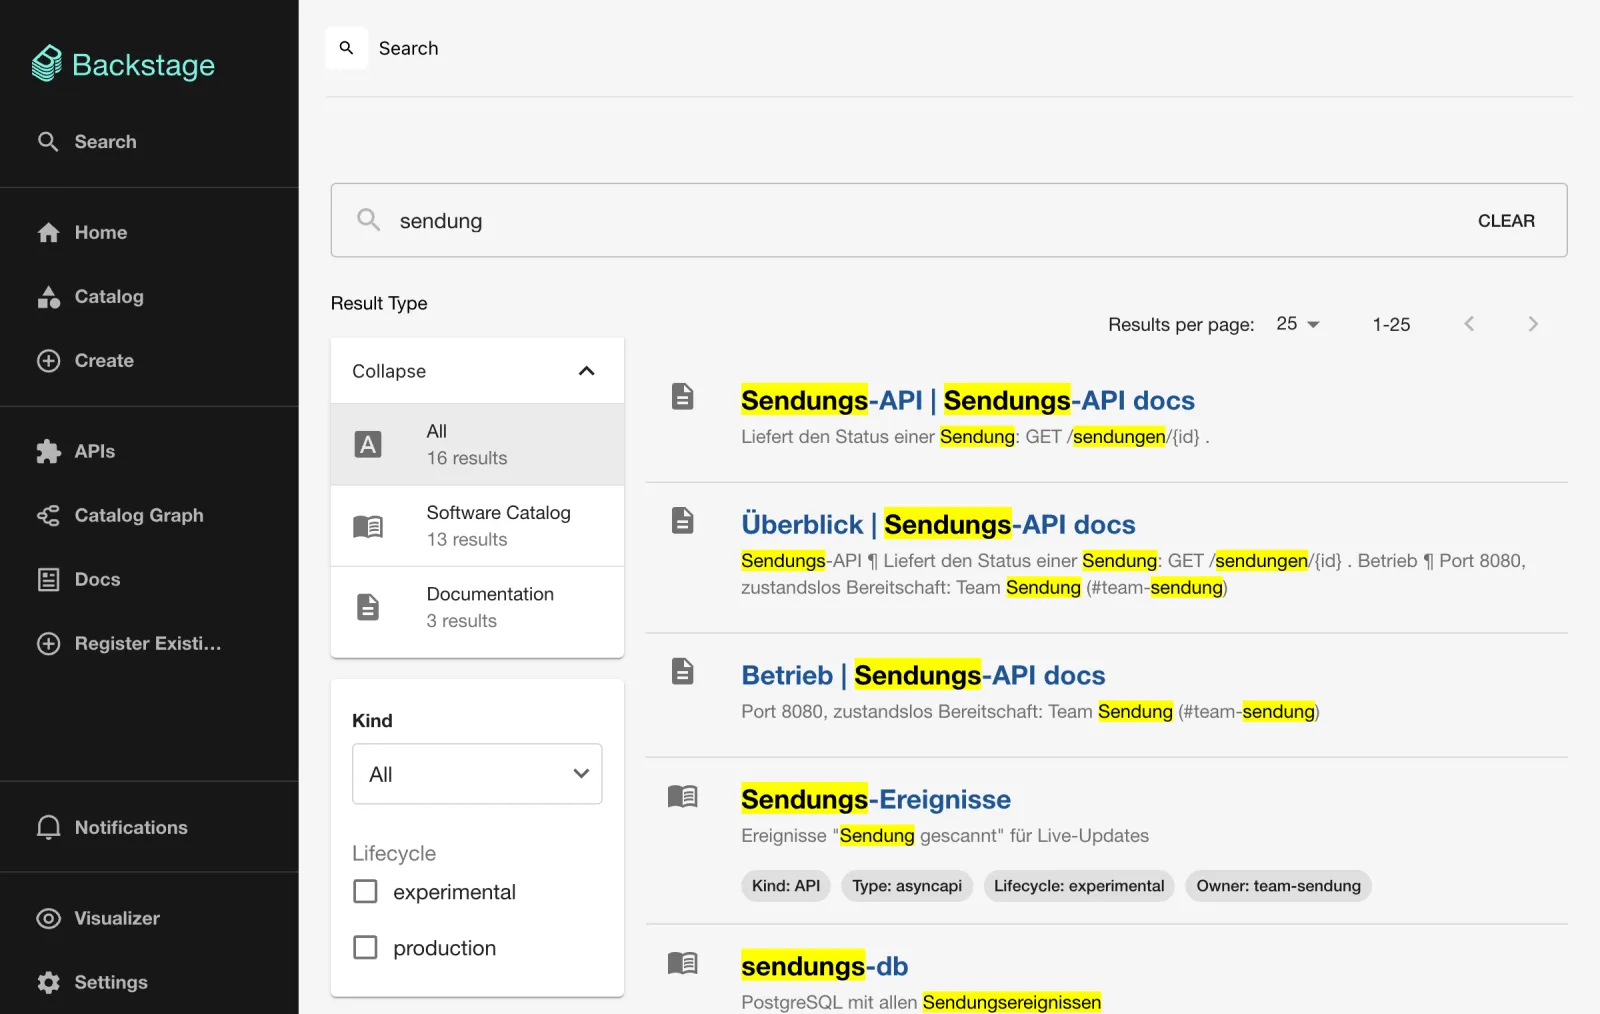
- Stelle Kind auf
API. Übrig bleibensendungs-apiund – weiter unten –example-grpc-api, obwohl es mit „sendung” nichts zu tun hat. Warum, zeigt Drill 3. - Setze Kind zurück auf All und hake
bei Lifecycle
experimentalan. Erwartet: obenSendungs-Workerundzustell-app, darunter wieder fremde Treffer wieexample-website.
Fortschritt speichern? Kostenlos registrieren
Drill 3: Die Such-API mit jq
Die Seite ruft GET /api/search/query auf. Dasselbe per
bs:
Q='search/query?term=sendung&types%5B0%5D=software-catalog'
bs "$Q" | jq '.numberOfResults'
bs "$Q" | jq '.results[0] | {type, document: (.document | {kind, title, location})}'
Erwartet (gekürzt):
11
{
  "type": "software-catalog",
  "document": {
    "kind": "Resource",
    "title": "sendungs-db",
    "location": "/catalog/default/resource/sendungs-db"
  }
}
types[0]=software-catalog blendet die TechDocs-Treffer
aus Tag 7 aus. Jeder Treffer hat type (der Kollator),
document (die indexierten Felder: title,
text aus der Beschreibung, kind,
type, lifecycle, owner,
location), rank und highlight.
Filter und Typ hängst du als Query-Parameter an, eckige Klammern
URL-kodiert:
bs 'search/query?term=sendung&types%5B0%5D=software-catalog&filters%5Bkind%5D=API' \
  | jq -r '.results[] | "\(.document.title) (\(.document.type))"'
bs 'search/query?term=zustelung' | jq -r '.results[].document.title'
Erwartet:
sendungs-api (openapi)
example-grpc-api (grpc)
Logistik
Zwei Lunr-Eigenheiten: Sobald ein Filter gesetzt ist, wird der
Suchbegriff optional und nur noch zum Sortieren genutzt – deshalb taucht
example-grpc-api auf. Und Lunr sucht unscharf (bis zu zwei
Tippfehler, editDistance: 2 im Quelltext von
LunrSearchEngine), daher findet zustelung die
Domain mit „Zustellung” in der Beschreibung.
Fortschritt speichern? Kostenlos registrieren
Drill 4: Eine neue API und die Index-Lücke
Die AsyncAPI sendungs-ereignisse aus der Challenge von
Tag 2 bekommt jetzt eine richtige Definitionsdatei im Repo
kranich/sendungsverfolgung. Die fertigen Dateien liegen im
Begleitcode: asyncapi.yaml und eine
catalog-info.yaml, in der der Worker
providesApis: [sendungs-ereignisse] trägt und die API ihre
Definition per $text: ./asyncapi.yaml lädt.
mkdir -p ~/backstage-lab/tag08 && cd ~/backstage-lab/tag08
git clone -q \
  http://lab-admin:[email protected]:3300/kranich/sendungsverfolgung.git
cp ~/backstage-lab/code/tag08/sendungsverfolgung/* sendungsverfolgung/
git -C sendungsverfolgung add -A
git -C sendungsverfolgung -c user.name="Lab Admin" -c [email protected] \
  commit -qm "AsyncAPI Sendungs-Ereignisse"
git -C sendungsverfolgung push -q origin main
sleep 60
bs catalog/entities/by-name/api/default/sendungs-ereignisse \
  | jq -r '.spec.type, .spec.definition' | head -3
bs 'search/query?term=ereignisse' \
  | jq -r '.results[] | "\(.document.kind) \(.document.title)"'
Erwartet:
asyncapi
asyncapi: 3.0.0
info:
Component Sendungs-Worker
Der Katalog kennt die API nach weniger als einer Minute (Provider und
processingInterval aus Tag 3), die Suche nicht. Sie wartet
auf den nächsten Kollator-Lauf – bis zu zehn Minuten. Hast du die
Tag-2-Challenge gelöst, findet die Suche die alte Inline-Version; der
neue Titel Sendungs-Ereignisse fehlt trotzdem.
Den Zeitplan liest das Katalog-Modul aus
search.collators.catalog.schedule, das TechDocs-Modul aus
search.collators.techdocs.schedule (beide in
config.schema.json der Module).
app-config.yaml hat noch keinen Key
search:
cd ~/backstage-lab/portal
grep -c '^search:' app-config.yaml app-config.local.yaml
cat >> app-config.local.yaml <<'EOF'
search:
  collators:
    catalog:
      schedule:
        frequency: { minutes: 1 }
        timeout: { minutes: 5 }
    techdocs:
      schedule:
        frequency: { minutes: 1 }
        timeout: { minutes: 5 }
EOF
~/backstage-lab/setup/portal.sh restart
curl -s -H "Authorization: Bearer $BACKSTAGE_TOKEN" \
  "$BACKSTAGE/api/search/query?term=ereignisse" | jq -r .error.name
Erwartet:
app-config.yaml:0
app-config.local.yaml:0
✔ gestoppt
✔ Backstage läuft: http://localhost:3000 (Backend http://localhost:7007)
MissingIndexError
Lunr hält den Index nur im RAM. Nach jedem Neustart ist er leer, bis die Kollatoren einmal gelaufen sind; so lange antwortet die Such-API mit HTTP 500 und die Search-Seite bleibt leer. Nach etwa 30 Sekunden:
sleep 30
sed 's/\x1b\[[0-9;]*m//g' $LAB/portal.log \
  | grep -oE 'task: search_index_[a-z_]+.*"cadence":"[^"]+"' \
  | sed -E 's/task: ([a-z_]+).*"cadence":"([^"]+)"/\1 \2/'
bs 'search/query?term=ereignisse' \
  | jq -r '.results[] | "\(.document.kind) \(.document.title)"'
Erwartet:
search_index_software_catalog PT1M
search_index_techdocs PT1M
API Sendungs-Ereignisse
Component Sendungs-Worker
Achtung: Ein Index-Neubau pro Minute ist fürs Lab gedacht. Bei Tausenden Entities und vielen Docs-Seiten belastet jeder Lauf Katalog und Backend; in Produktion sind 10–60 Minuten üblich.
Fortschritt speichern? Kostenlos registrieren
Drill 5: TechDocs in der Suche
Der TechDocs-Kollator liest nicht die Markdown-Dateien, sondern die
search/search_index.json, die mkdocs beim Bauen erzeugt
(Tag 7). Er indexiert also nur Docs, die schon einmal gebaut und
abgelegt wurden.
bs techdocs/static/docs/default/component/sendungs-api/search/search_index.json \
  | jq '.docs | length'
bs 'search/query?term=bereitschaft' \
  | jq -r '.results[] | "\(.type) \(.document.title) \(.document.location)"'
Erwartet:
7
techdocs Betrieb /docs/default/component/sendungs-api/#betrieb
techdocs Start /docs/default/component/sendungs-api/betrieb/#start
techdocs Überblick /docs/default/component/sendungs-api/
techdocs Betrieb /docs/default/component/sendungs-api/betrieb/
Sieben Einträge im mkdocs-Index: jede Seite und jede Überschrift ist ein eigenes Dokument mit Sprungadresse.
Liefert der erste Befehl nichts, öffne einmal den Tab
TechDocs von sendungs-api und warte eine
Minute. Im GUI:
- Öffne die Search-Seite, suche
bereitschaftund klicke links auf Documentation. - Erwartet: vier Treffer aus beiden Seiten der Doku, dazu ein neuer Filter Entity – wie in der Abbildung.
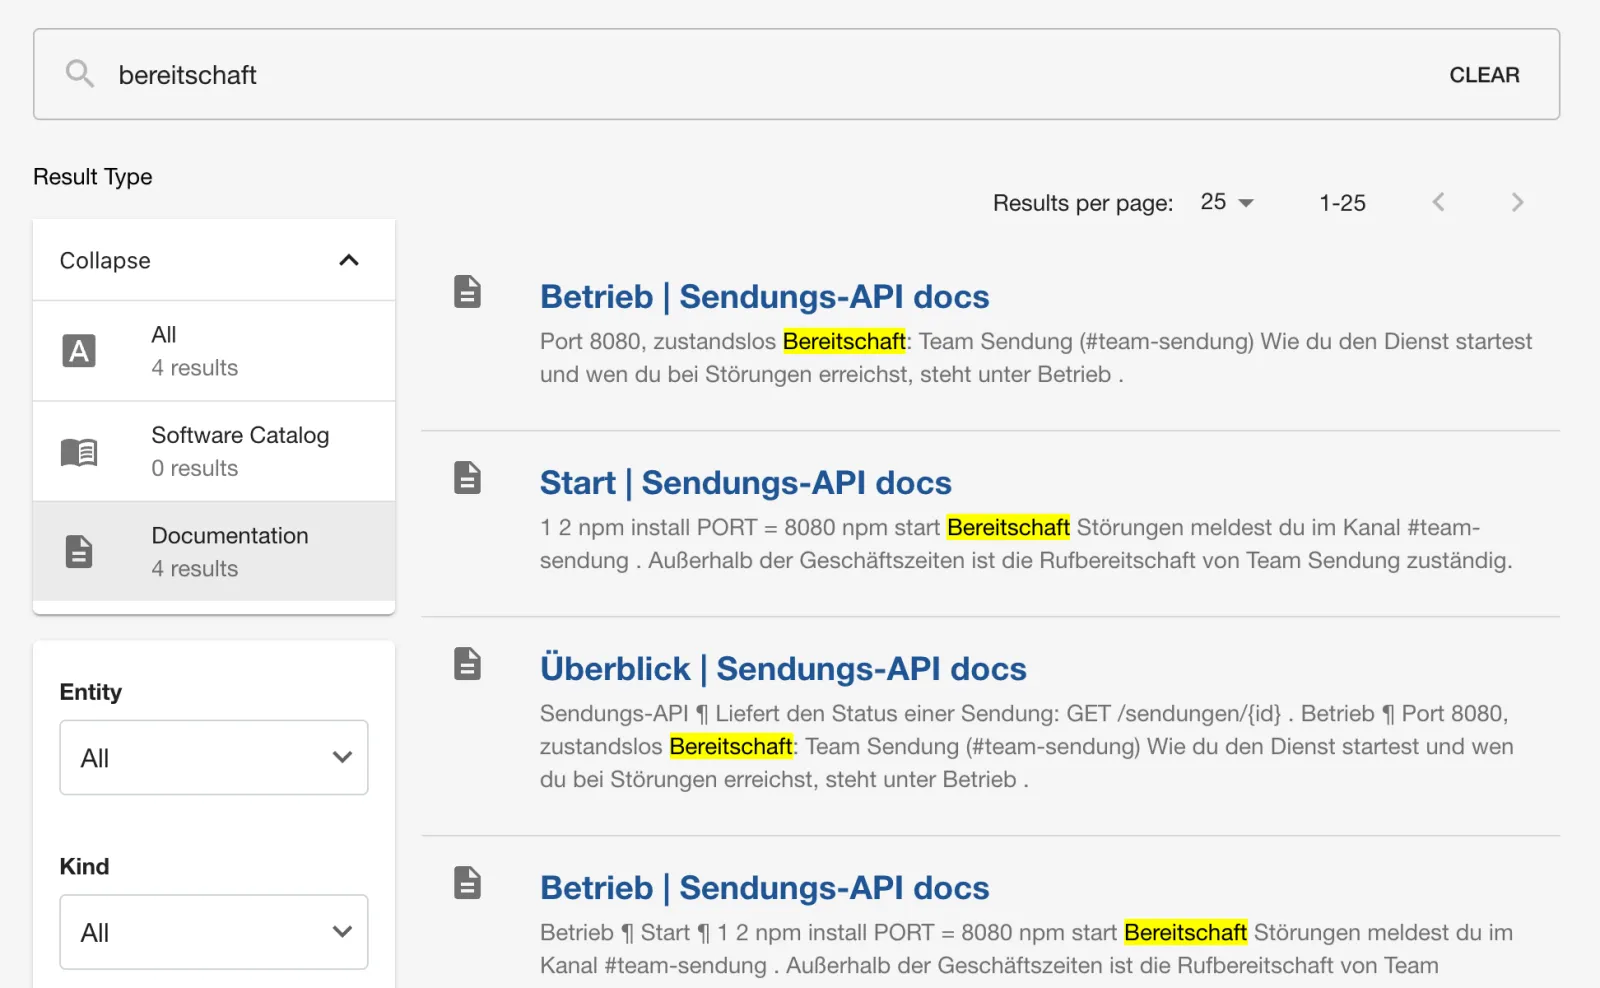
Ein Klick auf Start | Sendungs-API docs springt direkt zum Abschnitt im Dokument.
Fortschritt speichern? Kostenlos registrieren
Drill 6: Die APIs-Seite
- Klicke in der Sidebar auf APIs.
- Erwartet: der API Explorer mit allen API-Entities
und den Spalten TYPE und LIFECYCLE wie
in der Abbildung (sie zeigt schon
Sendungs-GraphQLaus Drill 8). Links filterst du nach Type, Owner, Lifecycle und Tags.
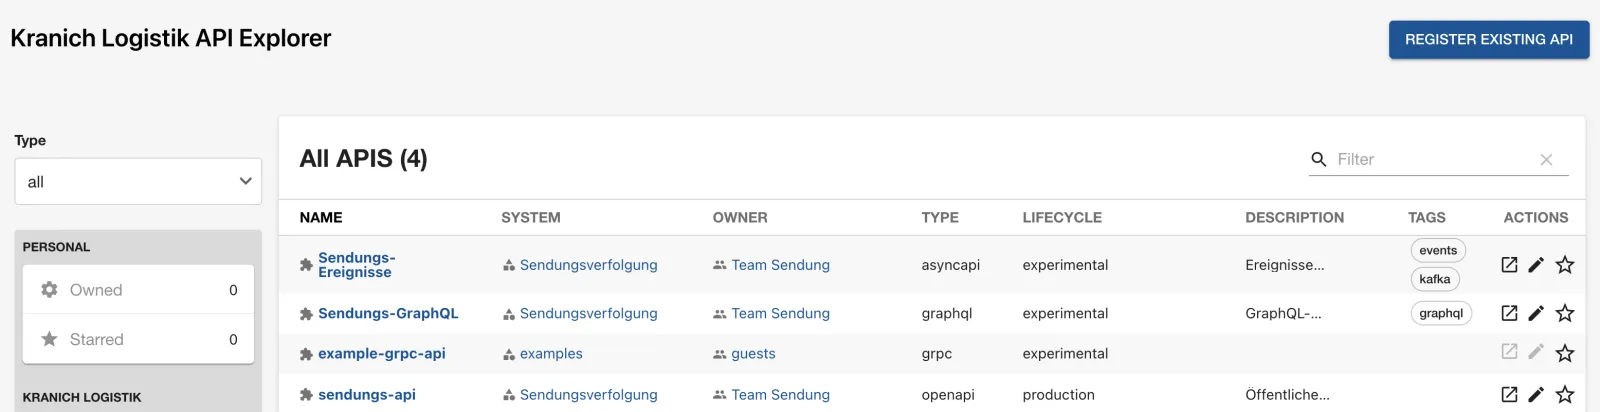
Dieselbe Liste per API:
bs 'catalog/entities?filter=kind=api&fields=metadata.name,spec.type,spec.lifecycle' \
  | jq -r '.[] | "\(.spec.type) \(.spec.lifecycle) \(.metadata.name)"' | sort
Erwartet (nach Drill 8 kommt graphql dazu):
asyncapi experimental sendungs-ereignisse
grpc experimental example-grpc-api
openapi production sendungs-api
Welche Typen eine eigene Ansicht bekommen, steht in
plugin-api-docs
(dist/components/ApiDefinitionCard/ApiDefinitionWidget.esm.js):
openapi, asyncapi, graphql,
grpc und trpc. Jeder andere
spec.type erscheint als reiner Text.
Fortschritt speichern? Kostenlos registrieren
Drill 7: OpenAPI, Consumers und Providers
- Klicke auf
sendungs-apiund bleibe auf Overview. - Scrolle unter die Definition. Erwartet: die Karten Consumers und Providers wie in der Abbildung.
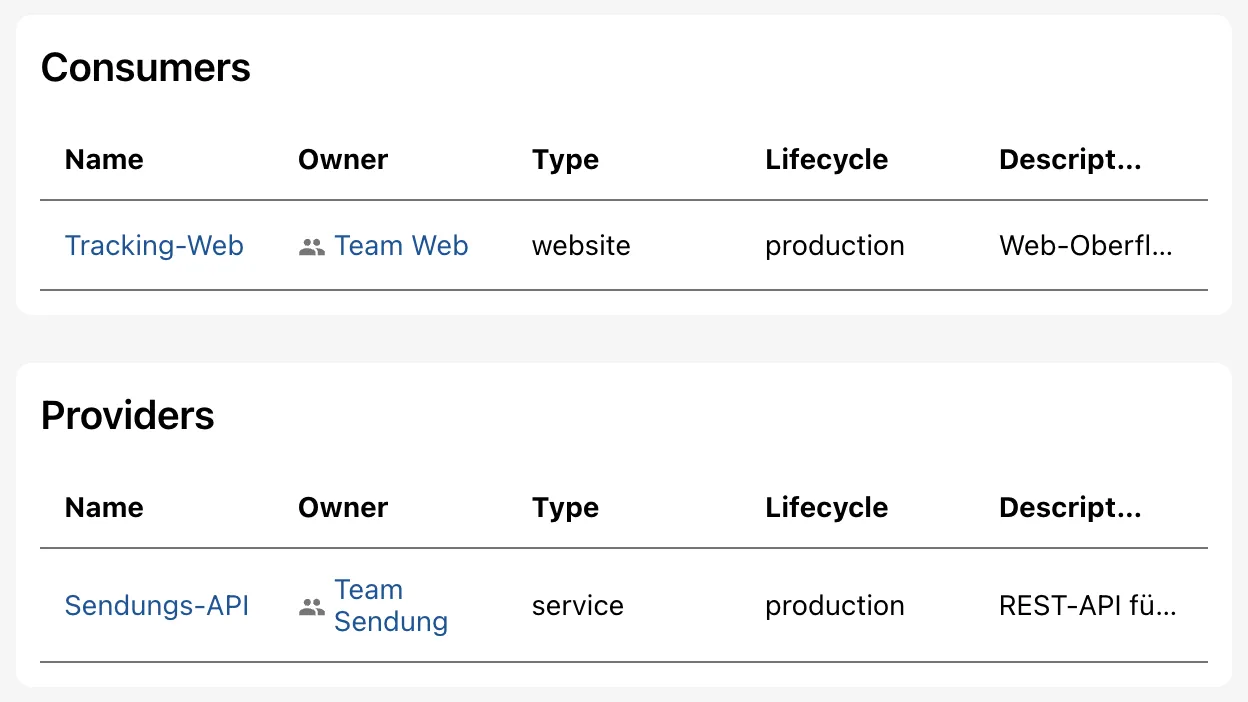
Die Karten lesen die Relationen apiConsumedBy und
apiProvidedBy, die der Katalog aus
consumesApis bei tracking-web und
providesApis bei der Component sendungs-api
ableitet. Die API selbst nennt weder Konsumenten noch Anbieter.
- Klicke in der Definition auf die Zeile GET /sendungen/{id}.
- Erwartet: Parameter
idmit BeispielwertKR-1001und die Antworten 200 und 404 wie in der Abbildung.
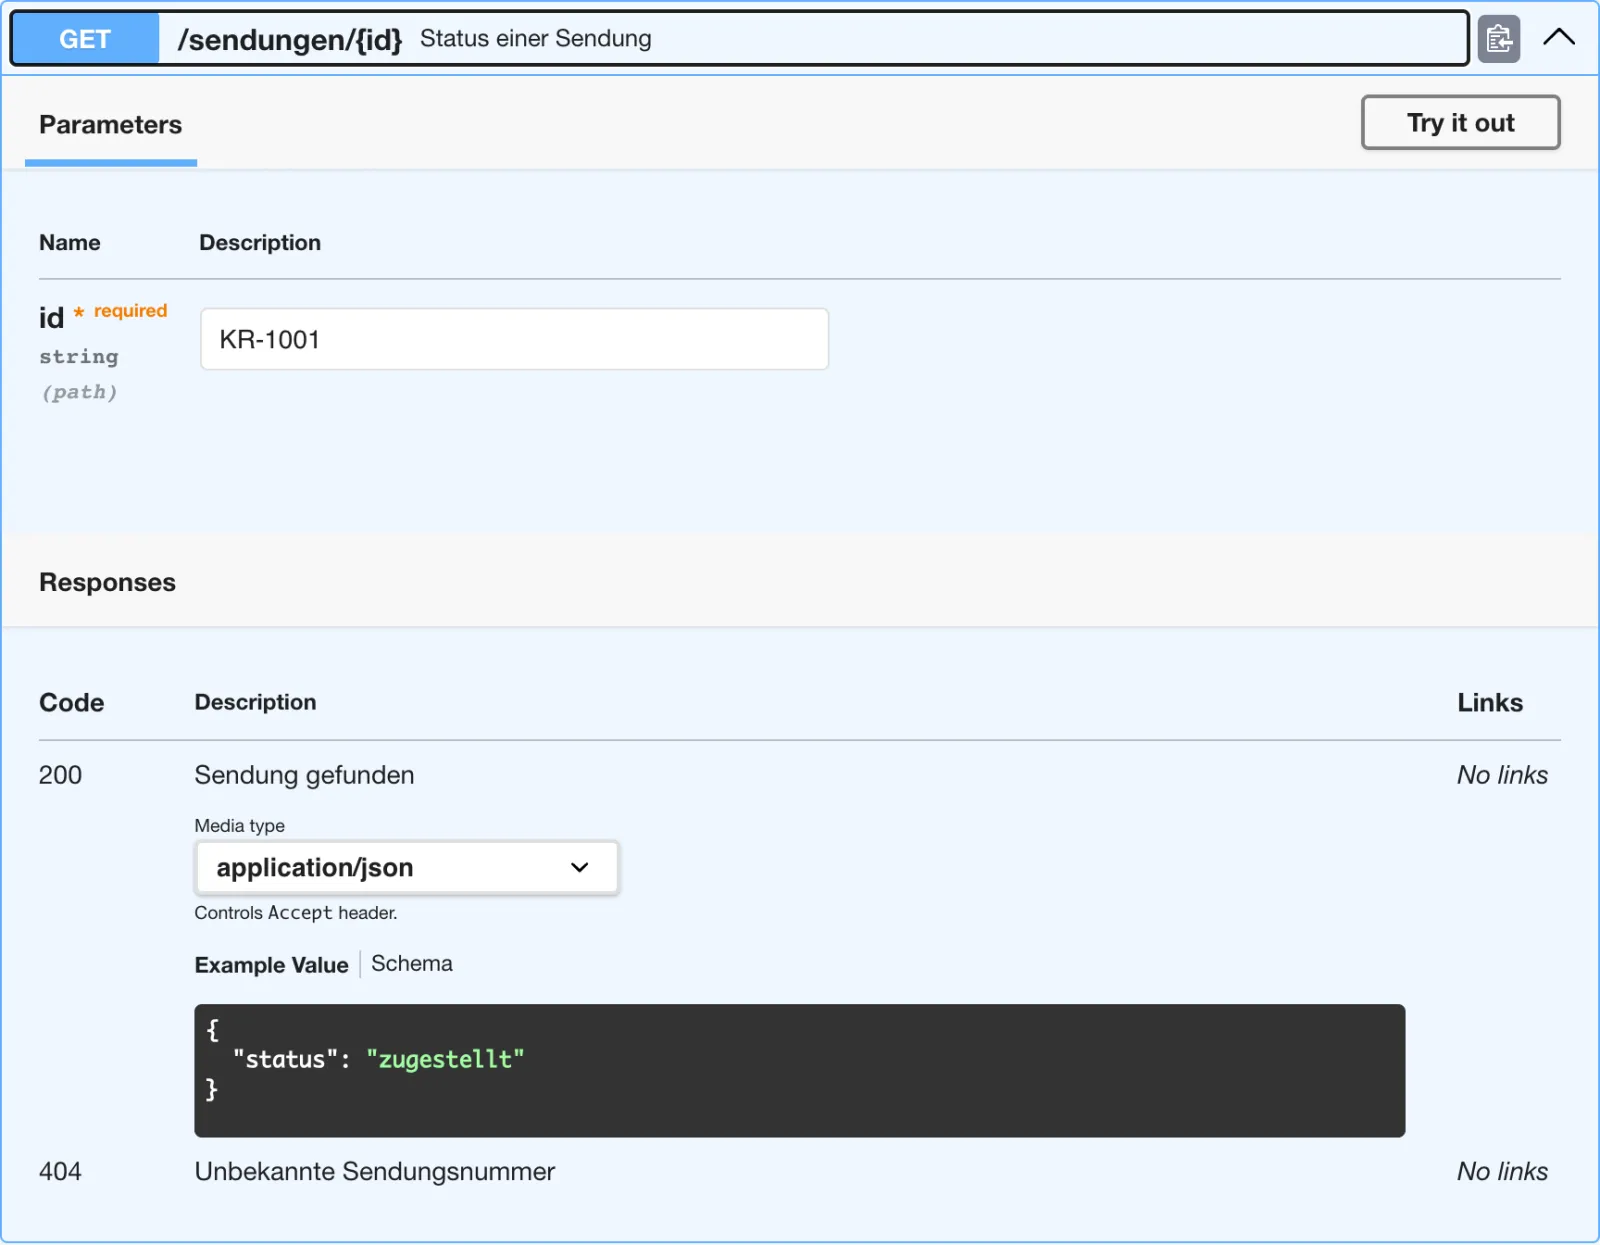
Try it out ist sichtbar, hilft hier aber nicht:
openapi.yaml hat keinen Abschnitt servers,
Swagger UI würde den Request an das Portal selbst schicken. Mit echten
servers-Einträgen fragt der Browser die API direkt an –
dann muss deren CORS-Konfiguration das Portal erlauben.
Fortschritt speichern? Kostenlos registrieren
Drill 8: AsyncAPI und GraphQL
- Öffne in APIs die Entity Sendungs-Ereignisse, Tab Documentation, Menüpunkt Definition.
- Klicke unter Operations auf Expand all.
- Erwartet: die Operation RECEIVE
sendungen.gescanntmit den Feldern der Nachricht wie in der Abbildung.
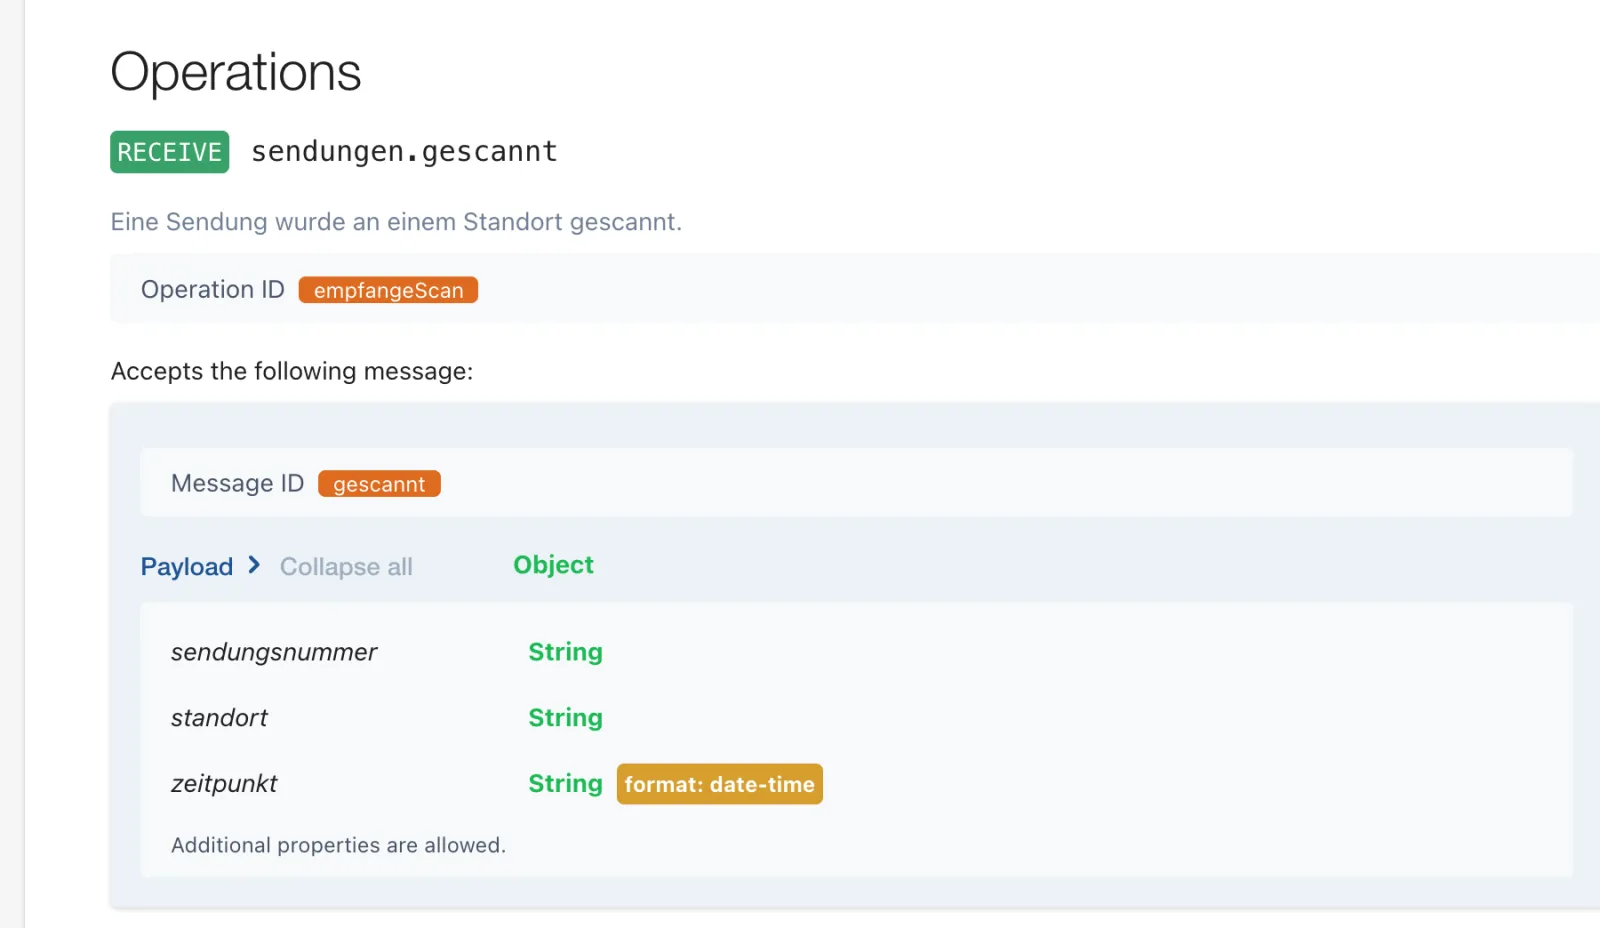
Jetzt eine GraphQL-API, deren Schema neben dem Code im Repo
kranich/sendungs-api liegt. Die API-Entity hängst du an die
vorhandene catalog-info.yaml an, yq (wie in
der Challenge von Tag 7) ergänzt providesApis bei der
Component und consumesApis bei tracking-web,
ohne den Rest der Dateien anzufassen:
cd ~/backstage-lab/tag08
G=http://lab-admin:[email protected]:3300/kranich
T=~/backstage-lab/code/tag08
git clone -q $G/sendungs-api.git && git clone -q $G/tracking-web.git
cp $T/sendungs-api/schema.graphql sendungs-api/
cat $T/sendungs-api/api-graphql.yaml >> sendungs-api/catalog-info.yaml
yq -i 'select(.kind == "Component").spec.providesApis += ["sendungs-graphql"]' \
  sendungs-api/catalog-info.yaml
yq -i '.spec.consumesApis += ["sendungs-ereignisse", "sendungs-graphql"] |
  .spec.consumesApis |= unique' tracking-web/catalog-info.yaml
git -C tracking-web diff | grep '^[-+] '
for r in sendungs-api tracking-web; do
  git -C $r add -A
  git -C $r -c user.name="Lab Admin" -c [email protected] \
    commit -qm "GraphQL-API" && git -C $r push -q origin main
done
sleep 75
bs 'search/query?term=graphql' \
  | jq -r '.results[] | "\(.document.kind) \(.document.title) \(.document.type)"'
Erwartet (ohne die Tag-7-Challenge zeigt der Diff zusätzlich
dependsOn, das yq beim ersten Schreiben in
Anführungszeichen setzt):
-  consumesApis: [sendungs-api]
+  consumesApis: [sendungs-api, sendungs-ereignisse, sendungs-graphql]
API Sendungs-GraphQL graphql
unique verhindert Doppelungen, falls
sendungs-ereignisse aus der Tag-2-Challenge schon
eingetragen ist. Die Annotation backstage.io/techdocs-ref
aus der Tag-7-Challenge bleibt erhalten.
Diesmal ohne Neustart: Der Kollator läuft jetzt jede Minute.
- Öffne Sendungs-GraphQL → Documentation → Definition und klicke unter Root Types auf Query.
- Erwartet: die Felder der Query mit Argumenten und Beschreibungen aus dem Schema wie in der Abbildung.
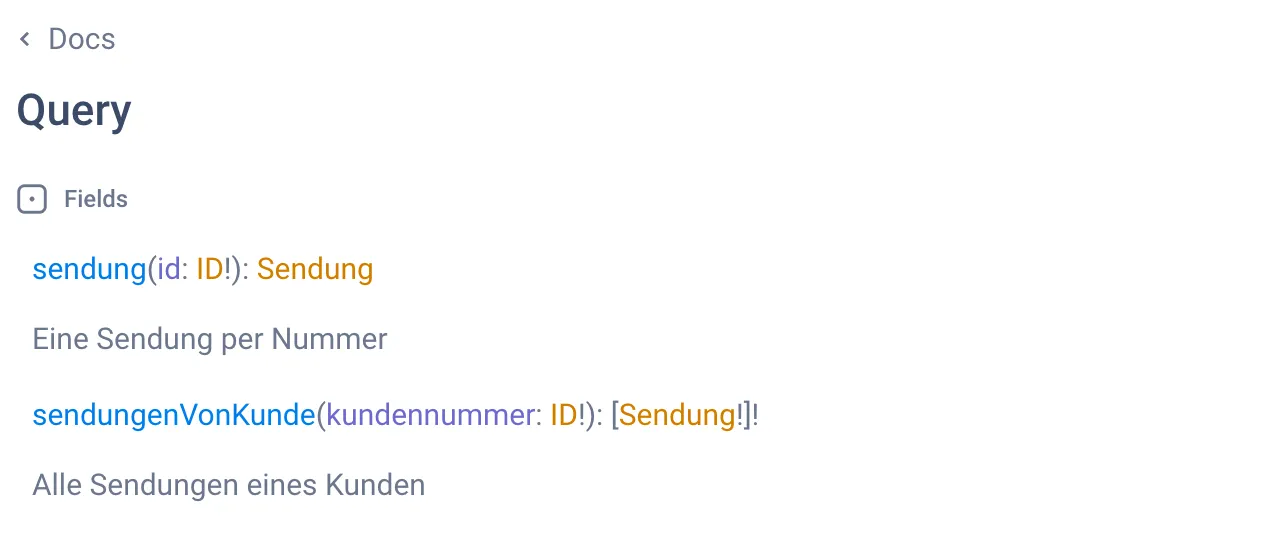
Backstage zeigt nur den Doc Explorer von GraphiQL; Queries ausführen lassen sich hier nicht. Das Suchfeld mit ⌘ K gehört zu GraphiQL und durchsucht nur das Schema.
$text oder inline? $text hält die
Definition dort, wo sie gepflegt und getestet wird, und der Katalog
liest sie bei jedem Processing neu. Inline (Tag 2) taugt nur für
Skizzen. Für große Specs mit $ref auf weitere Dateien
bringt das Zusatzmodul
@backstage/plugin-catalog-backend-module-openapi (im Lab
nicht installiert) die Platzhalter $openapi und
$asyncapi, die die Verweise beim Einlesen auflösen.
Fortschritt speichern? Kostenlos registrieren
Kontrollpunkt
Die Datei liegt auch unter
~/backstage-lab/code/tag08/kontrolle.sh.
cat > ~/backstage-lab/tag08/kontrolle.sh <<'EOF'
#!/usr/bin/env bash
# kontrolle.sh – Kontrollpunkt Tag 8 (✔/✘). Exit-Code = Anzahl Fehler.
source ~/backstage-lab/setup/env.sh
fail=0
t() { if eval "$2" >/dev/null 2>&1; then echo "✔ $1"
  else echo "✘ $1"; fail=$((fail+1)); fi; }
q() { bs "search/query?term=$1"; }

t "Suche liefert die API sendungs-api" \
  "q sendung | jq -e '.results[] | select(.type==\"software-catalog\"
     and .document.kind==\"API\" and .document.title==\"sendungs-api\")'"
t "Suche liefert TechDocs-Treffer" \
  "q bereitschaft | jq -e '.results[] | select(.type==\"techdocs\")'"
t "Katalog-Kollator läuft jede Minute" \
  "grep -q 'search_index_software_catalog.*PT1M' $LAB/portal.log"
for typ in openapi asyncapi graphql; do
  t "API vom Typ $typ im Katalog" \
    "bs 'catalog/entities?filter=kind=api,spec.type=$typ' | jq -e 'length > 0'"
done
t "sendungs-ereignisse: Definition aus Datei geladen" \
  "bs catalog/entities/by-name/api/default/sendungs-ereignisse |
     jq -e '.spec.definition | startswith(\"asyncapi: 3.0.0\")'"
t "tracking-web konsumiert sendungs-graphql" \
  "bs catalog/entities/by-name/api/default/sendungs-graphql | jq -e '.relations[] |
     select(.type==\"apiConsumedBy\" and
       .targetRef==\"component:default/tracking-web\")'"
exit "$fail"
EOF
bash ~/backstage-lab/tag08/kontrolle.sh
Erwartet:
✔ Suche liefert die API sendungs-api
✔ Suche liefert TechDocs-Treffer
✔ Katalog-Kollator läuft jede Minute
✔ API vom Typ openapi im Katalog
✔ API vom Typ asyncapi im Katalog
✔ API vom Typ graphql im Katalog
✔ sendungs-ereignisse: Definition aus Datei geladen
✔ tracking-web konsumiert sendungs-graphql
Challenge
Die Zustell-App meldet Haustür-Scans über einen gRPC-Dienst. Lege im
Repo kranich/zustell-app die API scan-annahme
(Typ grpc) mit der Definition in
proto/scan.proto an, mache zustell-app zum
Konsumenten und finde die API über die Suche mit scan.
Hinweis: $text löst Pfade relativ zur
catalog-info.yaml auf, auch in Unterverzeichnissen.
Lösung
cd ~/backstage-lab/tag08
git clone -q http://lab-admin:[email protected]:3300/kranich/zustell-app.git
cp -R ~/backstage-lab/code/tag08/challenge/zustell-app/. zustell-app/
git -C zustell-app add -A
git -C zustell-app -c user.name="Lab Admin" -c [email protected] \
  commit -qm "gRPC-API scan-annahme" && git -C zustell-app push -q origin main
sleep 75
bs 'search/query?term=scan' \
  | jq -r '.results[0:2][] | "\(.document.kind) \(.document.title)"'
bs catalog/entities/by-name/api/default/scan-annahme \
  | jq -r '(.spec.definition | split("\n")[0]),
           (.relations[] | "\(.type) -> \(.targetRef)")'
Erwartet:
API Scan-Annahme
Component zustell-app
syntax = "proto3";
apiConsumedBy -> component:default/zustell-app
ownedBy -> group:default/team-sendung
partOf -> system:default/sendungsverfolgung
Unter Definition zeigt Backstage die Proto-Datei als
hervorgehobenen Quelltext – eine interaktive gRPC-Ansicht gibt es nicht.
Die Suche liefert weitere Treffer wie Sendungs-Worker
(„Scanner-Ereignisse”), weil Lunr Präfixe und Tippfehler mitsucht.
Fortschritt speichern? Kostenlos registrieren
Enterprise-Notiz
- Lunr im RAM ist nur fürs Lab: Jeder Backend-Neustart leert den
Index, mehrere Backend-Replikas hätten je einen eigenen. Mit PostgreSQL
(Tag 13) übernimmt das schon eingetragene
search-backend-module-pgohne weitere Konfiguration; große Installationen nutzen Elasticsearch oder OpenSearch (search-backend-module-elasticsearch). - Der Kollator-Zeitplan ist ein Kompromiss aus Aktualität und Last – bei Postgres und Elasticsearch landet jeder Lauf als vollständiger Neuaufbau in der Datenbank.
- Mit
permission.enabledfiltert die Suche Treffer nach den Leserechten des Nutzers; ohne Permissions sieht jeder alles, was indexiert ist. - API-Definitionen gehören neben den Code und in die CI: Lint
(Spectral), Breaking- Change-Check gegen
main, erst dann Merge – der Katalog zeigt nur, was im Repo steht. - „Try it out” gegen Produktions-APIs ist heikel (echte Requests mit
dem Token des Nutzers). Üblich:
serversauf eine Sandbox zeigen lassen oder Swagger-Requests überproxy.endpointsleiten.